让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西
让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西组里有不少“历史脚本”:某个同事几年前用 Python 写的数据清洗、对账、报表生成,跑在一台机器的定时任务里,没人敢动 最近要把其中几个并进 Java 服务,统一部署、统一监控 这种活交给 AI 再合适不过了:输入输出都明确,代码量不大,几百行 Python,它几分钟就能吐出一份结构工整的 Java 第一份迁移我差点直接合进去 代码能编译,单测能过,命名比原脚本还讲究 后来是跑了一遍真实数据对比,才发现有几十行结果和老脚本对不上 查下来,没有一处是“写错了”,全是两门语言默认行为不一样,AI 按字面翻译了语法,却没翻译语义 这篇整理一下我踩到的这些差异,以及现在怎么让 AI 做迁移才比较放心
2026-10-16鱼鱼
并发之AQS全解析
并发之AQS全解析我们知道juc(java.util.concurrent)包下有很多实用的类,提供了很多并发工具,例如线程池、原子类、并发工具、信号量工具、锁等,可以说基本实现都为悲观锁,底层原理基本都使用了AQS(AbstractQueuedSynchronizer),AQS不是一种概念,是并发中实打实的工具类 本篇文章针对AQS做解析 AQS是多线程访问共享资源的同步器框架 AQS的资源可以是独占的也可以是共享的 我们先来简单看一下它的使用方式和ApI(因为是抽象类,是不能直接使用的),下图是AQS的整体脉络 AQS核心就是一个状态值state,同时维护了一个线程的阻塞队列,队列的节点为有两种状态:SHARED(共享)和EXCLUSIVE(独占),节点状态有五种:
![并发之AQS全解析]()
2021-03-12鱼鱼
让 AI 解释陌生代码:我怎么听出它在「圆场」
让 AI 解释陌生代码:我怎么听出它在「圆场」接手陌生模块时,我常会把一段代码丢给 AI,问:「这是在干什么?」它几乎总能讲出一套流畅的故事 问题是——流畅不等于正确,更不等于它真读懂了约束 我越来越在意一种说话方式:它在「圆场」 表面在解释,实际在把不确定的地方用顺滑的因果糊过去 这篇文章记我怎么听、怎么追问、什么时候该停 写给同样会在「哇它好懂」和「等等它是不是编的」之间来回横跳的人 我遇到过的圆场,大概有几类: 因果补全:代码里没写为什么,它给你编一个听起来合理的「因为……所以……」 命名联想:函数叫 refreshCache,它就按「刷新缓存」的教科书含义讲,不管仓库里这个词早就变味 忽略例外路径:主路径讲得很漂亮,catch、降级、兼容分支一笔带过
2026-10-15鱼鱼
多轮对话里的「目标漂移」:Agent 跑着跑着忘了你要什么
多轮对话里的「目标漂移」:Agent 跑着跑着忘了你要什么和 Agent 多轮协作久了,会遇到一种安静的失败:它一直很忙,工具也在调,中间步骤看起来都“合理”,可收工时你发现——干的已经不是你起初要的那件事 我把这叫目标漂移(goal drift) 不是偶发幻觉那么简单,更像是上下文变长后,约束被一步步冲淡 这篇文章记我怎么发现漂移、怎么在过程中拉回,以及设计 Agent 时能做哪些防漂 常见几种面孔: 每一步单独看都有道理:重构有益、修复积极、干净也好 合起来却违背委托 危险在于局部合理、全局偏航 图:目标漂移四种脸:膨胀、替换、偷换、遗忘(原创示意图) 我的个人理解(含推测): 所以漂移不完全是“模型不听话”,也是交互方式与系统设计的结果
2026-10-14鱼鱼
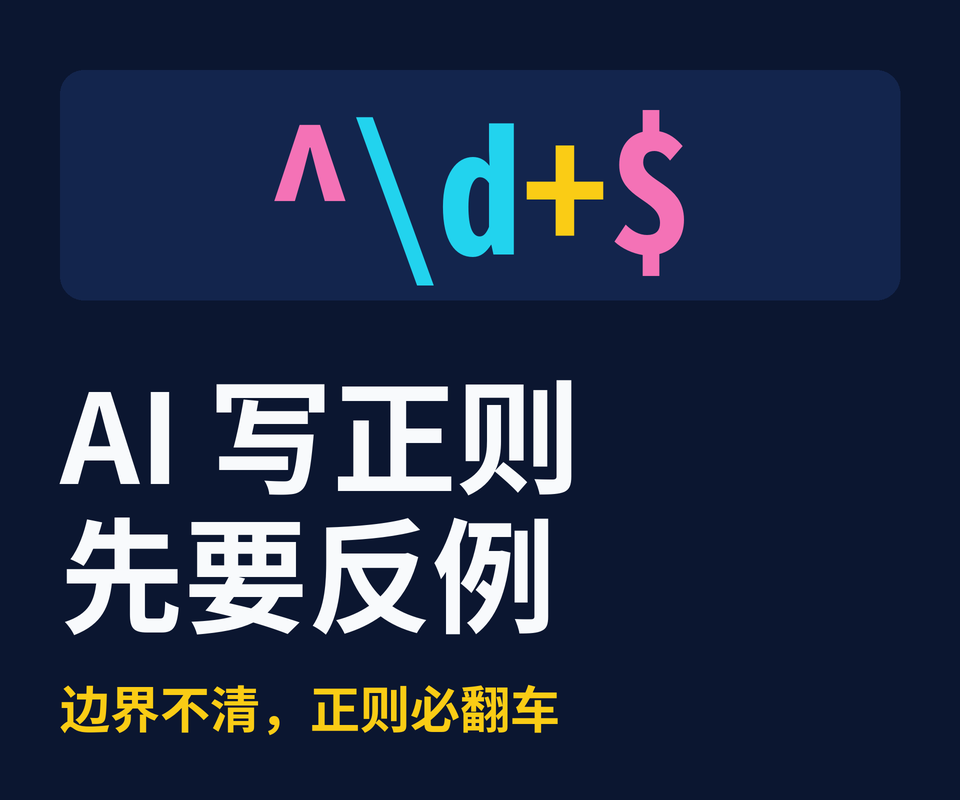
让 AI 写正则表达式:我现在一定先要它给反例
让 AI 写正则表达式:我现在一定先要它给反例正则大概是我最早放心交给 AI 的活 原因很简单:我自己写正则也是边查边试,每次写完都不太敢相信它 AI 张口就来,还附带逐段解释,看上去比我靠谱多了 用了一阵之后我发现,AI 写的正则有个很稳定的特点:它几乎总能匹配上你给的例子 问题是,正则真正出事的地方从来不在“该匹配的没匹配上”,而在“不该匹配的也匹配上了” 而后者,你不主动问,它不会告诉你 所以我现在有个死规矩:让 AI 写正则,先别要正则,先要反例 那次是要从一堆构建日志里提取版本号,格式是“主版本.次版本.修订号” 我给了 AI 三个例子,它很快给出 \d+\.\d+\.\d+,解释也清清楚楚 我跑了一下,三个例子全中,就提交了
2026-10-16鱼鱼
扫盲——加密那些事
扫盲——加密那些事扫盲加密解密算法 日常开发中我们经常接触MD5算法,以此进行简单的文件完整性校验或者是后台密码验证,MD5是最常见也是最简单快捷的散列算法,常用于参数或文件完整性校验,譬如网络请求发起方与接收方分别对参数做MD5编码,一旦不一致便判断请求被篡改从而拒绝该请求,从而保证信息安全,编码后的字符串是编码前文本的一个简要梗概,因此它也被称作是信息摘要算法 这个算法的特点就是不可逆,只用于信息准确性和防篡改的校验,当然,MD5作为老牌的散列算法,很多经典的编码已经可以被反向解码出来(依靠正向的暴力穷举)以及被碰撞模仿(王小云院士团队的"破解"能够根据MD5编码后串码模拟原始消息,即使它可能与原信息不同),类似的还有SHA1,因此衍生了SHA224、SHA256、SHA512等更多安全的散列算法
2021-05-14鱼鱼
Agent 的工具返回太长怎么办:截断、分页与摘要的取舍
Agent 的工具返回太长怎么办:截断、分页与摘要的取舍自己写 Agent 的时候,我最早关心的是工具怎么定义、参数怎么描述、调用失败怎么处理 工具返回什么,反而想得很少:命令跑完了,stdout 拿回来,原样塞进上下文,不就行了? 后来有一次让 Agent 排查一个线上问题,它调了一下读日志的工具 那个日志文件几十兆,工具老老实实全读回来了 结果要么是请求直接超出上下文上限报错,要么是在我加了粗暴截断之后,它看到前面几千行正常日志,得出结论“日志里没有发现异常” 真正的报错在文件末尾,它根本没看到 这件事让我意识到:工具返回多长、怎么变短,是 Agent 设计里一个独立的问题,而且没有银弹 常见的三种办法——截断、分页、摘要——各有各的代价
2026-10-16鱼鱼
kasper的算法(从0到1)
kasper的算法(从0到1)https://javaguide.cn/cs-basics/data-structure/linear-data-structure.html https://javaguide.cn/cs-basics/algorithms/linkedlist-algorithm-problems.html 项目地址:https://github.com/labuladong/fucking-algorithm 在线文档地址:https://labuladong.gitee.io/algo/home/ http://fishmaple.cn/blog/topicBlog?topicId=7
![kasper的算法(从0到1)]()
2023-10-23kasper
ES快速入门(2)——Tokenizer、Reindex
ES快速入门(2)——Tokenizer、Reindex本篇介绍es提供的几种分词分析器和常用的开源分词分析器 es默认的分词器,中规中矩的按照 Unicode Standard Annex #29分词,一般的小写符号会忽略,对于中文等字符会逐字分割,参数max_token_length表示最大的字符长度,再切分后会继续按此切分 譬如: 会分词为: 一个无视语义,按照字符尽量收集全索引的分词方式,会前后叠加的按符号位分词,参数: 会分词为: nGram的分词很全面,但如此夸张的方式用不好会导致索引doc过大,同时使查询效率偏低 分词规则很简单,无其余规则的按空格分词: 会分词为: 在standard的基础上能够有效拆分出邮箱和url地址的格式,同样有max_token_length这一参数:
![ES快速入门(2)——Tokenizer、Reindex]()
2020-09-05鱼鱼
把报错贴给 AI 之前,我先做的三件事
把报错贴给 AI 之前,我先做的三件事以前一看到红字堆栈,我的第一反应几乎是:全选、复制、粘贴进 AI 对话框,然后等它告诉我怎么改 说实话,这个习惯有一段时间挺好用 很多常见错误,它一眼就能看出来,比我自己翻文档快 可后来我发现,有一半以上“贴完还是修不好”的情况,并不是 AI 不行,而是我把一坨还没整理过的信息甩给了它 它只能在这坨信息上猜,猜错了也不奇怪 现在我会强迫自己先做三件小事,再决定要不要问、怎么问 这三件事加起来通常不超过五分钟,但后面少绕很多弯路 不是真的要自己把根因找出来,而是先回答两个很朴素的问题: 这条报错,我看得懂“是什么”吗?发生的位置,离我刚改的代码近吗? 很多堆栈很长,真正有用的往往就那么几行:异常类型、消息正文、以及“第一次进入我自己代码”的那一帧
2026-10-14鱼鱼
排坑指南-异步操作HttpServletRequest丢失Cookie
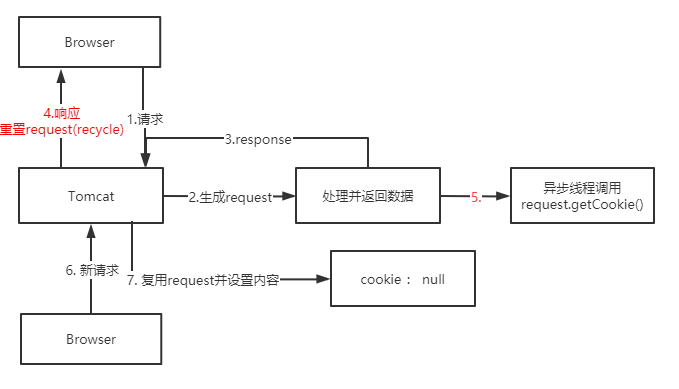
排坑指南-异步操作HttpServletRequest丢失Cookie遇到了一个很奇怪的bug:请求鉴权失败,因为通过Request对象获取到的Cookie中没有数据 经过debug调用request.getCookies()方法返回了null值,但是header属性的cookie却能拿到用户的有效cookie(request.getHeader("cookie")),其中缘由,且慢慢道来 我们可以在web项目中通过Request对象很方便的获取Cookie对象: 但其内部实现其实有一层缓存逻辑,从名为"cookie"的请求头中读取并处理数据转为Cookie对象并不是个省时事,在org.apache.catalina.connector.Request类中可以看到如下代码实现:
2020-11-11鱼鱼
AI 写的代码,我是这样 Review 的:一份不太体面的清单
AI 写的代码,我是这样 Review 的:一份不太体面的清单AI 生成的代码有一个很“坑人”的特点:它读起来太顺了 命名规整,注释齐全,结构对称,连日志格式都统一 人写的代码出问题,往往在外观上就有迹可循,比如命名乱、缩进歪、注释写着“TODO 先这样” AI 写的代码出问题,外表通常是光鲜的 这就导致一个很尴尬的局面:越是看起来没毛病的代码,我们越容易放松警惕 所以这篇想聊聊我自己 Review AI 代码时的一份清单 说它“不太体面”,是因为里面很多条看着很基础,甚至有点小心眼 但在我看来,Review AI 代码,恰恰需要一点小心眼 图片来源:John 'Pathfinder' Lester / Flickr(CC BY 2.0)
2026-10-14鱼鱼