kasper的算法(从0到1)
kasper的算法(从0到1)https://javaguide.cn/cs-basics/data-structure/linear-data-structure.html https://javaguide.cn/cs-basics/algorithms/linkedlist-algorithm-problems.html 项目地址:https://github.com/labuladong/fucking-algorithm 在线文档地址:https://labuladong.gitee.io/algo/home/ http://fishmaple.cn/blog/topicBlog?topicId=7
![kasper的算法(从0到1)]()
2023-10-23kasper
Agent 的重试与换路:失败了再试一次,还是换条路?
Agent 的重试与换路:失败了再试一次,还是换条路?做 Agent 的人,迟早会碰到同一个设计题:工具调用失败了,下一步是原地再试,还是换个策略? 听起来像工程里的重试策略老话题,放到 Agent 里却更别扭——因为失败的原因经常不是“网络抖了一下”,而是“这条路根本走不通”,或者“模型把错误理解歪了,越重试越执着” 我踩过两边的坑:该重试时太早放弃,任务脆;该换路时死磕重试,账单和日志一起爆炸,最后还是失败 这篇整理一下我现在怎么做判断 不是所有失败都该一视同仁 我大致分成四类: 瞬时故障:超时、限流、连接重置 特征是:同一请求,过一会儿可能就好 输入问题:参数缺了、格式不对、路径不存在 特征是:原样再发,几乎必败 权限/策略拒绝:没权限、被安全策略拦住
2026-10-14鱼鱼
给仓库写一份 AGENTS.md:让 AI 编程助手少走弯路
给仓库写一份 AGENTS.md:让 AI 编程助手少走弯路用 AI 编程助手久了,你大概会有一种“祥林嫂”式的疲惫:每开一个新会话,就得把同样的话再说一遍 “我们用 pnpm,不是 npm ”“跑测试要加这个参数,不然会连真实数据库 ”“generated 目录下的代码是自动生成的,别改 ”“提交信息要按这个格式写 ” 说一次两次还好,说到第十次,就会开始怀疑人生 更糟糕的是,你偶尔忘了说,AI 就会理直气壮地按自己的默认习惯来,然后你再花时间收拾 解决这个问题的办法其实很朴素:把这些话写下来,放进仓库,让 AI 每次开工前自己读 这就是 AGENTS.md 要干的事 图片来源:rawpixel.com(CC0 1.0) 一句话:给 AI 看的 README
2026-10-14鱼鱼
并发之AQS全解析
并发之AQS全解析我们知道juc(java.util.concurrent)包下有很多实用的类,提供了很多并发工具,例如线程池、原子类、并发工具、信号量工具、锁等,可以说基本实现都为悲观锁,底层原理基本都使用了AQS(AbstractQueuedSynchronizer),AQS不是一种概念,是并发中实打实的工具类 本篇文章针对AQS做解析 AQS是多线程访问共享资源的同步器框架 AQS的资源可以是独占的也可以是共享的 我们先来简单看一下它的使用方式和ApI(因为是抽象类,是不能直接使用的),下图是AQS的整体脉络 AQS核心就是一个状态值state,同时维护了一个线程的阻塞队列,队列的节点为有两种状态:SHARED(共享)和EXCLUSIVE(独占),节点状态有五种:
![并发之AQS全解析]()
2021-03-12鱼鱼
Java排坑指南(I)jmap jstack jstat等的使用
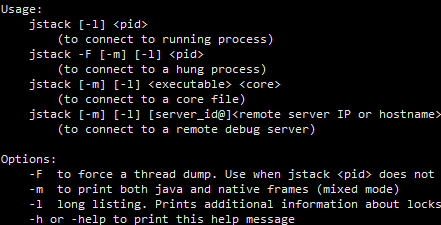
Java排坑指南(I)jmap jstack jstat等的使用运用一些Java自带的可执行jar可以从内存的角度更轻松的排除项目中的问题,我们可能会遇到一些不常见却相对很致命的问题,例如: 某些web项目CPU跑到了100%并且飙高不下(一般来说,web应用都为IO密集应用,不太可能出现cpu高占用的情况) 项目中线程出现阻滞、阻塞(网络请求响应速度明显变慢,甚至因为死锁彻底出现阻塞等) 极可能由内存泄漏引发的不明原因的 OOM(没有预兆的或是基础逻辑问题的内存溢出) 当以上问题发生时,通过代码或是日志其实很难定位到原因所在,因为这一般是基于环境或资源导致的全局性问题,通常很难定位,这时可以通过使用Java自带的性能调优jar包更便捷的定位问题(如果没有配置环境变量,可以在jdk的bin目录下找到他们的jar包)
2020-11-28鱼鱼
Java的SPI机制
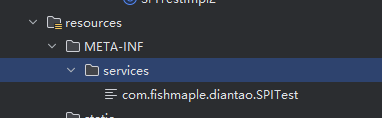
Java的SPI机制SPI(Service Provider Interface) 是JDK内部提供的一种用于服务能力扩展的机制 在服务中通过不同的下沉方法实现能够加载不同的接口实现类,从而实现功能的热插拔 相比一些类似的设计模式(例如策略模式), SPI作为Java自带的实现特性,相对更加灵活和开放 我们常见的JDBC、日志框架slf4j、JavaMail、Spring等组件都基于 SPI实现(例如JDBC针对不同数据源的驱动) 之所以说区别于Java的一些设计模式,因为Java有一些实现能实现 SPI的动态加载 首先让我们定义 SPI对外提供抽象能力的接口类,这里为了便于理解展示包路径:
2024-10-14鱼鱼
排坑指南-异步操作HttpServletRequest丢失Cookie
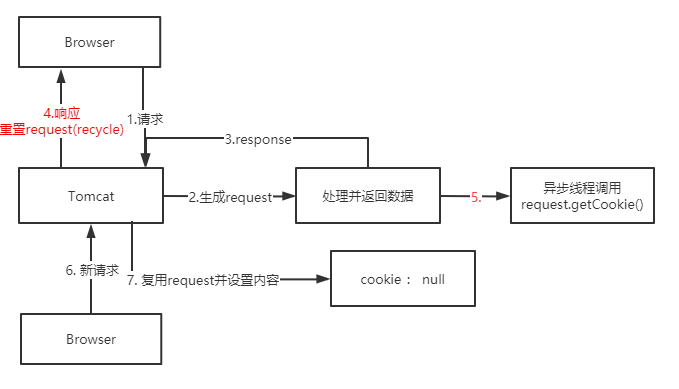
排坑指南-异步操作HttpServletRequest丢失Cookie遇到了一个很奇怪的bug:请求鉴权失败,因为通过Request对象获取到的Cookie中没有数据 经过debug调用request.getCookies()方法返回了null值,但是header属性的cookie却能拿到用户的有效cookie(request.getHeader("cookie")),其中缘由,且慢慢道来 我们可以在web项目中通过Request对象很方便的获取Cookie对象: 但其内部实现其实有一层缓存逻辑,从名为"cookie"的请求头中读取并处理数据转为Cookie对象并不是个省时事,在org.apache.catalina.connector.Request类中可以看到如下代码实现:
2020-11-11鱼鱼
Java中的协程(虚拟线程)探究
Java中的协程(虚拟线程)探究在Java最新的LTS版本 21中,终于实装了协程这一特性 当然,在这些诸如python、golang等轻量级语言中被称为协程的东西,在Java中有个全新的代号——虚拟线程,为了将协程与线程做区分,在Java21中,原Thread被称之为平台线程 下文中,将统一使用线程/协程的方式称呼 我们都知道,Java中引入了线程的概念,区别于系统中的进程 作为并发执行的最小单元,在一定的条件下,使用多个线程同时运作可以有效提高程序的运转效率 而线程这一能力源于系统本身而并非JVM 之所以说是在一定条件下,是因为受限于机器配置情况(CPU的运作机制、核心数),线程的同时运作并不能线性的提升运行性能,单个cpu并不能同时处理多线程任务,实际的运作方式是基于时间片分片,各个线程抢占式执行代码,这样能减少一些无效的io等待(例如网络io、磁盘io实际是会阻塞等待io结果),同时在多核心场景下也能有效利用cpu
![Java中的协程(虚拟线程)探究]()
2024-10-28鱼鱼
让 AI 起变量名和函数名,我留下的几条品味规矩
让 AI 起变量名和函数名,我留下的几条品味规矩命名一直是我写代码时最磨蹭的环节之一 名字起糊了,后面读代码的人(包括一个月后的我)会一直付税 AI 很擅长甩出一串候选名,也很容易甩出看起来专业、读起来空洞的名字 这篇文章记我让它起名时留下的几条规矩——不是语法规范全文,是品味上的取舍 我愿意让 AI 起名,前提是: 我已经能用一句话说明“这个东西在业务里干什么” 我要的是 3–5 个候选,不是一个“最佳答案” 最终选定权在我,尤其是会进公共 API、表字段、事件名的那些 一上来就说“给个好名字”,它常会给你 handleUserData、processInfo、manageService 这类语法正确但语义稀释的词 候选机模式能逼它发散,也逼我比较
2026-10-14鱼鱼
Kafka服务端集群原理
Kafka服务端集群原理kafka是家喻户晓的消息队列,也因“纯粹”而闻名(高性能高吞吐、扩展较少较为简单),此篇文章整理Kafka的基本架构,将按照Kafka的版本迭代分别展示架构的演进(截至版本3.0) 我们在这里暂且只讨论Kafka服务端,对于生产者和消费者的逻辑简单带过 扫盲一下Kafka的部分概念: Producer mq生产者通用叫法 作为消息的生产者,在生产完消息后需要将消息投送到指定的目的地(某个topic的某个partition) Producer可以根据指定选择partition的算法或者是随机方式来选择发布消息到哪个partition; Consumer mq生产者通用叫法 消息消费者,向Kafka broker读取消息的客户端;,负责订阅和消费消息
2022-03-10鱼鱼
长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着
长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着我自己写的那个编程 Agent,最早只用来做一些小改动,十几轮对话就结束了,上下文从来不是问题 后来我开始让它做跨很多文件的迁移,比如把一批旧接口的调用换成新接口 这种任务一跑就是几十轮:读文件、搜索、改代码、跑测试、看报错、再改 每一轮的工具输出都往上下文里堆,没多久就逼近了模型的上下文上限 于是我做了第一版“压缩”:上下文超过某个阈值,就让模型把之前的历史总结成一段话,然后用这段总结替换掉原来的历史,继续往下跑 听起来很合理,跑起来问题一大堆 这篇就讲讲我前后几次改动的过程,以及现在比较稳定的做法 都是在我自己这个 Agent 上摸索出来的经验,换个场景未必完全适用 第一版用的是自由发挥式的摘要,提示大概就是“请总结上面的对话,保留重要信息”
2026-10-14鱼鱼
阻塞队列与Protobuf的Udp通信 - 基于Cat的代理(Agent)项目拆解
阻塞队列与Protobuf的Udp通信 - 基于Cat的代理(Agent)项目拆解CAT是美团点评的一个基于Java开发的异常和性能监控项目,github地址:https://github.com/dianping/cat 本篇文章不是对CAT本身的源码拆解,而是基于本人依赖CAT client开发的代理项目进行拆解,但是并不会纰漏任何技术细节 CAT当前已有很多不同语言的Client,当然暂且是不 CAT本身是通过CAT client收集数据并上报至CAT server,server会进行并,共有六种常见数据格式:Transaction、Event、Problem、Metric、HeartBeat、调用链标记,其实如果不考虑复杂的处理(譬如Metric是可以基于指标生成折线图,Problem可以根据具体的异常类型追溯到相应的会话Track)除去Transaction剩余的数据格式都可以理解为特殊的Event
2020-07-19鱼鱼