
Agent 并行调用工具:哪些能一起跑,哪些必须排队

  created  by  鱼鱼 {{tag}}
创建于 2026年10月16日 09:36:55 最后修改于 2026年10月16日 09:36:55

现在不少模型接口都允许模型在一轮回复里同时发起多个工具调用。对写 Agent 的人来说,这是个很诱人的能力:读五个文件不用等五轮,查三个接口可以一起发,整体耗时一下子降下来。

我第一次给自己的 Agent 打开并行执行时,体感确实快了不少。然后就开始出怪事:有一次它在同一批调用里既改了一个文件,又跑了测试,测试跑的却是改之前的代码,结果它看着“通过”的测试,宣布任务完成。还有一次,两个写文件的调用同时改同一个配置文件,后写的把先写的覆盖了,日志里两个调用都显示成功。

这些问题让我明白:模型愿意并行,不代表这些调用适合并行。模型给出的只是“我想做这几件事”,至于能不能同时做,得由执行层来判断。这篇聊聊我现在是怎么划这条线的。

先分清四类调用

我把工具调用按“能不能一起跑”粗分成四类:

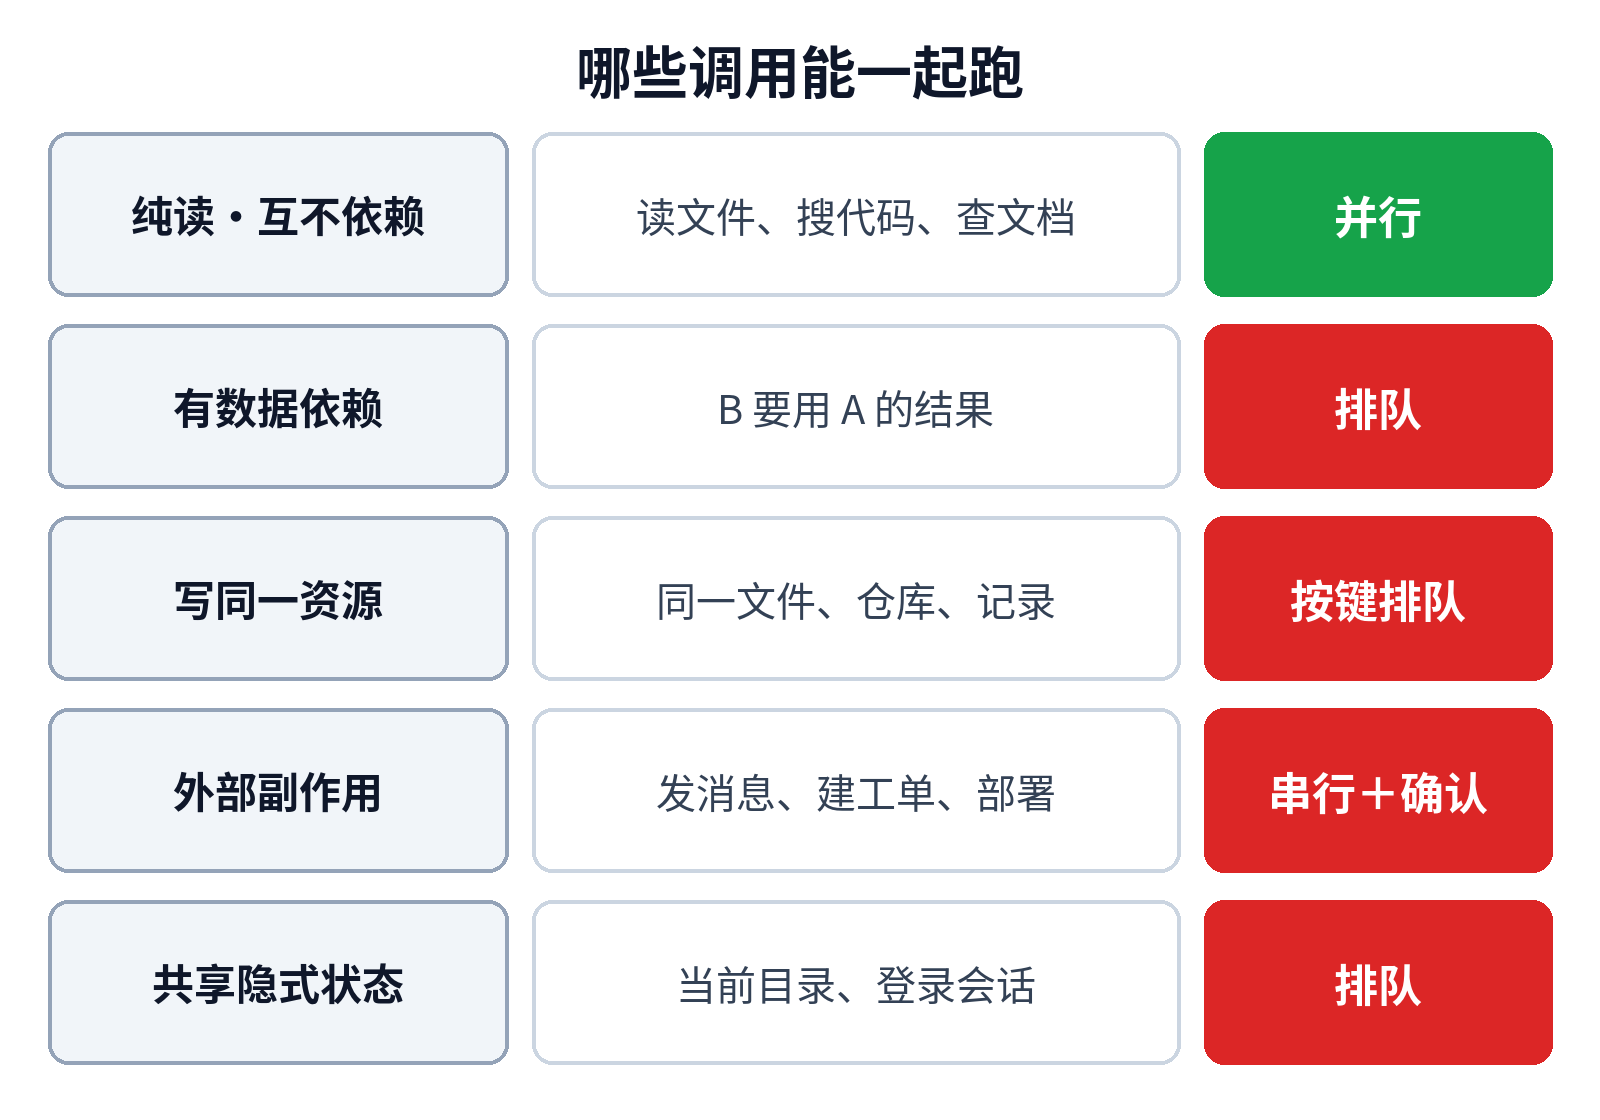
第一类:纯读、互不依赖。读文件、搜索代码、查文档、查只读接口。这类调用没有副作用,彼此也不需要对方的结果,是并行的最佳对象。Agent 探索阶段的大部分调用都属于这一类,并行收益也主要来自这里。

第二类:有数据依赖。B 需要 A 的输出才能决定参数。比如先搜索找到文件路径,再读这个文件。严格来说,模型如果真的依赖 A 的结果,它就不该在同一轮里发出 B;但我见过模型“猜”一个参数先发出去,所以执行层也要防。

第三类:写同一个资源。同时改同一个文件、同时操作同一个 git 仓库的索引、同时修改同一条数据库记录。这类调用单独看都没问题,一起跑就可能互相覆盖,或者留下中间状态。

第四类:有外部副作用。发消息、创建工单、调用支付或部署接口。这类调用即使操作的是不同对象,我也倾向于排队,因为一旦出错,回滚成本很高,而且需要在执行前让人确认。
哪些工具调用能一起跑:纯读并行,依赖、同资源写、外部副作用、共享状态要排队

图:哪些工具调用能一起跑:纯读并行,依赖、同资源写、外部副作用、共享状态要排队(原创示意图)

还有一类比较隐蔽:共享隐式状态。比如一个 shell 会话的当前目录和环境变量、一个浏览器的登录会话、一个全局的“当前选中项”。两个调用看起来操作的是不同东西,背后却共用一个状态,一个改了目录,另一个就跑偏了。这类问题最难查,因为日志里看不出冲突。

让工具自己声明“能不能并行”

靠模型判断哪些能并行,不靠谱。我现在的做法是在工具定义里加 元数据,由执行层按 元数据调度。每个工具声明这么几件事:

  • 是否只读;

  • 会碰哪些资源,最好能从参数里算出一个“资源键”,比如文件路径、仓库路径、记录 ID;

  • 是否幂等,重复执行一次会不会多出副作用;

  • 是否需要人工确认。

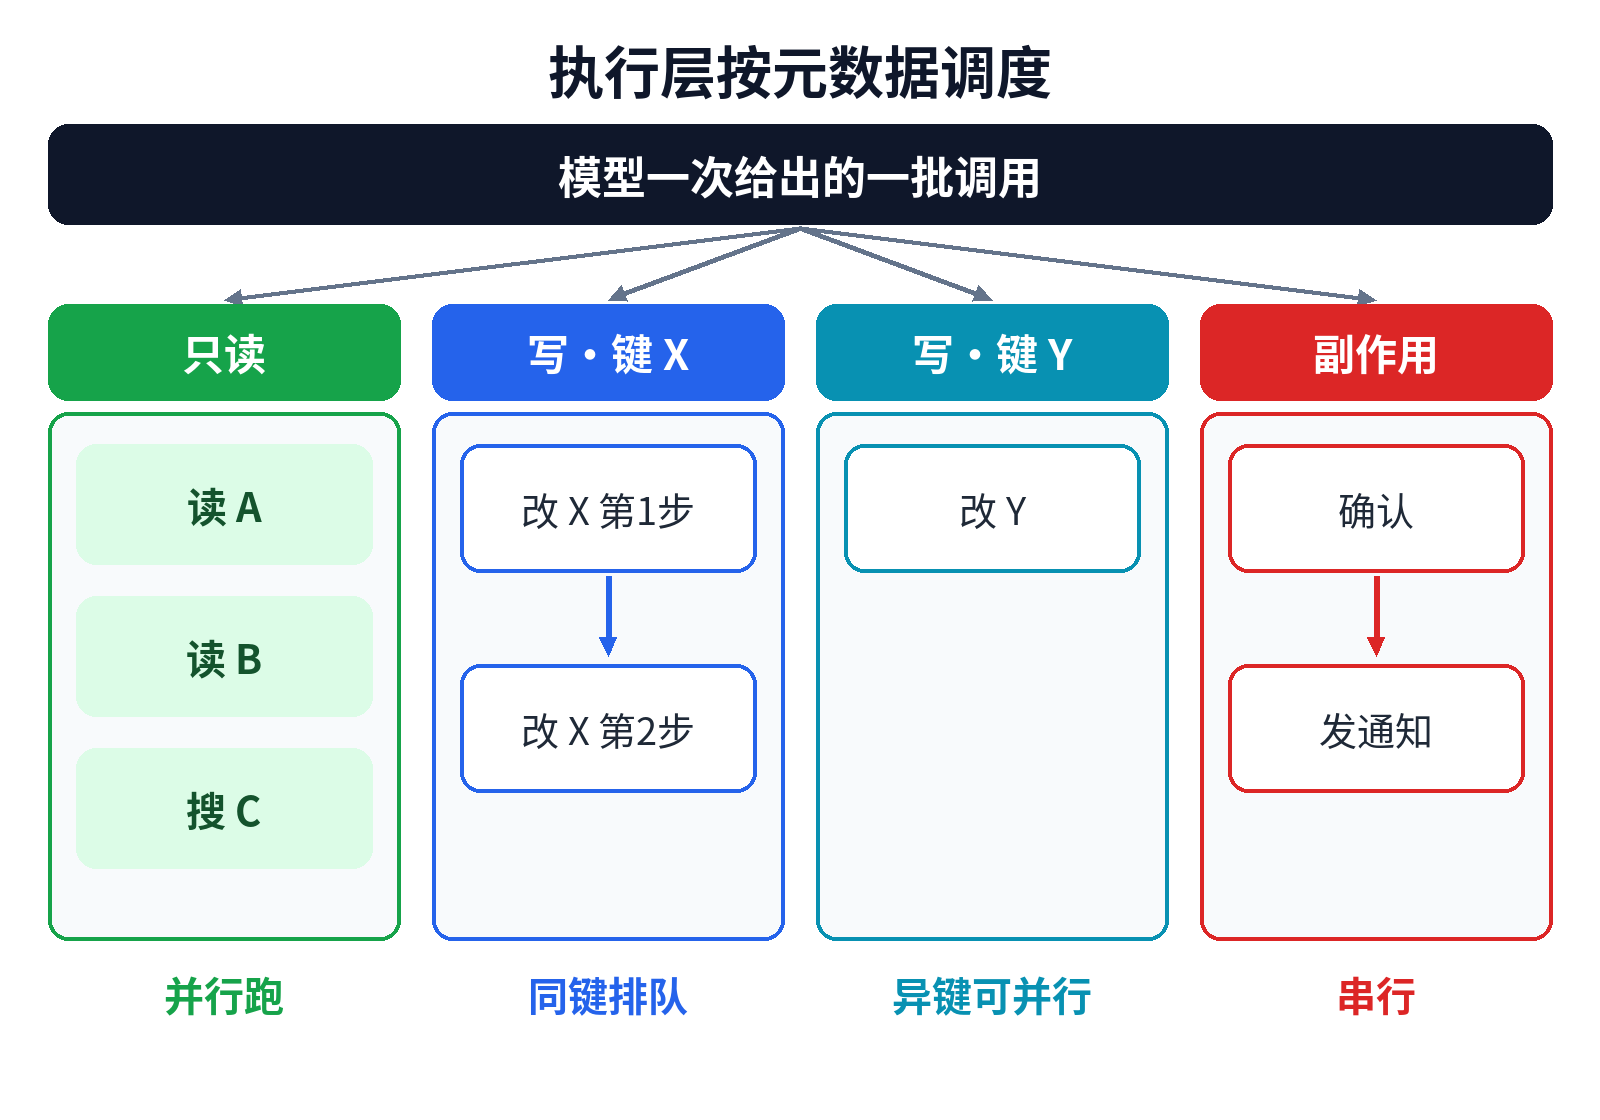
调度规则就很简单了:只读调用直接并行;写操作按资源键分组,同一个键的调用严格按模型给出的顺序串行,不同键之间可以并行;有外部副作用的,一律串行,并在执行前过确认。
执行层按<el-popover ref='popover2' placement='top' width='200' trigger='hover' content='元数据(Metadata),又称中介数据、中继数据,为描述数据的数据(data about data),主要是描述数据属性(property)的信息,用来支持如指示存储位置、历史数据、资源查找、文件记录等功能。'></el-popover>  <span v-popover:popover2 class='dictionary-word'>元数据</span>调度:只读并行,写操作按资源键排队,副作用串行

图:执行层按 元数据调度:只读并行,写操作按资源键排队,副作用串行(原创示意图)

用 Java 写,大概是这样一个骨架。真实实现还有超时、取消、并发上限,这里只留核心思路:

Map<String, CompletableFuture<Result>> tails = new HashMap<>();
List<CompletableFuture<Result>> all = new ArrayList<>();
for (ToolCall c : batch) {                       // 按模型给出的顺序
    if (c.tool().readOnly()) {
        all.add(CompletableFuture.supplyAsync(() -> run(c), pool));
    } else {
        String key = c.tool().resourceKey(c.args());
        CompletableFuture<Result> prev = tails.getOrDefault(key,
            CompletableFuture.completedFuture(null));
        CompletableFuture<Result> next = prev.handleAsync((r, e) -> run(c), pool);
        tails.put(key, next);
        all.add(next);
    }
}

这里同一资源键上的写操作被串成一条链,前一个结束(无论成败)才轮到下一个。前一个失败了后一个要不要继续,是个策略问题,我倾向于默认继续执行但在结果里标明“前置写操作失败”,让模型自己决定怎么补救。

读写混在同一批里怎么办

开头那个“改了文件又跑测试”的例子,属于读写混在一起。测试本身是只读的(假设它不写文件),但它读的是刚被写的资源。

我试过几种处理方式,最后选了最保守的一种:同一批调用里只要出现写操作,所有读操作都排在写操作之后执行,或者干脆把这一批拆成两轮,先写后读。会损失一点并行度,但避免了“读到旧数据”这种非常隐蔽的错误。

更精细的做法是判断读操作的资源和写操作有没有交集,没交集就并行。但跑测试这种操作,它会读哪些文件你很难提前知道,交集判断不出来,只能当作“读全部”。所以实际上,测试、构建这类操作在我这里几乎总是排在写操作之后。

部分失败:别让一个错误吞掉整批

并行执行还会带来一个串行时不太明显的问题:部分失败。

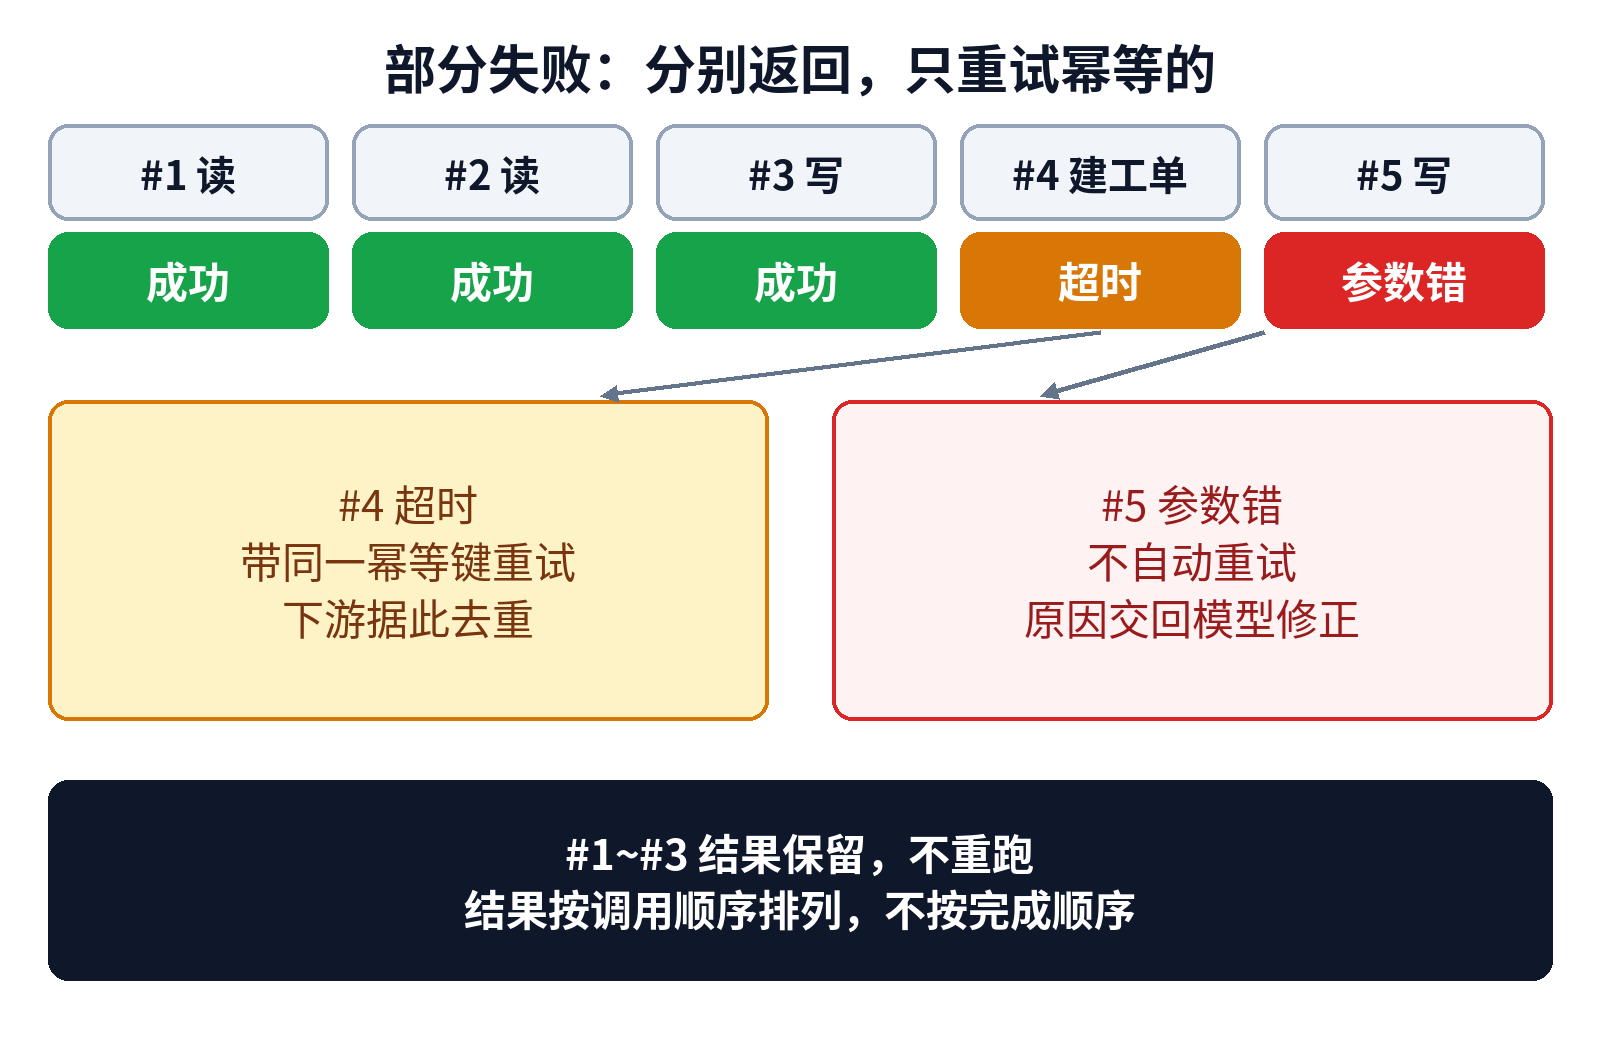
五个调用一起发,三个成功、一个超时、一个参数错误。最糟的处理是整批报错,模型只看到“失败”,然后把五个全部重试一遍,成功的那三个也重复执行了。如果那三个里有写操作,就重复写了。

我的原则是:

  1. 每个调用独立返回结果,带上调用 ID,成功的给结果,失败的给原因;

  2. 结果按调用顺序排列,而不是完成顺序,免得模型把结果和调用对错;

  3. 只重试失败的那个,并且只有声明了幂等的工具才允许自动重试。

幂等:并行加重试之后必须考虑的事

说到重试,就绕不开幂等。

串行执行时,一个调用超时了,我们通常还能判断它大概执行到了哪一步。并行时多个调用同时在飞,超时的那个到底执行了没有,往往说不清:可能请求根本没发出去,也可能对方已经处理完、只是响应没回来。

对只读操作,重试无所谓。对写操作,尤其是有外部副作用的,盲目重试就可能产生两条工单、两条消息、两次扣款。我的做法是给这类调用生成一个幂等键,由执行层在第一次调用时生成,重试时带上同一个键,下游据此去重。如果下游不支持幂等键,那这个工具就标成“不可自动重试”,超时后交给人判断。
部分失败处理:逐个返回结果,只带同一幂等键重试可重试的调用

图:部分失败处理:逐个返回结果,只带同一幂等键重试可重试的调用(原创示意图)

并发上限和速率限制

最后是一个比较“运维”的问题:并行度不是越高越好。

模型可能一口气发出二十个搜索请求,执行层要是全部同时打出去,很容易撞上下游接口的速率限制,或者把本机的进程数、文件句柄撑满。我会给执行层设一个全局并发上限,再给每类工具设单独的上限,比如访问外部接口的工具并发数压得更低。超过上限的调用排队等待,而不是直接拒绝。

这些上限的具体数值,我都是从保守值起步,看运行日志里的排队时长和下游错误率慢慢调,没有什么通用的标准答案。

怎么测这套调度

并发问题有个讨厌的特点:本地跑十次都正常,上线跑一百次才出一次。我测调度逻辑时用了个笨办法:在测试环境里给每个工具的执行随机加一点延迟,让完成顺序每次都被打乱,然后把同一批调用反复跑很多遍,检查最终的文件内容、调用顺序和返回结果是否每次都一致。

如果某个资源键忘了声明,或者某个读操作偷偷依赖了写操作的结果,打乱顺序之后通常很快就会露出马脚。比起靠肉眼审代码找并发问题,这个办法省心得多。

小结

并行调用工具,本质上是把“同时做几件事”的决定从模型手里拿一部分回来,交给一个了解资源和副作用的执行层。我现在守的几条线是:

  • 纯读、互不依赖的,放心并行;

  • 写同一资源的,按资源键排队;

  • 有外部副作用的,一律串行加确认;

  • 读写混在一批里,读排在写后面;

  • 部分失败分别返回,只重试幂等的那个。

规则都不复杂,难的是在工具定义阶段就把只读、资源键、幂等这些信息想清楚。一开始多花点时间写 元数据,后面就能少排查很多“明明都成功了,结果却不对”的怪问题。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

Agent 并行调用工具:哪些能一起跑,哪些必须排队

Agent 并行调用工具:哪些能一起跑,哪些必须排队

现在不少模型接口都允许模型在一轮回复里同时发起多个工具调用。对写 Agent 的人来说,这是个很诱人的能力:读五个文件不用等五轮,查三个接口可以一起发,整体耗时一下子降下来。

我第一次给自己的 Agent 打开并行执行时,体感确实快了不少。然后就开始出怪事:有一次它在同一批调用里既改了一个文件,又跑了测试,测试跑的却是改之前的代码,结果它看着“通过”的测试,宣布任务完成。还有一次,两个写文件的调用同时改同一个配置文件,后写的把先写的覆盖了,日志里两个调用都显示成功。

这些问题让我明白:模型愿意并行,不代表这些调用适合并行。模型给出的只是“我想做这几件事”,至于能不能同时做,得由执行层来判断。这篇聊聊我现在是怎么划这条线的。

先分清四类调用

我把工具调用按“能不能一起跑”粗分成四类:

第一类:纯读、互不依赖。读文件、搜索代码、查文档、查只读接口。这类调用没有副作用,彼此也不需要对方的结果,是并行的最佳对象。Agent 探索阶段的大部分调用都属于这一类,并行收益也主要来自这里。

第二类:有数据依赖。B 需要 A 的输出才能决定参数。比如先搜索找到文件路径,再读这个文件。严格来说,模型如果真的依赖 A 的结果,它就不该在同一轮里发出 B;但我见过模型“猜”一个参数先发出去,所以执行层也要防。

第三类:写同一个资源。同时改同一个文件、同时操作同一个 git 仓库的索引、同时修改同一条数据库记录。这类调用单独看都没问题,一起跑就可能互相覆盖,或者留下中间状态。

第四类:有外部副作用。发消息、创建工单、调用支付或部署接口。这类调用即使操作的是不同对象,我也倾向于排队,因为一旦出错,回滚成本很高,而且需要在执行前让人确认。

哪些工具调用能一起跑:纯读并行,依赖、同资源写、外部副作用、共享状态要排队

图:哪些工具调用能一起跑:纯读并行,依赖、同资源写、外部副作用、共享状态要排队(原创示意图)

还有一类比较隐蔽:共享隐式状态。比如一个 shell 会话的当前目录和环境变量、一个浏览器的登录会话、一个全局的“当前选中项”。两个调用看起来操作的是不同东西,背后却共用一个状态,一个改了目录,另一个就跑偏了。这类问题最难查,因为日志里看不出冲突。

让工具自己声明“能不能并行”

靠模型判断哪些能并行,不靠谱。我现在的做法是在工具定义里加 元数据,由执行层按 元数据调度。每个工具声明这么几件事:

调度规则就很简单了:只读调用直接并行;写操作按资源键分组,同一个键的调用严格按模型给出的顺序串行,不同键之间可以并行;有外部副作用的,一律串行,并在执行前过确认。

执行层按<el-popover ref='popover2' placement='top' width='200' trigger='hover' content='元数据(Metadata),又称中介数据、中继数据,为描述数据的数据(data about data),主要是描述数据属性(property)的信息,用来支持如指示存储位置、历史数据、资源查找、文件记录等功能。'></el-popover>  <span v-popover:popover2 class='dictionary-word'>元数据</span>调度:只读并行,写操作按资源键排队,副作用串行

图:执行层按 元数据调度:只读并行,写操作按资源键排队,副作用串行(原创示意图)

用 Java 写,大概是这样一个骨架。真实实现还有超时、取消、并发上限,这里只留核心思路:

Map<String, CompletableFuture<Result>> tails = new HashMap<>();
List<CompletableFuture<Result>> all = new ArrayList<>();
for (ToolCall c : batch) {                       // 按模型给出的顺序
    if (c.tool().readOnly()) {
        all.add(CompletableFuture.supplyAsync(() -> run(c), pool));
    } else {
        String key = c.tool().resourceKey(c.args());
        CompletableFuture<Result> prev = tails.getOrDefault(key,
            CompletableFuture.completedFuture(null));
        CompletableFuture<Result> next = prev.handleAsync((r, e) -> run(c), pool);
        tails.put(key, next);
        all.add(next);
    }
}

这里同一资源键上的写操作被串成一条链,前一个结束(无论成败)才轮到下一个。前一个失败了后一个要不要继续,是个策略问题,我倾向于默认继续执行但在结果里标明“前置写操作失败”,让模型自己决定怎么补救。

读写混在同一批里怎么办

开头那个“改了文件又跑测试”的例子,属于读写混在一起。测试本身是只读的(假设它不写文件),但它读的是刚被写的资源。

我试过几种处理方式,最后选了最保守的一种:同一批调用里只要出现写操作,所有读操作都排在写操作之后执行,或者干脆把这一批拆成两轮,先写后读。会损失一点并行度,但避免了“读到旧数据”这种非常隐蔽的错误。

更精细的做法是判断读操作的资源和写操作有没有交集,没交集就并行。但跑测试这种操作,它会读哪些文件你很难提前知道,交集判断不出来,只能当作“读全部”。所以实际上,测试、构建这类操作在我这里几乎总是排在写操作之后。

部分失败:别让一个错误吞掉整批

并行执行还会带来一个串行时不太明显的问题:部分失败。

五个调用一起发,三个成功、一个超时、一个参数错误。最糟的处理是整批报错,模型只看到“失败”,然后把五个全部重试一遍,成功的那三个也重复执行了。如果那三个里有写操作,就重复写了。

我的原则是:

  1. 每个调用独立返回结果,带上调用 ID,成功的给结果,失败的给原因;

  2. 结果按调用顺序排列,而不是完成顺序,免得模型把结果和调用对错;

  3. 只重试失败的那个,并且只有声明了幂等的工具才允许自动重试。

幂等:并行加重试之后必须考虑的事

说到重试,就绕不开幂等。

串行执行时,一个调用超时了,我们通常还能判断它大概执行到了哪一步。并行时多个调用同时在飞,超时的那个到底执行了没有,往往说不清:可能请求根本没发出去,也可能对方已经处理完、只是响应没回来。

对只读操作,重试无所谓。对写操作,尤其是有外部副作用的,盲目重试就可能产生两条工单、两条消息、两次扣款。我的做法是给这类调用生成一个幂等键,由执行层在第一次调用时生成,重试时带上同一个键,下游据此去重。如果下游不支持幂等键,那这个工具就标成“不可自动重试”,超时后交给人判断。

部分失败处理:逐个返回结果,只带同一幂等键重试可重试的调用

图:部分失败处理:逐个返回结果,只带同一幂等键重试可重试的调用(原创示意图)

并发上限和速率限制

最后是一个比较“运维”的问题:并行度不是越高越好。

模型可能一口气发出二十个搜索请求,执行层要是全部同时打出去,很容易撞上下游接口的速率限制,或者把本机的进程数、文件句柄撑满。我会给执行层设一个全局并发上限,再给每类工具设单独的上限,比如访问外部接口的工具并发数压得更低。超过上限的调用排队等待,而不是直接拒绝。

这些上限的具体数值,我都是从保守值起步,看运行日志里的排队时长和下游错误率慢慢调,没有什么通用的标准答案。

怎么测这套调度

并发问题有个讨厌的特点:本地跑十次都正常,上线跑一百次才出一次。我测调度逻辑时用了个笨办法:在测试环境里给每个工具的执行随机加一点延迟,让完成顺序每次都被打乱,然后把同一批调用反复跑很多遍,检查最终的文件内容、调用顺序和返回结果是否每次都一致。

如果某个资源键忘了声明,或者某个读操作偷偷依赖了写操作的结果,打乱顺序之后通常很快就会露出马脚。比起靠肉眼审代码找并发问题,这个办法省心得多。

小结

并行调用工具,本质上是把“同时做几件事”的决定从模型手里拿一部分回来,交给一个了解资源和副作用的执行层。我现在守的几条线是:

规则都不复杂,难的是在工具定义阶段就把只读、资源键、幂等这些信息想清楚。一开始多花点时间写 元数据,后面就能少排查很多“明明都成功了,结果却不对”的怪问题。


Agent 并行调用工具:哪些能一起跑,哪些必须排队2026-10-16鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论