第一次用 AI 改 bug 的真实节奏
第一次用 AI 改 bug 的真实节奏第一次认真用 AI 改 bug,不是那种“帮我写个排序”的玩具题,是线上真出了问题:某个接口偶发超时,日志里只有一句 Read timed out,复现不稳 我那会儿把堆栈和一段相关代码扔给 AI,它很快给了一版“优化建议”——加超时、加重试、换连接池参数 看起来很专业,我差点就合进去了 后来自己又翻了半小时才发现:真正的原因是下游在高峰时返回了一个空 body,客户端按固定 schema 去解析,偶发抛异常,异常被上层吞掉,最终表现为超时 AI 那套建议能“缓解症状”,但治不了病,还可能把问题藏得更深 这篇文章想写的,是我后来慢慢摸出来的一套节奏:怎么描述现象、给什么上下文、什么时候该自己看代码
2026-10-14鱼鱼
让 AI 写 commit message,我留下的几条规矩
让 AI 写 commit message,我留下的几条规矩现在写完一小段改动,我偶尔会让 AI 根据 diff 拟一条 commit message 省事是真省事,翻车也真实翻过:有的标题漂亮得像广告,读完不知道改了什么;有的把半成品猜想写进历史,后来查问题的人会被带沟里 所以我不是禁用,而是给它加了几条规矩 规矩的核心只有一句:说明白改了什么、为什么改;别写套话,别替我编动机 Commit message 是给未来的自己和同事看的 好的 message 能回答:这次动了哪类东西?动机是修 bug、加能力,还是清债?有没有故意不做的范围? AI 擅长扫 diff、归纳文件级变化,比我在疲惫时随手敲的 fix、update 强 但它也容易:
2026-10-14鱼鱼
改了一句系统提示词,Agent 就变了个样:我开始给提示词做版本管理
改了一句系统提示词,Agent 就变了个样:我开始给提示词做版本管理先说一次让我印象很深的翻车 我维护着一个内部用的小 Agent,帮同事查工单、查日志、整理排查结论 有段时间有人反馈它“太啰嗦”,每次回答都要铺垫好几段 我就去后台的配置里,在系统提示词末尾加了一句:“回答尽量简洁 ” 改完自己试了两个问题,回答确实短了,挺满意,就没再管 过了几天,陆续有同事说它“变笨了”:以前问它某个工单的状态,它会先调用查询工具,再基于查到的结果回答;现在它经常不查,直接根据对话里的只言片语给个结论 还有一个多步骤的排查任务,它以前会一步步来,现在倾向于一步跳到结论 我一开始完全没往那句“尽量简洁”上想,在日志里找了半天别的原因 更尴尬的是,我想看看“几天前的提示词长什么样”,发现做不到——提示词存在配置后台,直接在线改,改完就覆盖了,没有历史
2026-10-14鱼鱼
多智能体协作的几种常见模式
多智能体协作的几种常见模式一个 Agent 不够用时,自然会想到“多找几个 Agent 分工” 但多智能体并不是数量越多越好——它带来分工优势的同时,也带来了通信成本、调试难度和 token 开销 本文梳理几种常见协作模式及其适用场景,给出主管—工人、评审循环的 Python 示例和 Java 版的消息结构,并总结常见坑、检查清单与 FAQ 从“大而全”的单个 Agent 到“小而专”的分工 单 Agent 加工具,已经能解决很大一类问题 但随着任务变复杂,常见瓶颈会逐渐出现: 上下文被挤满:几十个工具的说明、长长的历史、大量检索结果挤在一个窗口里,模型注意力被稀释; 角色冲突:同一个提示词里既要求“大胆创作”又要求“严格挑错”,两种要求互相拉扯;
2026-10-14鱼鱼
盘点redis中特殊的数据类型 HyperLogLog Bitmap
盘点redis中特殊的数据类型 HyperLogLog Bitmap 基数计数(cardinality counting)通常用来统计一个集合中不重复的元素个数,例如统计某个网站的UV,或者用户搜索网站的关键词数量 数据分析、网络监控及数据库优化等领域都会涉及到基数计数的需求 要实现基数计数,最简单的做法是记录集合中所有不重复的元素集合S_uSu,当新来一个元素x_ixi,若S_uSu中不包含元素x_ixi,则将x_ixi加入S_uSu,否则不加入,计数值就是S_uSu的元素数量 这种做法存在两个问题: 当统计的数据量变大时,相应的存储内存也会线性增长 当集合S_uSu变大,判断其是否包含新加入元素x_ixi的成本变大 大数据量背景下,要实现基数计数,首先需要确定存储统计数据的方案,以及如何根据存储的数据计算基数值;另外还有一些场景下需要融合多个独立统计的基数值,例如对一个网站分别统计了三天的UV,现在需要知道这三天的UV总量是多少,怎么融合多个统计值
![盘点redis中特殊的数据类型 HyperLogLog Bitmap]()
2022-01-12鱼鱼
AI大模型定价对比
AI大模型定价对比https://open.bigmodel.cn/pricing 火山方舟也提供端点(GLM3 0.001) https://openai.com/ja-JP/api/pricing/ 出入价格不一样 官网和火山都有 另外有免费版本的

2024-12-18鱼鱼
浅析RPC框架Thrift
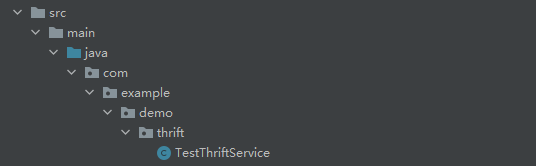
浅析RPC框架ThriftThrift是由Facebook开发的 RPC远程调用的框架,使用独有的Thrift协议进行可跨语言的远程调用 有点类似protobuf 无论使用何种语言,首先要准备Thrift编译环境,可以去官网下载相应的Thrift执行文件,下文均以Windows为例 下载后可以选择性的配置环境变量,最终在shell中可执行Thrift 在项目中,预先准备好libthrift依赖,maven写法: 例如: 定义一个testService.thrift(idl文件名不重要),一般都会定义在resources的thrift文件夹下: 这里定义了两个方法,分别返回字符串和int类型,在thrift的idl中,对于变量的定义如下:
2022-03-04鱼鱼
Spring源码解析(1) 基于SSM看Spring的使用和Spring启动监听
Spring源码解析(1) 基于SSM看Spring的使用和Spring启动监听查看源码的顺序就见仁见智了,比较普遍的做法是从IoC入手,了解容器注入的每一个环节,掌握大致的流程 由于使用的是Spring,所以在这里我们引入比较古老的xml配置文件进行bean的配置,首先定义一个bean: 配置描述bean的xml,核心只有一行: 这样一来就可以使用BeanFactory这个容器来注入bean并使用了: 本来有封装好的XmlBeanFactory,这一类现在已经被弃用了,所以采用了他的父类DefaultListableBeanFactory;当然,也可以使用更加方便和常用的ApplicationContext: 当然从xml文件读取bean的配置只是其中一种目前用的不多的加载方式,还有基于包扫描等加载bean的方法,此处仅为理解IoC的基本使用

2020-08-04鱼鱼
给仓库写一份 AGENTS.md:让 AI 编程助手少走弯路
给仓库写一份 AGENTS.md:让 AI 编程助手少走弯路用 AI 编程助手久了,你大概会有一种“祥林嫂”式的疲惫:每开一个新会话,就得把同样的话再说一遍 “我们用 pnpm,不是 npm ”“跑测试要加这个参数,不然会连真实数据库 ”“generated 目录下的代码是自动生成的,别改 ”“提交信息要按这个格式写 ” 说一次两次还好,说到第十次,就会开始怀疑人生 更糟糕的是,你偶尔忘了说,AI 就会理直气壮地按自己的默认习惯来,然后你再花时间收拾 解决这个问题的办法其实很朴素:把这些话写下来,放进仓库,让 AI 每次开工前自己读 这就是 AGENTS.md 要干的事 图片来源:rawpixel.com(CC0 1.0) 一句话:给 AI 看的 README
2026-10-14鱼鱼
AI 生成测试我怎么取舍:哪些让它写,哪些必须人写
AI 生成测试我怎么取舍:哪些让它写,哪些必须人写用 AI 写业务代码越来越顺手之后,下一件很自然的事就是:让它把测试也补上 说实话,这一步的爽感很强——几分钟冒出一堆 should_xxx,覆盖率数字往上跳,CI 绿灯 问题也正好出在这里:绿灯不等于有保险 我经历过一次挺丢脸的事 AI 帮我补了十几个单测,覆盖率从 40% 拉到 75%,合并后第三天生产就炸了 回头看测试,几乎每个都在验证“mock 对象有没有按我设定的方式被调用”,真正的业务不变量一个都没钉住 测试在保护 mock,不在保护系统 这篇文章想说清楚三件事:哪些测例我愿意交给 AI;哪些我坚持人手写;以及怎么减少“假绿” 图片来源:原创示意图 我不想装清高
2026-10-14鱼鱼
Agent 跑批任务时我盯的几个「仪表盘」指标
Agent 跑批任务时我盯的几个「仪表盘」指标把 Agent 丢进一批任务里跑,最容易犯的错是:只盯最终答案 答案对了就庆祝,错了再翻日志 跑多了你会发现——很多失败在中途就已经写在仪表盘上了,只是你没看 这篇文章记我跑批(批量任务、夜间任务、评测集重跑)时会盯的几类指标 不是定行业标准,是我个人反复被坑后留下的观察清单 如果你也在用 Agent 刷题集、批量修测试、批量整理仓库,希望能少踩一点「早上起来只看见成功率」的坑 最终答案是结果,不是过程健康度 两类任务都可能「答对」: 走了一条干净路径,三步完成 绕了四十步,失败重试一堆,最后撞对 只看答案,你会把第二种也当成可上线策略 成本、稳定性、可复现性全被藏起来了
2026-10-15鱼鱼
JEV 是什么:一个不写字、只做判断的模型(附我的调试台 jev.fishmaple.cn)
JEV 是什么:一个不写字、只做判断的模型(附我的调试台 jev.fishmaple.cn)先放链接:jev.fishmaple.cn 这是我前两天搭的一个小调试台,叫 Jev Lab 打开就能用,填一个 OpenRouter 的 Key,就可以直接在浏览器里调 JEV 这篇想聊聊 JEV 到底是个什么东西,它跟传统分类器、重排序差在哪,以及九月它出来之后,OpenAI、微软、Cloudflare、阿里、Perplexity 这些大厂怎么对标的 九月中旬刷 OpenRouter 的模型列表,看到一个叫 typesafe/jev-1.13 的东西,上线日期是 2026 年 9 月 18 日 价格那栏把我看愣了:输入每百万 token 0.042 美元,输出是 0 输出免费?我第一反应是标错了
2026-10-14鱼鱼