Agent 的工具返回太长怎么办:截断、分页与摘要的取舍

  created  by  鱼鱼 {{tag}}
创建于 2026年10月16日 09:36:39 最后修改于 2026年10月16日 09:36:39

自己写 Agent 的时候,我最早关心的是工具怎么定义、参数怎么描述、调用失败怎么处理。工具返回什么,反而想得很少:命令跑完了,stdout 拿回来,原样塞进上下文,不就行了?

后来有一次让 Agent 排查一个线上问题,它调了一下读日志的工具。那个日志文件几十兆,工具老老实实全读回来了。结果要么是请求直接超出上下文上限报错,要么是在我加了粗暴截断之后,它看到前面几千行正常日志,得出结论“日志里没有发现异常”。真正的报错在文件末尾,它根本没看到。

这件事让我意识到:工具返回多长、怎么变短,是 Agent 设计里一个独立的问题,而且没有银弹。常见的三种办法——截断、分页、摘要——各有各的代价。这篇聊聊我在这几种之间是怎么取舍的。

为什么不能原样塞回去

先说清楚太长的返回到底伤在哪,不只是“超上限报错”那么简单。

第一是挤掉别的东西。上下文是有限的,一次工具返回占掉一大半,前面的任务说明、用户的约束、之前的推理就会被挤到边缘。按我的体感,上下文塞得越满,模型越容易忘掉早先交代的规矩。这一点我没有严格测过,是自己用下来的感觉。

第二是成本和延迟。每一轮对话都要把历史带上,一次十万字的返回,后面每一步都在为它付钱、等它处理。

第三是注意力被稀释。返回里真正有用的可能只有几行,剩下全是噪音。模型要从一大堆东西里找那几行,找漏的概率并不低。

所以,变短是必须的。问题是怎么变短,以及变短之后模型还知不知道“这不是全部”。

截断:最简单,也最容易骗人

截断就是只保留前 N 个字符或前 N 行。实现成本几乎为零,所以大部分人第一版都这么做,我也是。

截断最大的问题是静默。如果模型不知道结果被截了,它会把看到的部分当成全部。搜索结果被截断,它会说“只找到这几处”;日志被截断,它会说“没有异常”。这比不给结果还糟,因为它会基于错误的“完整信息”做出很自信的判断。

我现在的截断一定带三样东西:

  1. 明确的截断标记:告诉模型“这里省略了多少行”;

  2. 总量信息:原始结果一共多少行、多少字节;

  3. 怎么拿到更多:比如“可以用 offset 参数读取后续内容”,或者“可以用 pattern 参数过滤”。

另外,对日志这类内容,我会头尾都留,而不是只留开头。很多命令的关键信息在末尾:报错堆栈、测试汇总、退出原因。只截开头,恰恰丢掉了最重要的部分。
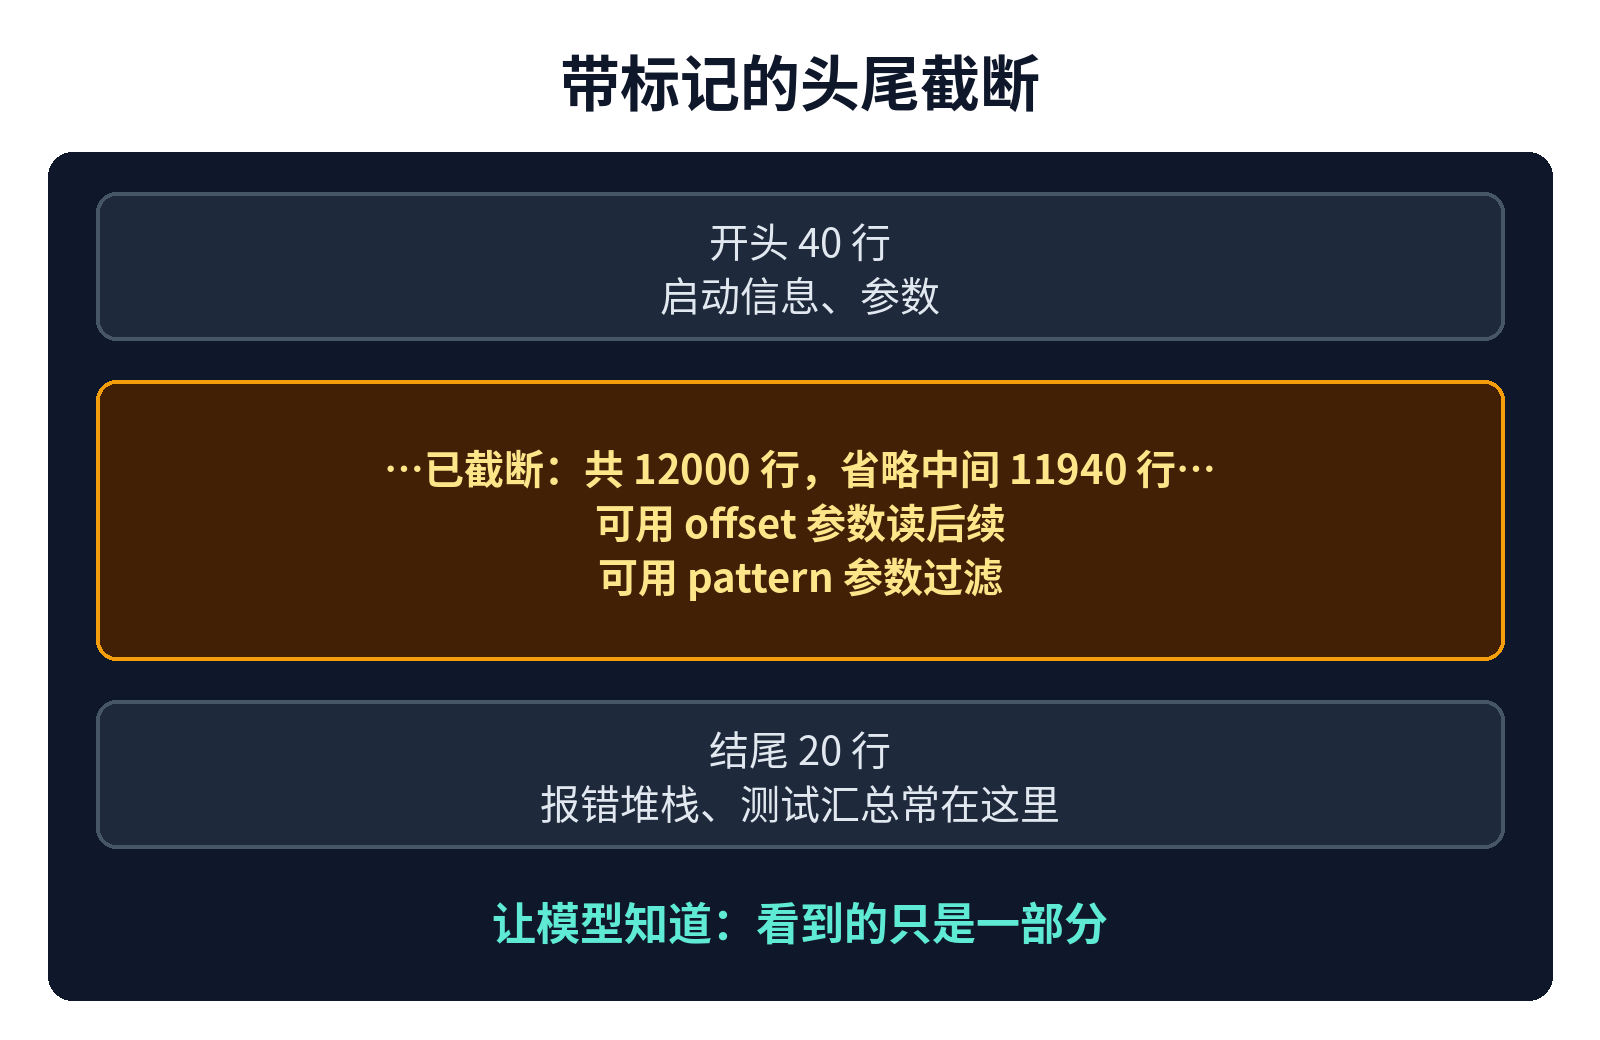
带标记的头尾截断:保留开头和结尾,中间写明省略多少、怎么取更多

图:带标记的头尾截断:保留开头和结尾,中间写明省略多少、怎么取更多(原创示意图)

写成代码大概是这样,很朴素:

String clip(List<String> lines, int head, int tail) {
    if (lines.size() <= head + tail) return String.join("\n", lines);
    int omitted = lines.size() - head - tail;
    return String.join("\n", lines.subList(0, head))
        + "\n…[已截断:共 " + lines.size() + " 行,省略中间 " + omitted
        + " 行;可用 offset/pattern 参数查看更多]…\n"
        + String.join("\n", lines.subList(lines.size() - tail, lines.size()));
}

还有两个小坑。一是按字符截断时别截在多字节字符或者代理对中间,否则会出现乱码;二是别截断结构化数据。一个 JSON 被从中间砍断,模型拿到的是不合法的 JSON,它可能会自己“脑补”补全,这就更危险了。结构化数据应该按条目截,比如只返回前 50 条,再附上总条数。

分页:保真,但要模型愿意翻页

分页是把结果切成一页一页,每次返回一页,附带下一页的游标或偏移量。和截断相比,它的好处是信息不丢,模型想看都能看到。

但分页把一个决定交给了模型:要不要翻下一页。我观察到两种极端。一种是它看完第一页就下结论,从不翻页,效果和截断差不多;另一种是它一页接一页地翻,翻了二十页还没停,步数和成本都上去了。

我的处理方式是:

  • 每页都带上总量和位置,比如“第 1 页,共 37 页,每页 100 条”,让模型知道自己看了多少比例;

  • 在工具描述里写清楚什么时候该翻页,比如“如果要确认某项不存在,必须查看全部页,或改用过滤参数”;

  • 给翻页设上限,超过一定页数就提示它换策略:加过滤条件、缩小范围,而不是继续翻。

分页最适合的是结构化、可排序、条目之间相对独立的数据:数据库查询结果、文件列表、搜索命中列表。对于日志、长文档这类需要上下文连贯的内容,分页的边界会把相关的内容切开,效果就差一些。

摘要:最省上下文,也最不可控

摘要是先用规则或者另一个模型把长结果压缩成短的,再交给主 Agent。比如一个网页读回来几万字,先摘要成几百字的要点。

摘要的问题在于它多了一层转述。摘要模型认为不重要的细节,主 Agent 就永远看不到了。而排查问题时最关键的,恰恰常是那些细节:一个具体的错误码、一个行号、一个版本号、一个配置项的确切写法。摘要还可能引入它自己的幻觉,主 Agent 却没法对照原文去核实。

所以我用摘要时会守两条:

  1. 原文不丢:原始结果存到文件或者缓存里,摘要里附上引用编号,主 Agent 需要细节时可以按编号再去取原文的某一段;

  2. 摘要只用于“导航”,不用于“取证”:摘要告诉它该去哪里看,真正下结论时要看原文。
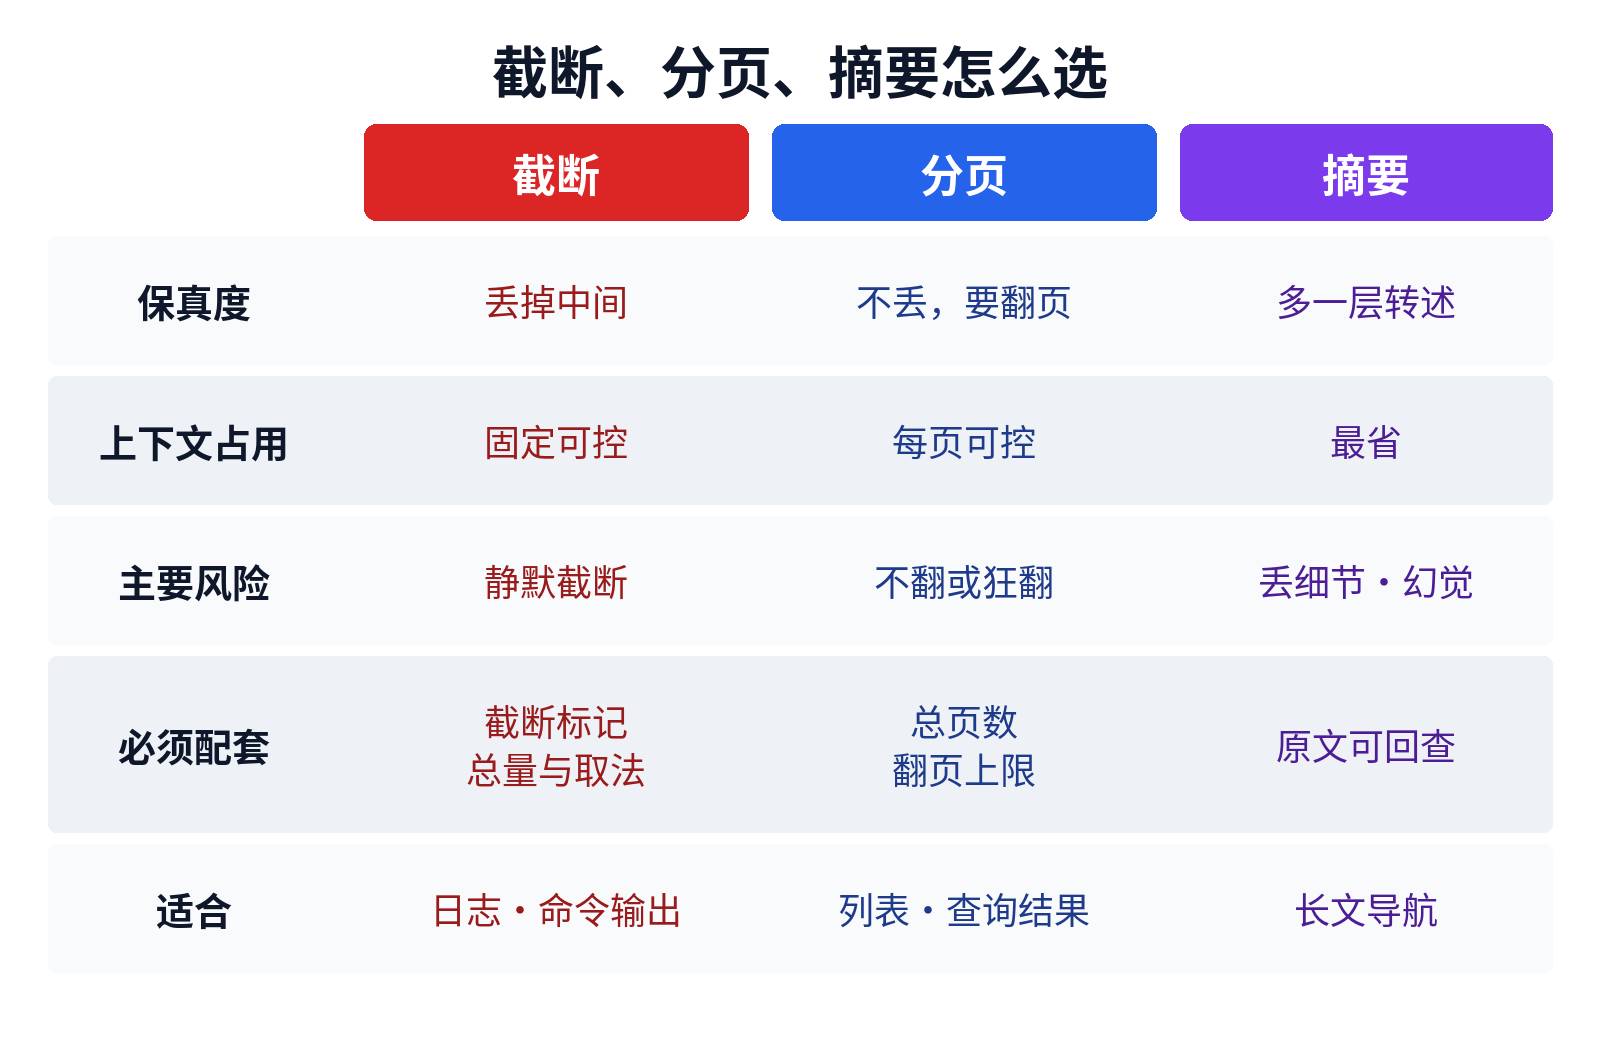
截断、分页、摘要对比:保真度、上下文占用、主要风险、配套措施、适用场景

图:截断、分页、摘要对比:保真度、上下文占用、主要风险、配套措施、适用场景(原创示意图)

我更喜欢的办法:让工具本身会“少说”

三种办法用下来,我越来越觉得,最好的“变短”发生在工具内部,而不是结果出来之后再砍。

也就是说,把过滤能力做进工具参数里:

  • 读文件的工具支持指定行号范围;

  • 搜索工具支持限定目录、文件类型、最大返回条数;

  • 查询工具支持选择字段,而不是总返回整行;

  • 读日志的工具支持按关键字、时间范围、日志级别过滤。

这样模型可以主动问一个更精确的问题,而不是先拿回一大堆再想办法消化。这其实也是我们人自己的工作方式:没人会把几十兆日志从头读到尾,大家都是先 grep。

还有一个很实用的折中:大结果落盘,只返回路径和统计。比如命令输出超过一定长度,就写进一个临时文件,只告诉模型“输出共 12000 行,已保存到某路径,前 20 行如下,可用读文件工具按范围查看”。模型拿到的是一个可以按需探索的入口,而不是一堵墙。

别忘了记一笔:哪些返回被处理过

还有一个容易漏的点:截断、分页、摘要发生过,要在运行记录里留痕。

我在每次工具调用的日志里会多记几个字段:原始长度、实际返回长度、用了哪种处理、是否落盘。复盘一次失败的任务时,这几个字段经常能直接给出答案。比如发现模型下了个错误结论,回头一看,它依据的那次搜索结果被截掉了九成,而它没有再去翻页。这时候该改的不是提示词,而是那个工具的默认返回方式。

怎么选:我的粗糙规则

最后把我的选择习惯整理一下,都是个人经验,不是什么标准:

返回类型 首选 备注
命令输出、构建和测试日志 头尾截断 + 关键字过滤 末尾常有汇总和报错,必须保留
数据库查询、文件列表、搜索命中 分页或 top-k + 总数 按条目切,不在条目中间截断
长网页、长文档 先目录或摘要导航,再按段读原文 摘要只用来找位置
二进制或超大文件 落盘 + 返回路径与统计 不进上下文

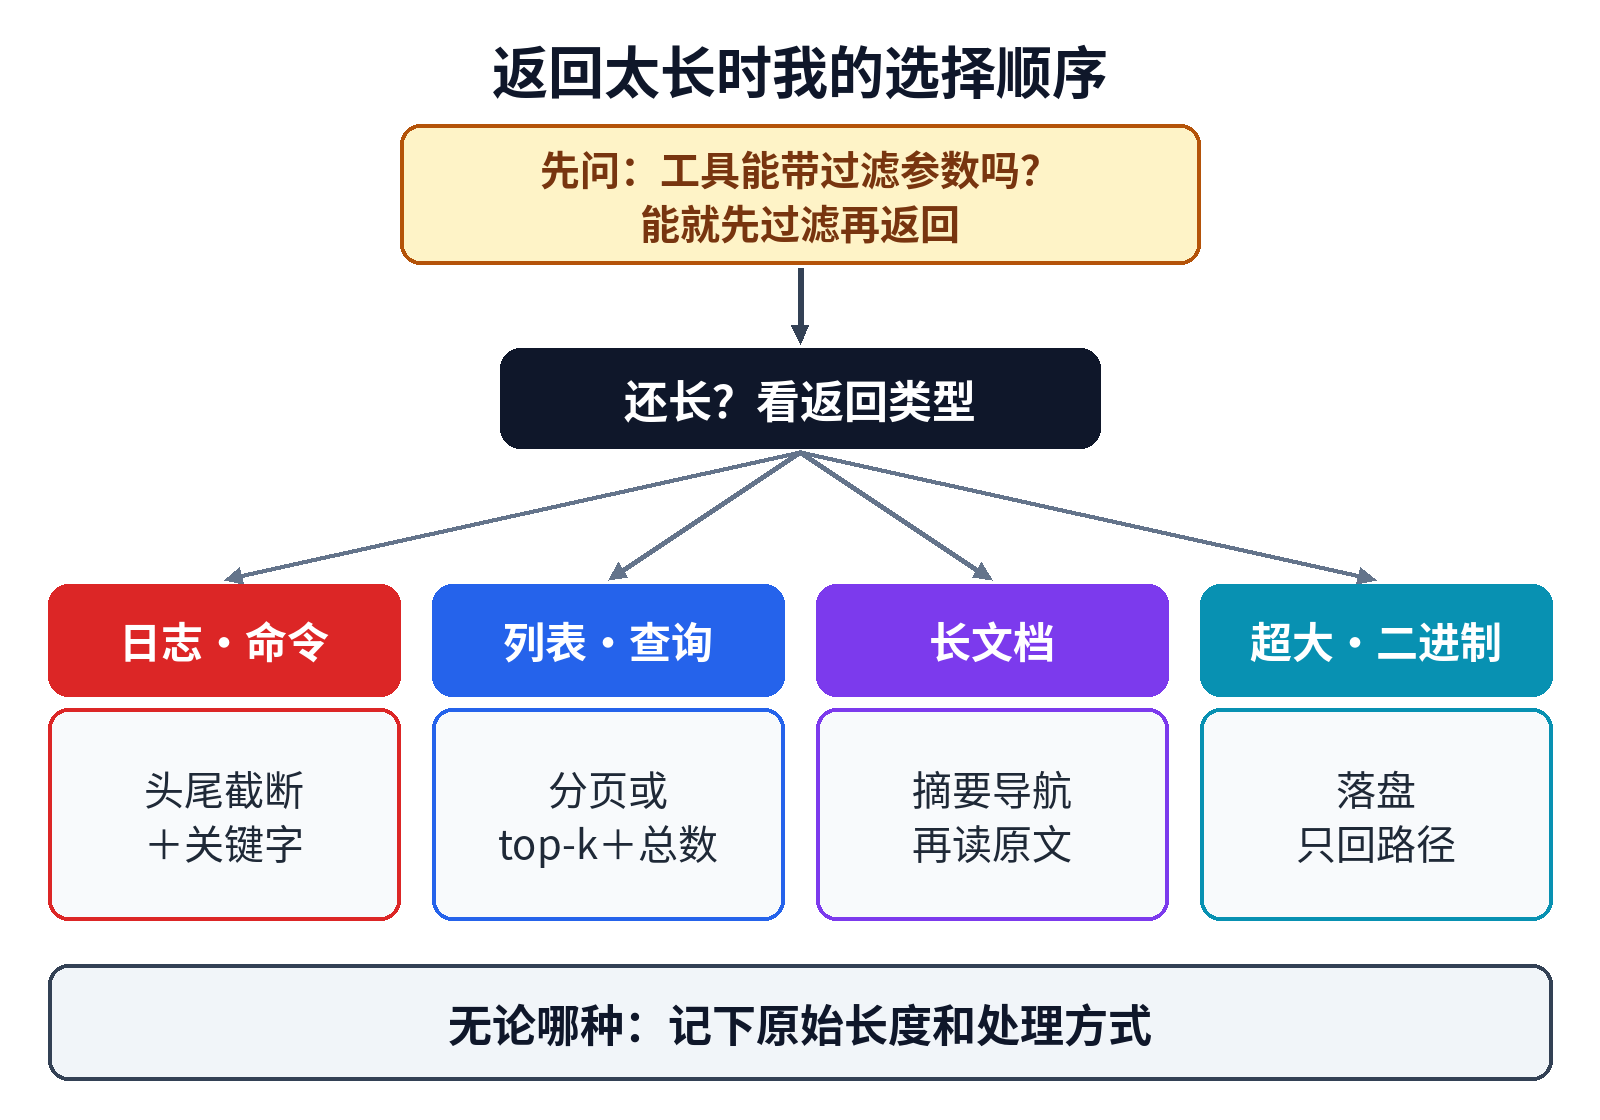
返回太长时的选择顺序:先让工具过滤,再按类型选截断、分页、摘要或落盘

图:返回太长时的选择顺序:先让工具过滤,再按类型选截断、分页、摘要或落盘(原创示意图)

另外给每个工具设一个返回长度预算。具体数字和你用的模型、任务类型有关,我自己是先给一个保守值,再看运行日志里有没有被频繁截断、模型有没有因此反复调用同一个工具,然后逐步调整。

回头看,工具返回这件事,本质上是在回答一个问题:模型需要知道什么,以及它怎么知道自己还不知道什么。截断、分页、摘要都是手段,真正要守住的是后半句——让模型始终清楚自己看到的是全部,还是一部分。只要这一点做到了,具体用哪种办法,反而没那么要紧。

封面照片:Card Filing Cabinet.jpg,作者 Watty62,CC BY-SA 4.0,来自 Wikimedia Commons,加暗色蒙层和标题后使用。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

Agent 的工具返回太长怎么办:截断、分页与摘要的取舍

Agent 的工具返回太长怎么办:截断、分页与摘要的取舍

自己写 Agent 的时候,我最早关心的是工具怎么定义、参数怎么描述、调用失败怎么处理。工具返回什么,反而想得很少:命令跑完了,stdout 拿回来,原样塞进上下文,不就行了?

后来有一次让 Agent 排查一个线上问题,它调了一下读日志的工具。那个日志文件几十兆,工具老老实实全读回来了。结果要么是请求直接超出上下文上限报错,要么是在我加了粗暴截断之后,它看到前面几千行正常日志,得出结论“日志里没有发现异常”。真正的报错在文件末尾,它根本没看到。

这件事让我意识到:工具返回多长、怎么变短,是 Agent 设计里一个独立的问题,而且没有银弹。常见的三种办法——截断、分页、摘要——各有各的代价。这篇聊聊我在这几种之间是怎么取舍的。

为什么不能原样塞回去

先说清楚太长的返回到底伤在哪,不只是“超上限报错”那么简单。

第一是挤掉别的东西。上下文是有限的,一次工具返回占掉一大半,前面的任务说明、用户的约束、之前的推理就会被挤到边缘。按我的体感,上下文塞得越满,模型越容易忘掉早先交代的规矩。这一点我没有严格测过,是自己用下来的感觉。

第二是成本和延迟。每一轮对话都要把历史带上,一次十万字的返回,后面每一步都在为它付钱、等它处理。

第三是注意力被稀释。返回里真正有用的可能只有几行,剩下全是噪音。模型要从一大堆东西里找那几行,找漏的概率并不低。

所以,变短是必须的。问题是怎么变短,以及变短之后模型还知不知道“这不是全部”。

截断:最简单,也最容易骗人

截断就是只保留前 N 个字符或前 N 行。实现成本几乎为零,所以大部分人第一版都这么做,我也是。

截断最大的问题是静默。如果模型不知道结果被截了,它会把看到的部分当成全部。搜索结果被截断,它会说“只找到这几处”;日志被截断,它会说“没有异常”。这比不给结果还糟,因为它会基于错误的“完整信息”做出很自信的判断。

我现在的截断一定带三样东西:

  1. 明确的截断标记:告诉模型“这里省略了多少行”;

  2. 总量信息:原始结果一共多少行、多少字节;

  3. 怎么拿到更多:比如“可以用 offset 参数读取后续内容”,或者“可以用 pattern 参数过滤”。

另外,对日志这类内容,我会头尾都留,而不是只留开头。很多命令的关键信息在末尾:报错堆栈、测试汇总、退出原因。只截开头,恰恰丢掉了最重要的部分。

带标记的头尾截断:保留开头和结尾,中间写明省略多少、怎么取更多

图:带标记的头尾截断:保留开头和结尾,中间写明省略多少、怎么取更多(原创示意图)

写成代码大概是这样,很朴素:

String clip(List<String> lines, int head, int tail) {
    if (lines.size() <= head + tail) return String.join("\n", lines);
    int omitted = lines.size() - head - tail;
    return String.join("\n", lines.subList(0, head))
        + "\n…[已截断:共 " + lines.size() + " 行,省略中间 " + omitted
        + " 行;可用 offset/pattern 参数查看更多]…\n"
        + String.join("\n", lines.subList(lines.size() - tail, lines.size()));
}

还有两个小坑。一是按字符截断时别截在多字节字符或者代理对中间,否则会出现乱码;二是别截断结构化数据。一个 JSON 被从中间砍断,模型拿到的是不合法的 JSON,它可能会自己“脑补”补全,这就更危险了。结构化数据应该按条目截,比如只返回前 50 条,再附上总条数。

分页:保真,但要模型愿意翻页

分页是把结果切成一页一页,每次返回一页,附带下一页的游标或偏移量。和截断相比,它的好处是信息不丢,模型想看都能看到。

但分页把一个决定交给了模型:要不要翻下一页。我观察到两种极端。一种是它看完第一页就下结论,从不翻页,效果和截断差不多;另一种是它一页接一页地翻,翻了二十页还没停,步数和成本都上去了。

我的处理方式是:

分页最适合的是结构化、可排序、条目之间相对独立的数据:数据库查询结果、文件列表、搜索命中列表。对于日志、长文档这类需要上下文连贯的内容,分页的边界会把相关的内容切开,效果就差一些。

摘要:最省上下文,也最不可控

摘要是先用规则或者另一个模型把长结果压缩成短的,再交给主 Agent。比如一个网页读回来几万字,先摘要成几百字的要点。

摘要的问题在于它多了一层转述。摘要模型认为不重要的细节,主 Agent 就永远看不到了。而排查问题时最关键的,恰恰常是那些细节:一个具体的错误码、一个行号、一个版本号、一个配置项的确切写法。摘要还可能引入它自己的幻觉,主 Agent 却没法对照原文去核实。

所以我用摘要时会守两条:

  1. 原文不丢:原始结果存到文件或者缓存里,摘要里附上引用编号,主 Agent 需要细节时可以按编号再去取原文的某一段;

  2. 摘要只用于“导航”,不用于“取证”:摘要告诉它该去哪里看,真正下结论时要看原文。

截断、分页、摘要对比:保真度、上下文占用、主要风险、配套措施、适用场景

图:截断、分页、摘要对比:保真度、上下文占用、主要风险、配套措施、适用场景(原创示意图)

我更喜欢的办法:让工具本身会“少说”

三种办法用下来,我越来越觉得,最好的“变短”发生在工具内部,而不是结果出来之后再砍。

也就是说,把过滤能力做进工具参数里:

这样模型可以主动问一个更精确的问题,而不是先拿回一大堆再想办法消化。这其实也是我们人自己的工作方式:没人会把几十兆日志从头读到尾,大家都是先 grep。

还有一个很实用的折中:大结果落盘,只返回路径和统计。比如命令输出超过一定长度,就写进一个临时文件,只告诉模型“输出共 12000 行,已保存到某路径,前 20 行如下,可用读文件工具按范围查看”。模型拿到的是一个可以按需探索的入口,而不是一堵墙。

别忘了记一笔:哪些返回被处理过

还有一个容易漏的点:截断、分页、摘要发生过,要在运行记录里留痕。

我在每次工具调用的日志里会多记几个字段:原始长度、实际返回长度、用了哪种处理、是否落盘。复盘一次失败的任务时,这几个字段经常能直接给出答案。比如发现模型下了个错误结论,回头一看,它依据的那次搜索结果被截掉了九成,而它没有再去翻页。这时候该改的不是提示词,而是那个工具的默认返回方式。

怎么选:我的粗糙规则

最后把我的选择习惯整理一下,都是个人经验,不是什么标准:

返回类型 首选 备注
命令输出、构建和测试日志 头尾截断 + 关键字过滤 末尾常有汇总和报错,必须保留
数据库查询、文件列表、搜索命中 分页或 top-k + 总数 按条目切,不在条目中间截断
长网页、长文档 先目录或摘要导航,再按段读原文 摘要只用来找位置
二进制或超大文件 落盘 + 返回路径与统计 不进上下文

返回太长时的选择顺序:先让工具过滤,再按类型选截断、分页、摘要或落盘

图:返回太长时的选择顺序:先让工具过滤,再按类型选截断、分页、摘要或落盘(原创示意图)

另外给每个工具设一个返回长度预算。具体数字和你用的模型、任务类型有关,我自己是先给一个保守值,再看运行日志里有没有被频繁截断、模型有没有因此反复调用同一个工具,然后逐步调整。

回头看,工具返回这件事,本质上是在回答一个问题:模型需要知道什么,以及它怎么知道自己还不知道什么。截断、分页、摘要都是手段,真正要守住的是后半句——让模型始终清楚自己看到的是全部,还是一部分。只要这一点做到了,具体用哪种办法,反而没那么要紧。

封面照片:Card Filing Cabinet.jpg,作者 Watty62,CC BY-SA 4.0,来自 Wikimedia Commons,加暗色蒙层和标题后使用。


Agent 的工具返回太长怎么办:截断、分页与摘要的取舍2026-10-16鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论