让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西

  created  by  鱼鱼 {{tag}}
创建于 2026年10月16日 09:36:21 最后修改于 2026年10月16日 09:36:21

组里有不少“历史脚本”:某个同事几年前用 Python 写的数据清洗、对账、报表生成,跑在一台机器的定时任务里,没人敢动。最近要把其中几个并进 Java 服务,统一部署、统一监控。这种活交给 AI 再合适不过了:输入输出都明确,代码量不大,几百行 Python,它几分钟就能吐出一份结构工整的 Java。

第一份迁移我差点直接合进去。代码能编译,单测能过,命名比原脚本还讲究。后来是跑了一遍真实数据对比,才发现有几十行结果和老脚本对不上。查下来,没有一处是“写错了”,全是两门语言默认行为不一样,AI 按字面翻译了语法,却没翻译语义。

这篇整理一下我踩到的这些差异,以及现在怎么让 AI 做迁移才比较放心。

语法好翻,语义难翻

AI 做跨语言改写,有点像一个语法很好但没在对方国家生活过的翻译。for 循环变成 for,dict 变成 Map,list 变成 List,一一对应,看着毫无破绽。

问题在于,Python 和 Java 里很多“看起来一样”的操作,默认行为并不一样。这些差异平时不显眼,只在特定数据上才冒头:负数、超大数、空集合、特殊字符、恰好在 0.5 上的数。而历史脚本之所以历史,就是因为它在真实数据上跑了好几年,那些特殊数据它早就见过了。

我实际踩到的几类差异

整数除法和取模。Python 的 // 是向下取整,-7 // 2 得 -4;Java 的 / 是向零截断,-7 / 2 得 -3。取模也一样,Python 里 -7 % 2 是 1,Java 里是 -1。老脚本里有一段按金额差值分桶的逻辑,正数完全一致,负数全部错一格。Java 里要用 Math.floorDiv 和 Math.floorMod 才能对上。

四舍五入。Python 3 的 round 是“银行家舍入”,恰好在 .5 上时取偶数,round(2.5) 得 2;Java 的 Math.round(2.5) 得 3。报表里的汇总金额就差在这些边上。要对齐得用 BigDecimal 加明确的舍入模式,而且要先搞清楚老脚本到底是有意为之还是碰巧。

整数溢出。Python 的整数没有上限,Java 的 int 超了会悄悄回绕成负数。AI 很习惯把计数、累加都写成 int,大部分时候没事,碰上大批量累加就出怪数。我现在会要求累加一律用 long,金额用 BigDecimal,必要时用 Math.addExact 让溢出直接抛异常。

字典顺序。从 3.7 开始,Python 的 dict 保证按插入顺序迭代。老脚本输出 CSV 的列顺序就依赖这一点。AI 改成 HashMap 之后,列顺序变得不可预测,下游按列位置读数据的程序就乱了。换成 LinkedHashMap 就好,但你得知道要换。
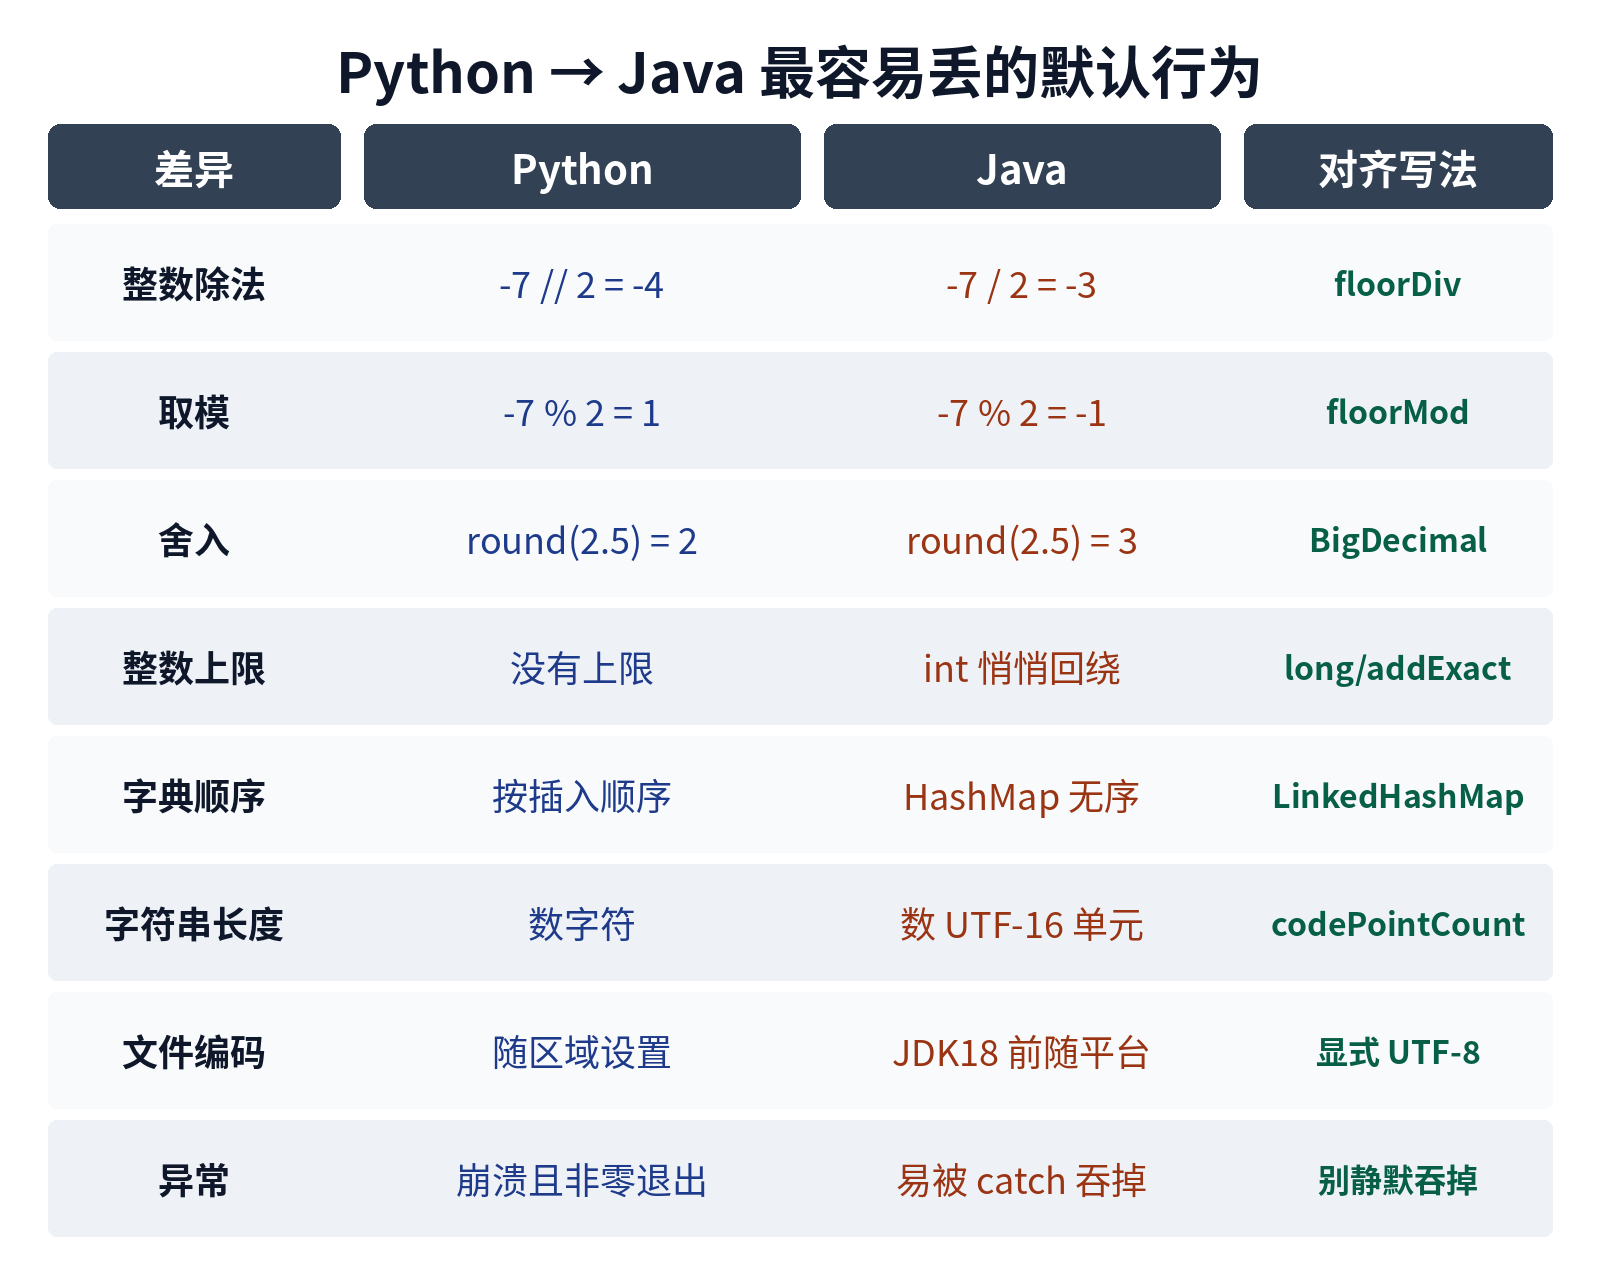
Python 与 Java 默认行为差异对照:除法取模、舍入、溢出、字典顺序、字符串长度、编码、异常

图:Python 与 Java 默认行为差异对照:除法取模、舍入、溢出、字典顺序、字符串长度、编码、异常(原创示意图)

字符串长度。Python 的 len 数的是字符(码点),Java 的 String.length() 数的是 UTF-16 单元。遇到表情符号或者一些生僻字,Java 会多数一个。老脚本里有按长度截断备注字段的逻辑,迁移后偶尔会把一个字截成两半,产生乱码。

真值判断。Python 里 if items: 同时排除了 None 和空列表。AI 翻成 Java 时,有时写成 items != null,空列表就混进去了;有时写成 !items.isEmpty(),碰到 null 直接空指针。这类代码要逐个看原意。

文件编码。Python 里不指定编码的 open() 会用系统的区域设置;Java 在 JDK 18 之前默认字符集也跟平台走,之后默认改成了 UTF-8。老脚本跑在一台默认编码不是 UTF-8 的老机器上,迁移后读同一个文件,中文全乱了。我现在一律要求显式写出编码,两边都写。

异常和退出码。老脚本出错直接抛异常、带着堆栈退出,定时任务看到非零退出码就会告警。AI 改写时很喜欢包一层 try-catch,打印日志然后继续。看起来更“健壮”,实际上把失败变成了静默成功,告警再也不会响。

第一步:先要差异清单,再要代码

踩过这些坑之后,我现在不会一上来就说“把这个脚本改写成 Java”。第一步是:

这是一个 Python 3 脚本,要迁移成 Java 17。
先不要写代码。请逐个列出脚本中依赖 Python 默认行为、
在 Java 中行为可能不同的地方:整数运算、舍入、字典顺序、
字符串长度与编码、真值判断、异常与退出码、正则匹配方式、
日期时间与时区。每条给出所在行号和你建议的 Java 写法。

这份清单比代码本身更有价值。它的作用不是保证 AI 全都找到,而是逼它在写代码之前,先把“语义”这件事过一遍。我会对着清单逐条确认,有些差异其实无所谓(比如日志格式),有些必须严格对齐(比如金额舍入)。确认过的清单再作为约束发回去,让它按清单写代码。

正则顺便提一句:Python 的 re.match 只锚定开头,re.search 是找子串;Java 的 matches() 要求整串匹配,find() 才是找子串。三种行为两两不同,AI 翻错的概率不小。

第二步:对拍,别只靠单元测试

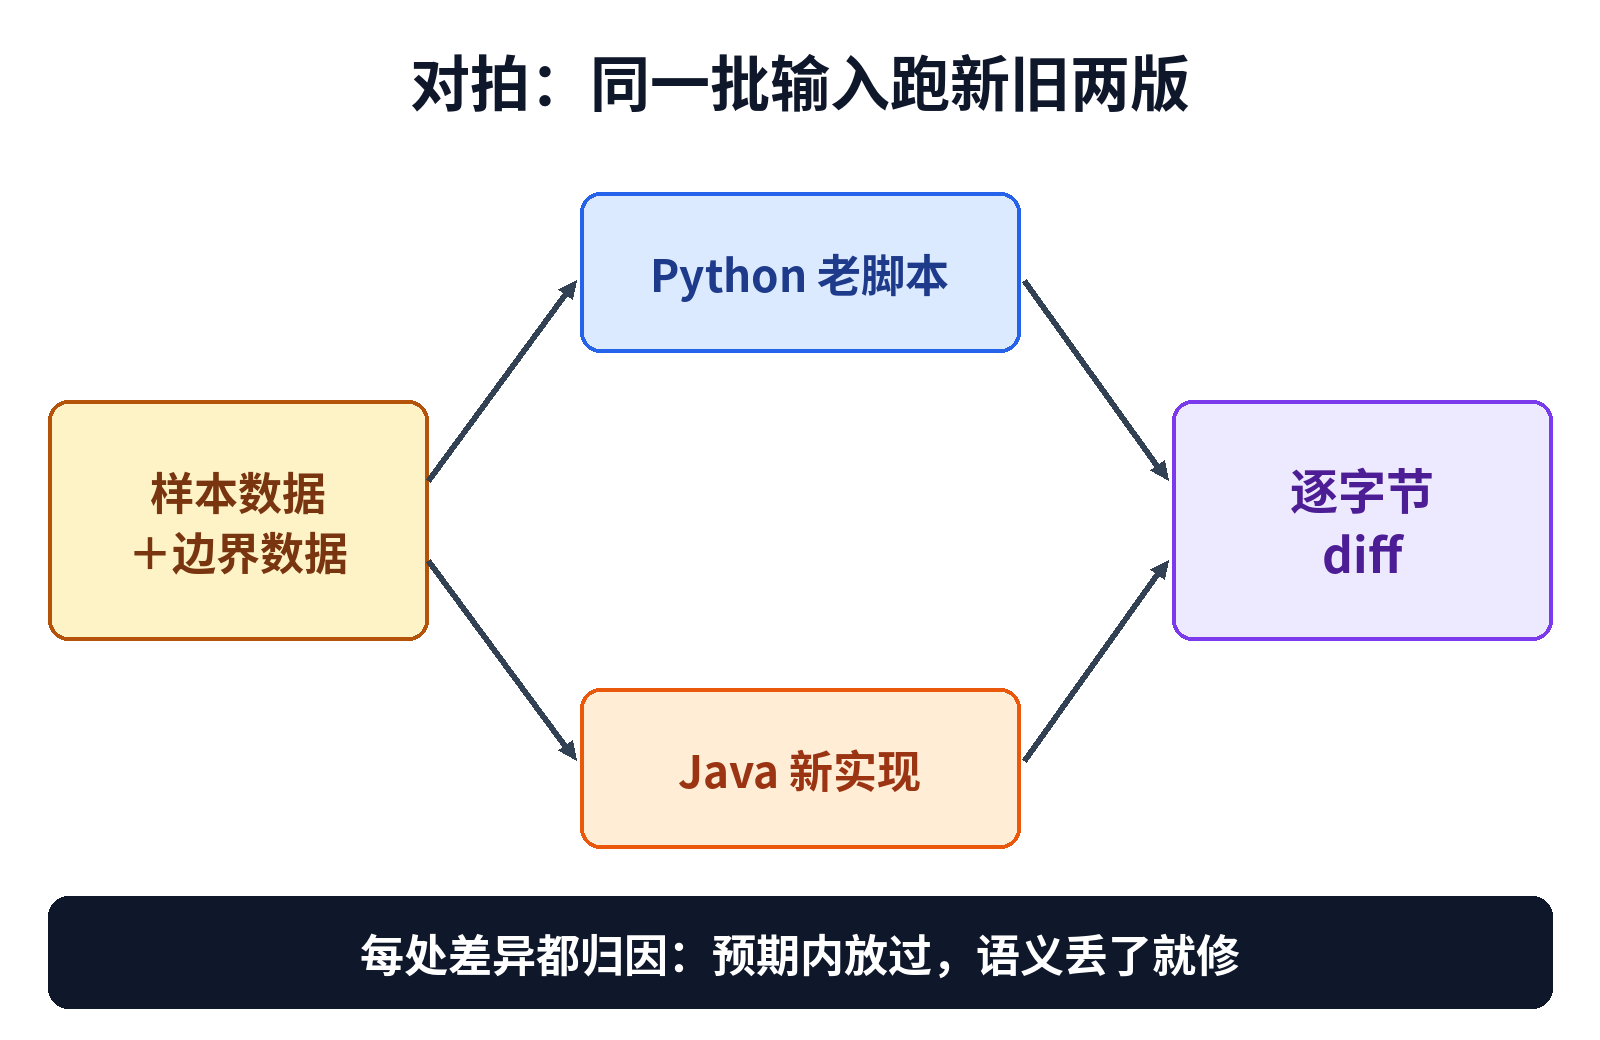
单元测试是 AI 自己写的,它理解错了语义,测试也会跟着错,一起绿。迁移类的任务,我最信任的验证方式是对拍:同一批输入,老脚本跑一遍,新 Java 跑一遍,输出逐字节比较。

具体做法很土:

  1. 从生产数据里抽一批样本,再手工补一些边界数据:负数、零、空字段、超长字段、表情符号、恰好 .5 的金额;

  2. 用老 Python 脚本跑出结果,存成“标准答案”;

  3. Java 版跑同样的输入,输出 diff;

  4. 每一处差异都要归因:是预期内的(比如浮点数打印格式),还是语义丢了。

对拍流程:同一批输入跑新旧两版,逐字节 diff 后逐条归因

图:对拍流程:同一批输入跑新旧两版,逐字节 diff 后逐条归因(原创示意图)

浮点数打印格式是个典型的“预期内差异”:Python 打印 1e16 得到 1e+16,Java 的 Double.toString 得到 1.0E16。如果输出是给程序读的,这也得对齐;如果只是给人看的日志,可以放过。关键是每一处都要有人看过、做过决定,而不是“差不多就行”。

对拍的另一个好处是,它能发现连差异清单都没想到的问题。我那次清单里漏了编码,就是对拍时一眼看出中文乱码才补上的。

依赖库也要“迁移”,不只是语法

还有一类问题藏在 import 里。老脚本用了 Python 标准库的 csv、datetime,或者第三方的表格处理库,AI 改写时需要在 Java 这边找对应物。它常常会顺手引入一个新的第三方库,名字听着都很合理。

这里我有两条要求。第一,优先用 JDK 自带的东西和项目里已经有的依赖,新增依赖必须单独列出来,说明理由,我去核实这个库真实存在、还在维护、许可证没问题之后再加。第二,库换了,默认行为也可能换:CSV 库对引号和换行的处理、日期库对时区的默认假设,都可能和老脚本用的库不同。这些也要进差异清单,也要靠对拍兜底。

第三步:先等价,再优雅

AI 迁移代码还有一个习惯:顺手优化。它会把老脚本里的笨循环改成 Stream,把几个函数合并,把它认为多余的判断删掉。每一项单看都是改进,合在一起,就很难判断差异来自哪里了。

我现在明确把迁移拆成两个阶段:

  • 第一阶段,只求等价。结构尽量贴着原脚本,函数一一对应,连变量名都尽量保留。不准删判断,不准合并逻辑,看着再丑也先忍着。目标是对拍零差异。

  • 第二阶段,再谈重构。对拍跑通之后,对拍数据就成了回归测试。这时候再让 AI 改成地道的 Java 写法,每改一步重新对拍一次。
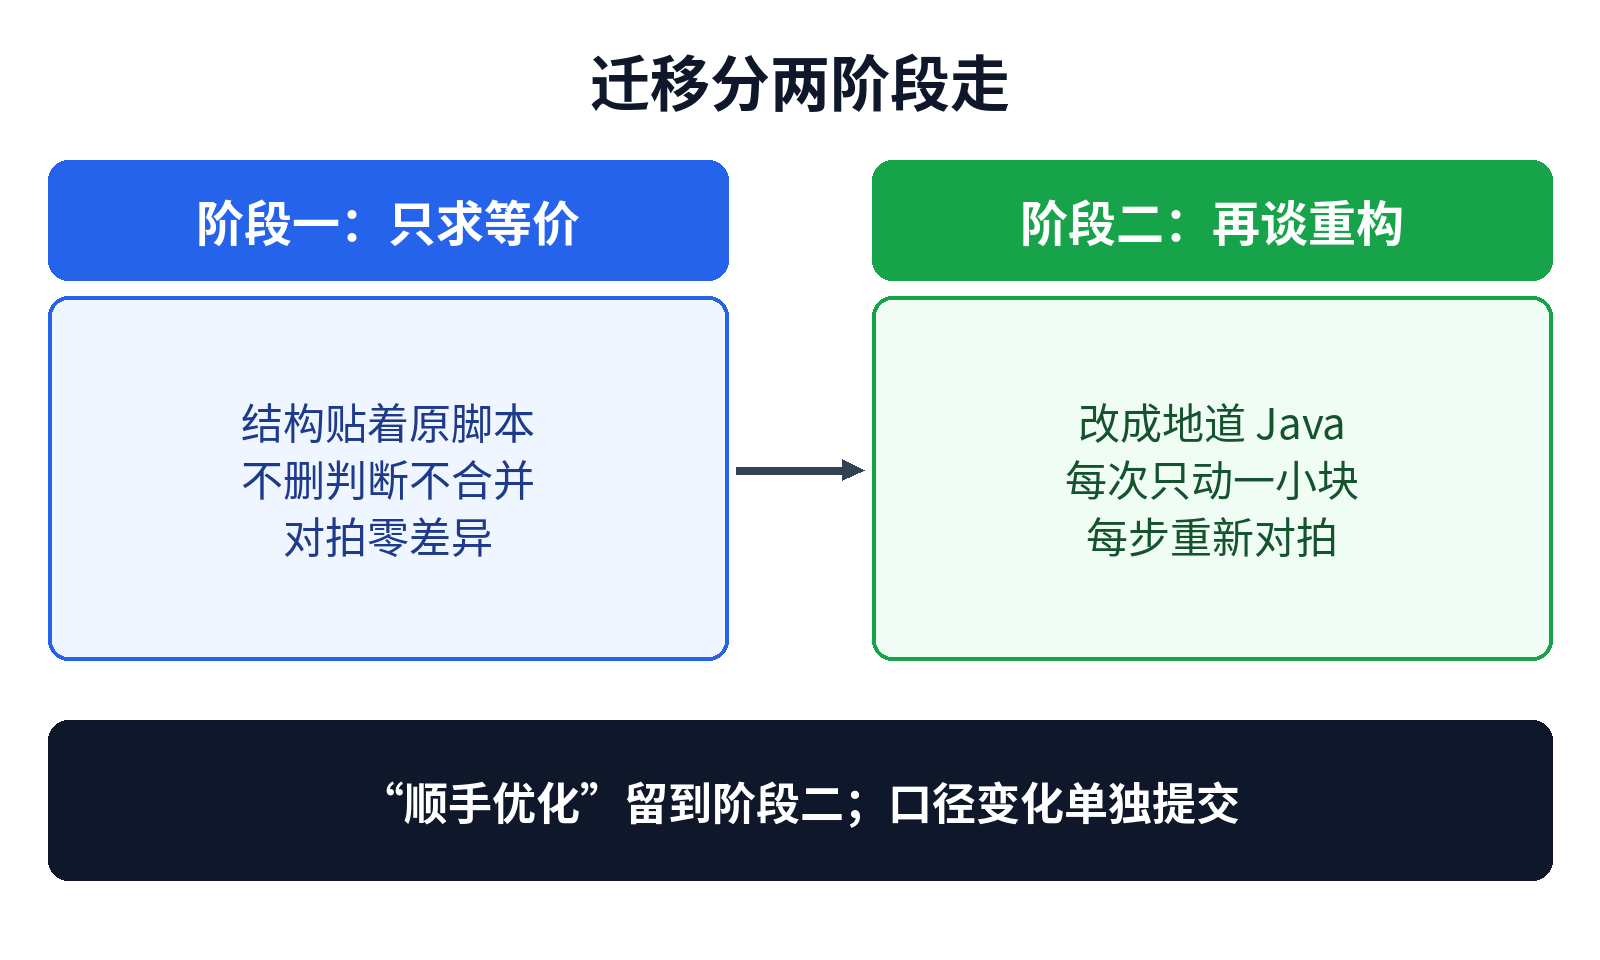
迁移分两阶段:先只求等价,再谈重构,每步重新对拍

图:迁移分两阶段:先只求等价,再谈重构,每步重新对拍(原创示意图)

这个节奏比一步到位慢一点,但出问题时定位快得多。以前一份“又对又漂亮”的迁移,出了差异我得在几百行里猜;现在第一阶段的代码几乎能逐行对照原脚本,第二阶段每次只动一小块。

那些说不清的“原意”

最后说一个 AI 帮不上太多忙的部分:原脚本里有些写法到底是不是有意的。

比如那个银行家舍入,究竟是当年业务要求如此,还是作者根本不知道 round 的行为?AI 会给出两种写法,但没法替你判断哪个才对。我的做法是:默认保持和老脚本一致,因为下游已经按这个结果跑了好几年;同时把疑点列出来,找业务方确认,确认完再决定要不要改,改也要单独提交、单独说明。

迁移最怕的不是新代码有问题,而是新代码“修好”了一个老问题,却没人知道。下游对账突然对不上,大家要查很久才能发现,原来是迁移顺手改了口径。

说到底,让 AI 改写语言是一件很划算的事,它省掉了大量体力活。但体力活之外的那部分,语义对不对、原意是什么、差异要不要保留,还是得我自己一条条过。差异清单和对拍,就是我给自己留的两道闸。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西

让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西

组里有不少“历史脚本”:某个同事几年前用 Python 写的数据清洗、对账、报表生成,跑在一台机器的定时任务里,没人敢动。最近要把其中几个并进 Java 服务,统一部署、统一监控。这种活交给 AI 再合适不过了:输入输出都明确,代码量不大,几百行 Python,它几分钟就能吐出一份结构工整的 Java。

第一份迁移我差点直接合进去。代码能编译,单测能过,命名比原脚本还讲究。后来是跑了一遍真实数据对比,才发现有几十行结果和老脚本对不上。查下来,没有一处是“写错了”,全是两门语言默认行为不一样,AI 按字面翻译了语法,却没翻译语义。

这篇整理一下我踩到的这些差异,以及现在怎么让 AI 做迁移才比较放心。

语法好翻,语义难翻

AI 做跨语言改写,有点像一个语法很好但没在对方国家生活过的翻译。for 循环变成 for,dict 变成 Map,list 变成 List,一一对应,看着毫无破绽。

问题在于,Python 和 Java 里很多“看起来一样”的操作,默认行为并不一样。这些差异平时不显眼,只在特定数据上才冒头:负数、超大数、空集合、特殊字符、恰好在 0.5 上的数。而历史脚本之所以历史,就是因为它在真实数据上跑了好几年,那些特殊数据它早就见过了。

我实际踩到的几类差异

整数除法和取模。Python 的 // 是向下取整,-7 // 2 得 -4;Java 的 / 是向零截断,-7 / 2 得 -3。取模也一样,Python 里 -7 % 2 是 1,Java 里是 -1。老脚本里有一段按金额差值分桶的逻辑,正数完全一致,负数全部错一格。Java 里要用 Math.floorDiv 和 Math.floorMod 才能对上。

四舍五入。Python 3 的 round 是“银行家舍入”,恰好在 .5 上时取偶数,round(2.5) 得 2;Java 的 Math.round(2.5) 得 3。报表里的汇总金额就差在这些边上。要对齐得用 BigDecimal 加明确的舍入模式,而且要先搞清楚老脚本到底是有意为之还是碰巧。

整数溢出。Python 的整数没有上限,Java 的 int 超了会悄悄回绕成负数。AI 很习惯把计数、累加都写成 int,大部分时候没事,碰上大批量累加就出怪数。我现在会要求累加一律用 long,金额用 BigDecimal,必要时用 Math.addExact 让溢出直接抛异常。

字典顺序。从 3.7 开始,Python 的 dict 保证按插入顺序迭代。老脚本输出 CSV 的列顺序就依赖这一点。AI 改成 HashMap 之后,列顺序变得不可预测,下游按列位置读数据的程序就乱了。换成 LinkedHashMap 就好,但你得知道要换。

Python 与 Java 默认行为差异对照:除法取模、舍入、溢出、字典顺序、字符串长度、编码、异常

图:Python 与 Java 默认行为差异对照:除法取模、舍入、溢出、字典顺序、字符串长度、编码、异常(原创示意图)

字符串长度。Python 的 len 数的是字符(码点),Java 的 String.length() 数的是 UTF-16 单元。遇到表情符号或者一些生僻字,Java 会多数一个。老脚本里有按长度截断备注字段的逻辑,迁移后偶尔会把一个字截成两半,产生乱码。

真值判断。Python 里 if items: 同时排除了 None 和空列表。AI 翻成 Java 时,有时写成 items != null,空列表就混进去了;有时写成 !items.isEmpty(),碰到 null 直接空指针。这类代码要逐个看原意。

文件编码。Python 里不指定编码的 open() 会用系统的区域设置;Java 在 JDK 18 之前默认字符集也跟平台走,之后默认改成了 UTF-8。老脚本跑在一台默认编码不是 UTF-8 的老机器上,迁移后读同一个文件,中文全乱了。我现在一律要求显式写出编码,两边都写。

异常和退出码。老脚本出错直接抛异常、带着堆栈退出,定时任务看到非零退出码就会告警。AI 改写时很喜欢包一层 try-catch,打印日志然后继续。看起来更“健壮”,实际上把失败变成了静默成功,告警再也不会响。

第一步:先要差异清单,再要代码

踩过这些坑之后,我现在不会一上来就说“把这个脚本改写成 Java”。第一步是:

这是一个 Python 3 脚本,要迁移成 Java 17。
先不要写代码。请逐个列出脚本中依赖 Python 默认行为、
在 Java 中行为可能不同的地方:整数运算、舍入、字典顺序、
字符串长度与编码、真值判断、异常与退出码、正则匹配方式、
日期时间与时区。每条给出所在行号和你建议的 Java 写法。

这份清单比代码本身更有价值。它的作用不是保证 AI 全都找到,而是逼它在写代码之前,先把“语义”这件事过一遍。我会对着清单逐条确认,有些差异其实无所谓(比如日志格式),有些必须严格对齐(比如金额舍入)。确认过的清单再作为约束发回去,让它按清单写代码。

正则顺便提一句:Python 的 re.match 只锚定开头,re.search 是找子串;Java 的 matches() 要求整串匹配,find() 才是找子串。三种行为两两不同,AI 翻错的概率不小。

第二步:对拍,别只靠单元测试

单元测试是 AI 自己写的,它理解错了语义,测试也会跟着错,一起绿。迁移类的任务,我最信任的验证方式是对拍:同一批输入,老脚本跑一遍,新 Java 跑一遍,输出逐字节比较。

具体做法很土:

  1. 从生产数据里抽一批样本,再手工补一些边界数据:负数、零、空字段、超长字段、表情符号、恰好 .5 的金额;

  2. 用老 Python 脚本跑出结果,存成“标准答案”;

  3. Java 版跑同样的输入,输出 diff;

  4. 每一处差异都要归因:是预期内的(比如浮点数打印格式),还是语义丢了。

对拍流程:同一批输入跑新旧两版,逐字节 diff 后逐条归因

图:对拍流程:同一批输入跑新旧两版,逐字节 diff 后逐条归因(原创示意图)

浮点数打印格式是个典型的“预期内差异”:Python 打印 1e16 得到 1e+16,Java 的 Double.toString 得到 1.0E16。如果输出是给程序读的,这也得对齐;如果只是给人看的日志,可以放过。关键是每一处都要有人看过、做过决定,而不是“差不多就行”。

对拍的另一个好处是,它能发现连差异清单都没想到的问题。我那次清单里漏了编码,就是对拍时一眼看出中文乱码才补上的。

依赖库也要“迁移”,不只是语法

还有一类问题藏在 import 里。老脚本用了 Python 标准库的 csv、datetime,或者第三方的表格处理库,AI 改写时需要在 Java 这边找对应物。它常常会顺手引入一个新的第三方库,名字听着都很合理。

这里我有两条要求。第一,优先用 JDK 自带的东西和项目里已经有的依赖,新增依赖必须单独列出来,说明理由,我去核实这个库真实存在、还在维护、许可证没问题之后再加。第二,库换了,默认行为也可能换:CSV 库对引号和换行的处理、日期库对时区的默认假设,都可能和老脚本用的库不同。这些也要进差异清单,也要靠对拍兜底。

第三步:先等价,再优雅

AI 迁移代码还有一个习惯:顺手优化。它会把老脚本里的笨循环改成 Stream,把几个函数合并,把它认为多余的判断删掉。每一项单看都是改进,合在一起,就很难判断差异来自哪里了。

我现在明确把迁移拆成两个阶段:

迁移分两阶段:先只求等价,再谈重构,每步重新对拍

图:迁移分两阶段:先只求等价,再谈重构,每步重新对拍(原创示意图)

这个节奏比一步到位慢一点,但出问题时定位快得多。以前一份“又对又漂亮”的迁移,出了差异我得在几百行里猜;现在第一阶段的代码几乎能逐行对照原脚本,第二阶段每次只动一小块。

那些说不清的“原意”

最后说一个 AI 帮不上太多忙的部分:原脚本里有些写法到底是不是有意的。

比如那个银行家舍入,究竟是当年业务要求如此,还是作者根本不知道 round 的行为?AI 会给出两种写法,但没法替你判断哪个才对。我的做法是:默认保持和老脚本一致,因为下游已经按这个结果跑了好几年;同时把疑点列出来,找业务方确认,确认完再决定要不要改,改也要单独提交、单独说明。

迁移最怕的不是新代码有问题,而是新代码“修好”了一个老问题,却没人知道。下游对账突然对不上,大家要查很久才能发现,原来是迁移顺手改了口径。

说到底,让 AI 改写语言是一件很划算的事,它省掉了大量体力活。但体力活之外的那部分,语义对不对、原意是什么、差异要不要保留,还是得我自己一条条过。差异清单和对拍,就是我给自己留的两道闸。


让 AI 把 Python 脚本改写成 Java:跨语言迁移时它最容易丢的东西2026-10-16鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论