

正则大概是我最早放心交给 AI 的活。原因很简单:我自己写正则也是边查边试,每次写完都不太敢相信它。AI 张口就来,还附带逐段解释,看上去比我靠谱多了。
用了一阵之后我发现,AI 写的正则有个很稳定的特点:它几乎总能匹配上你给的例子。问题是,正则真正出事的地方从来不在“该匹配的没匹配上”,而在“不该匹配的也匹配上了”。而后者,你不主动问,它不会告诉你。
所以我现在有个死规矩:让 AI 写正则,先别要正则,先要反例。
一个让我长记性的小事故
那次是要从一堆构建日志里提取版本号,格式是“主版本.次版本.修订号”。我给了 AI 三个例子,它很快给出 \d+\.\d+\.\d+,解释也清清楚楚。我跑了一下,三个例子全中,就提交了。
后来排查一个统计数据不对的问题,才发现日志里还有 IP 地址,形如四段数字,这个正则在 IP 里也能“找到”一个版本号。还有带前缀的 v1.2.3-rc1,它截出了中间一截当成正式版本。这些情况我给的三个例子里都没有,AI 自然也没考虑。
这个事故不大,修起来也就十分钟,但它让我意识到一个问题:我当时“验证”正则的方式,就是拿 AI 给我的解释和我给它的例子互相印证。例子是我挑的,解释是它按例子讲的,两边自然严丝合缝。这种验证其实什么也没验证,只是让我更安心了。
说到底,正则描述的是一个集合:哪些字符串在里面,哪些在外面。我只给了“里面”的几个点,边界在哪,全靠模型猜。它猜的是最常见、最宽松的那种边界。
先要正例、反例、存疑三张表
现在我的第一句提示词通常是这样的:
我要一个 Java 正则,用途:校验用户输入的语义化版本号。
先不要写正则。请先列出:
1. 10 个应该匹配的字符串;
2. 10 个看起来很像、但不应该匹配的字符串,并说明为什么不该匹配;
3. 5 个你拿不准、需要我决定的边界情况。
这三张表比正则本身有价值得多。尤其是第三张,它经常会问出我自己都没想过的问题:前导零 01.2.3 算不算?带 v 前缀要不要?1.2.3-beta 这种预发布后缀接不接受?数字有没有长度上限?
这些问题本质上是需求问题,不是正则问题。我拍板之后,正则怎么写反而是小事。以前我跳过这一步,相当于把需求决策悄悄外包给了模型,而它会用“最常见的写法”替我做决定。
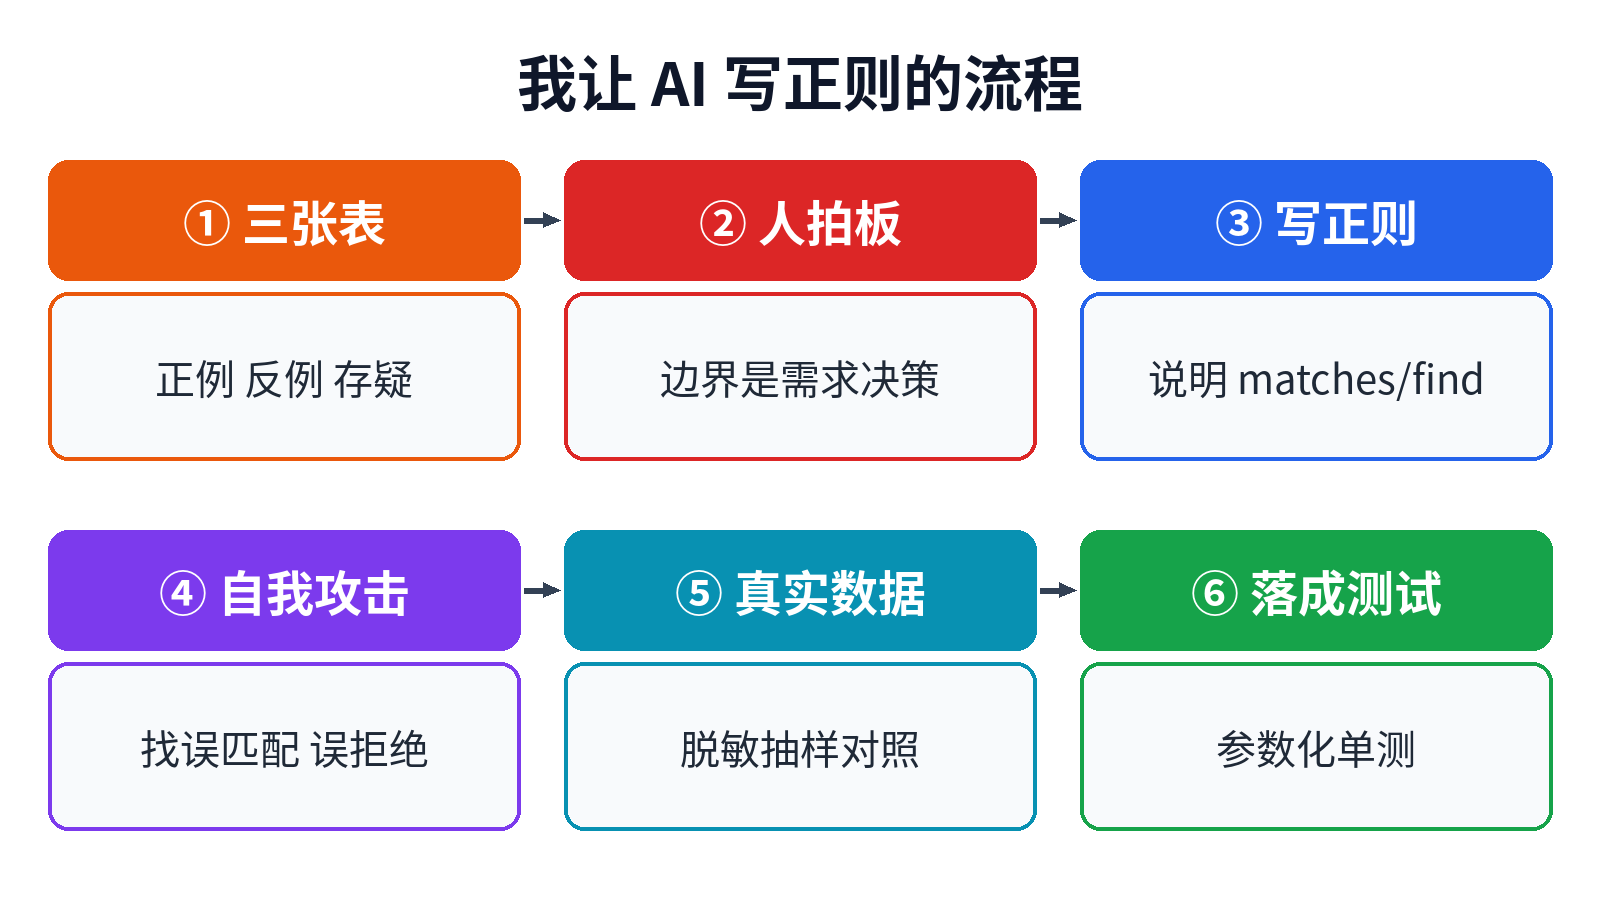
图:让 AI 写正则的流程:三张表、人拍板、写正则、自我攻击、真实数据、落成测试(原创示意图)
再让它攻击自己的正则
正则写出来之后,我会追加一句:“请给出 5 个会被这个正则误匹配、或者误拒绝的字符串。”
这一步是让它换个立场。写正则时它在想“怎么匹配上”,攻击时它在想“怎么钻空子”。很多问题在这一步才暴露出来:没加锚点,前后能混进别的字符;用了 .*,一行里能吞掉太多;字符类写宽了,全角数字或者别的符号也能混进来。
我还会再补一刀:把手头真实数据随便抽几十行(敏感信息先脱敏)丢给它,让它标出哪些行会被匹配、匹配到的是哪一段,然后我自己实际跑一遍对照。真实数据里的脏东西,永远比我们想象的多。
当然,它攻击自己也不一定攻得全。但每多找出一个漏洞,就少一个上线后才发现的问题。我的经验是这一步大概有一半的时候能找出点东西,性价比很高。
几个高频翻车点
把我遇到最多的几类问题列一下,基本都和“边界”有关:
| 翻车点 | 典型表现 | 我的处理 |
|---|---|---|
| 没有锚点 | 用 find 时子串也算匹配 | 校验场景用 matches,或显式加 ^ 和 $ |
贪婪的 .* |
一行里吞掉多个字段 | 改用否定字符类,如 [^,]* |
\d 的范围 |
不同语言含义不同 | 明确写 [0-9],别依赖默认 |
| 字符串转义 | Java 里反斜杠要写两遍 | 让 AI 同时给出正则原文和 Java 字面量 |
| 嵌套量词 | 某些输入下回溯爆炸,CPU 打满 | 避免 (x+)+ 这类结构,用长输入压测 |
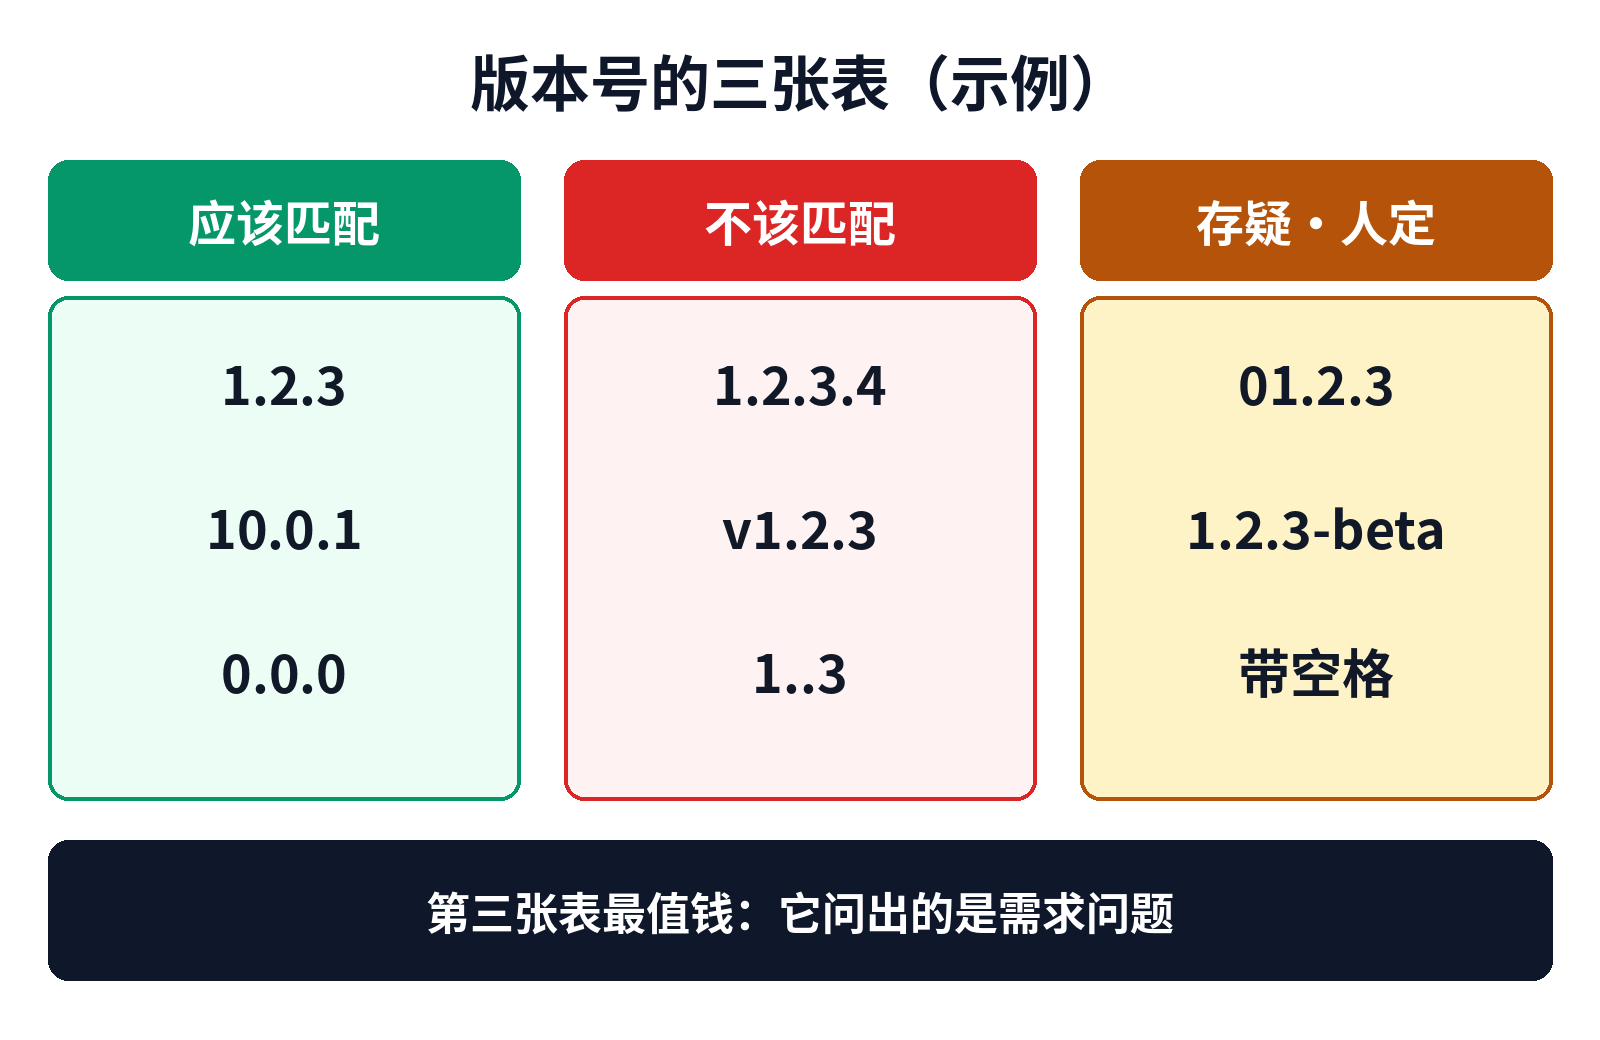
图:版本号的三张表示例:应该匹配、不该匹配、存疑由人定(原创示意图)
其中 \d 这条值得多说一句。Java 默认的 \d 只匹配 ASCII 数字,开了 Unicode 字符类标志才会扩展;而 Python 3 对字符串默认就按 Unicode 处理,\d 能匹配其他文字体系里的数字。如果你让 AI 把一段 Python 里的正则搬到 Java,或者反过来,同一个 \d 行为就不一样了。所以我现在校验类的正则一律写 [0-9],不给自己留歧义。
还有 $。Java 和 Python 里,$ 默认都允许匹配在末尾那个换行符之前。用 find 去校验输入时,"123\n" 是可能被 ^\d+$ 放过的。要严格到字符串真正的结尾,Java 里可以用 \z。这种细节我自己记不住,但我会让 AI 在“存疑表”里把它列出来。
Java 里 matches 和 find 不是一回事
写 Java 的同学要特别注意这一点,我见过好几次 AI 给的正则本身没问题,是调用方式用错了。
String.matches() 和 Matcher.matches() 要求整个字符串都匹配,相当于自动加了首尾锚点;Matcher.find() 只要求字符串里某一段匹配。AI 解释正则时经常默认是整体匹配,结果代码里用的是 find,校验就形同虚设。
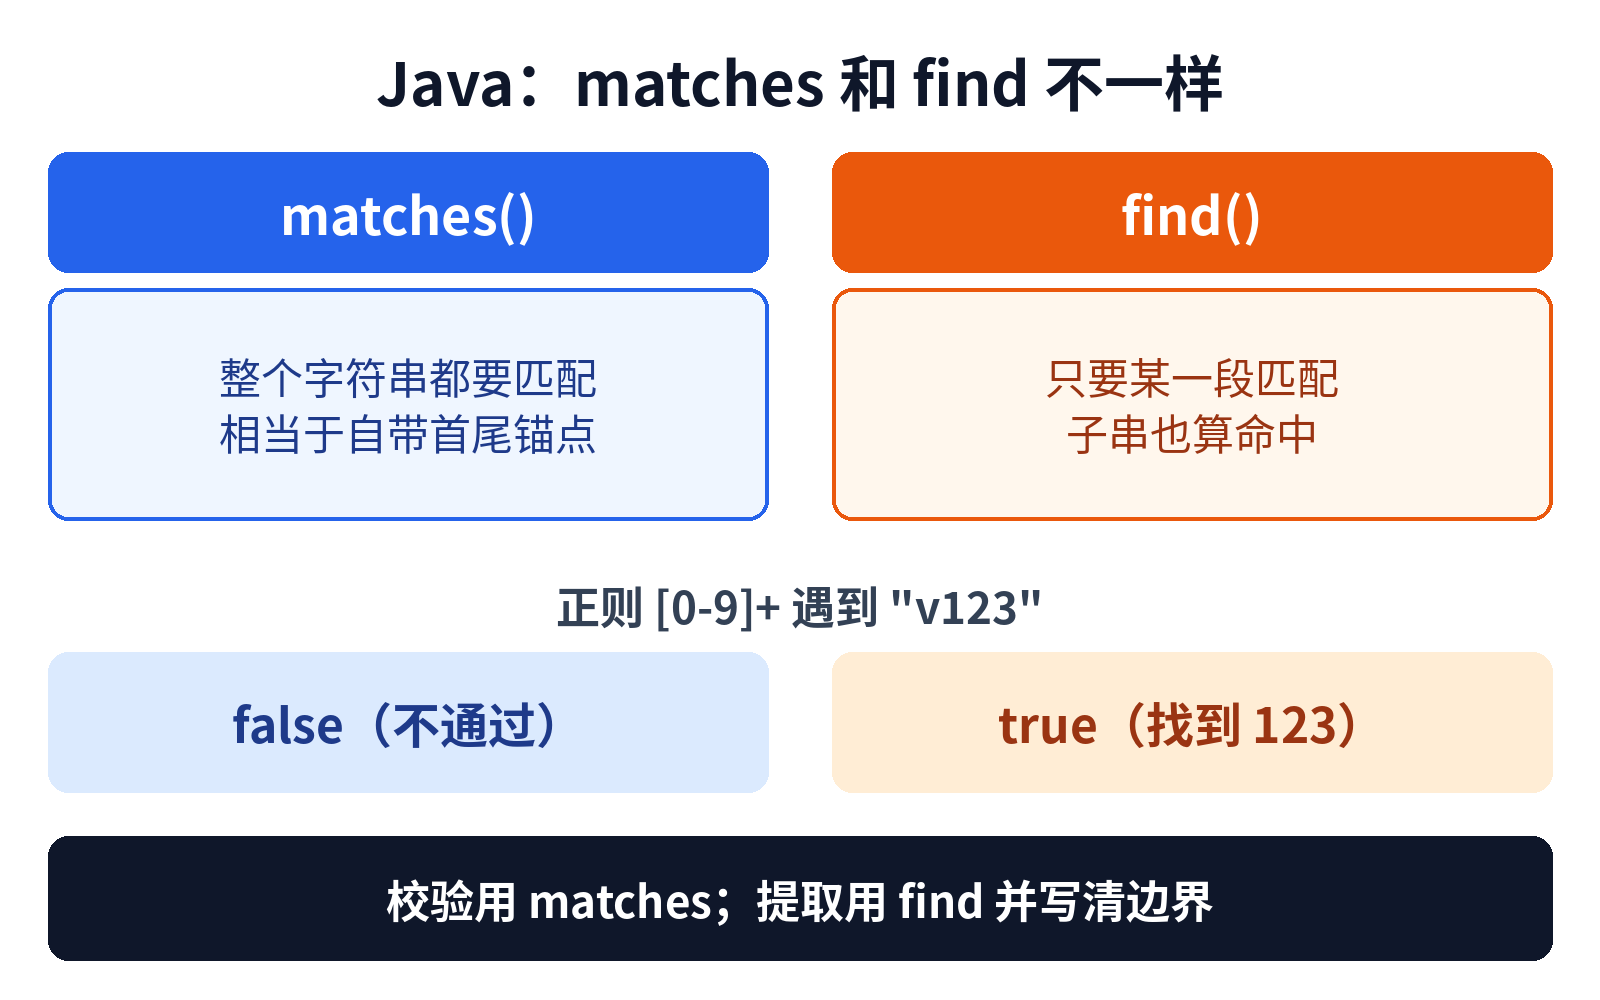
图:Java 里 matches 与 find:整串匹配 vs 找子串(原创示意图)
我的习惯是:校验输入用 matches;从文本里提取用 find,同时正则要写清楚左右边界,比如用 \b 或者前后的分隔符。并且在提示词里直接告诉 AI 我会用哪个方法,让它按这个前提写。
把三张表变成单元测试
前面的正例表和反例表,最后不能只停在聊天记录里。我会让 AI 直接把它们转成参数化测试,这样正则以后被人改动时,边界有保障。
static final Pattern VERSION =
    Pattern.compile("(0|[1-9][0-9]*)\\.(0|[1-9][0-9]*)\\.(0|[1-9][0-9]*)");

@ParameterizedTest
@ValueSource(strings = {"1.2.3", "10.0.1", "0.0.0"})
void accepts(String s) {
    assertTrue(VERSION.matcher(s).matches());
}

@ParameterizedTest
@ValueSource(strings = {"1.2", "1.2.3.4", "v1.2.3", "01.2.3", " 1.2.3", "1..3"})
void rejects(String s) {
    assertFalse(VERSION.matcher(s).matches());
}
这里的 01.2.3 被拒绝,是我在存疑表里做的决定,测试把这个决定固定了下来。半年后有人问“为什么前导零不行”,测试就是答案的一部分。
对于可能遇到恶意输入的场景,我还会补一个用例:构造一个很长、差一点就能匹配的字符串,加上超时断言,确认正则不会在这种输入下卡住。这个用例本身也可以让 AI 帮忙设计,但跑不跑、阈值多少,我自己定。
说清楚方言,也说清楚谁来维护
还有两件事我会在一开始就交代,省得返工。
一是正则方言。Java、JavaScript、Python、数据库里的正则、grep 和编辑器里的搜索,语法大体相同,细节各有不同:命名分组的写法、后行断言支持到什么程度、标志位怎么开、哪些字符需要转义。AI 默认给的往往是一种“通用”写法,放进具体环境未必能跑,或者能跑但行为有细微差别。我会明确说“Java 17 的 java.util.regex”,而不是只说“写个正则”。
二是谁来维护。如果这个正则以后要别的同事改,我会要求它写得朴素一点:宁可长一些、分几段用注释说明,也不要一行塞满断言和非捕获组。AI 很喜欢给出“优雅”的一行流,炫技意味很浓,但三个月后连它自己再解释一遍都可能讲不清。Java 里可以用 Pattern.COMMENTS 标志,让正则里写空白和注释,这个我也会顺便让它用上。
有些活本来就不该用正则
最后一个反例,是关于“要不要用正则”本身。
我以前什么都想用正则解决,AI 也乐于配合。解析 JSON 片段、从 HTML 里抠标签、校验日期是否合法,它都能给出一个看起来能用的正则。但这些场景,正则几乎注定会在某个边界上失败:嵌套结构、转义字符、闰年和每月天数。
现在遇到这类需求,我会先问 AI:“这个需求用正则合适吗?有没有更稳的标准库或解析器?”日期用 java.time 去解析,JSON 用解析库,HTML 用专门的解析器。正则只留给真正扁平的文本模式。让 AI 先判断工具选得对不对,也算是一种更高层的“反例”。
小结
回头看,AI 写正则的能力其实一直没问题,问题出在我给它的信息太少:只给了几个正例,等于只画了集合里的几个点,边界让它自由发挥。
现在的流程是:先三张表,人拍板边界;再写正则,同时说清楚用 matches 还是 find;然后让它攻击自己;最后三张表落成测试。多花五分钟,换来的是我终于敢相信自己提交的正则了。
 2026-10-16鱼鱼