用 AI 读英文技术文档:我怎么防它“翻译腔”和悄悄漏译

  created  by  鱼鱼 {{tag}}
创建于 2026年10月16日 09:35:08 最后修改于 2026年10月16日 09:35:08

我英文阅读不算差,但读长篇官方文档还是累。尤其是那种配置参考页、迁移指南、RFC 风格的规范,一页几十屏,读到后面前面的全忘了。所以这两年我读英文文档,基本都会拉上 AI 一起:整段丢进去,让它翻成中文,或者干脆让它讲给我听。

一开始我觉得这是纯赚的事。直到有一次按译文改了配置,上线前同事问我:“文档里不是说这个参数只有在另一个开关打开时才生效吗?”我回去翻原文,还真有那么一句 unless 从句,而 AI 给我的中文里,这半句干干净净地消失了。译文读起来非常顺,顺到我完全没怀疑。

从那以后我对“AI 翻译技术文档”的态度变了:它很好用,但它的错不是乱码式的错,而是读起来很通顺的错。这篇记一下我现在的用法,主要防两件事:翻译腔,和悄悄漏译。

漏译比错译更危险

错译通常会露馅。比如把某个术语翻得很奇怪,你读着别扭,自然会回去看原文。漏译不一样,少了一句话,剩下的部分照样连贯,你根本不知道自己少看了什么。

按我自己的踩坑记录,AI 最容易漏的是这几类内容:

  • 否定词和情态词:not、never、must、should、may、only。少一个 not 意思直接反过来;把 must 翻成“可以”,约束就变成了建议。

  • 条件和例外从句:unless、except、only if、provided that。这类半句话经常被“合并”进主句,然后就没了。

  • 提示框:Note、Warning、Caution、Important。网页复制下来时这些框的格式会乱,AI 有时把它当成无关内容跳过。

  • 括号和脚注:括号里常写“默认值”“仅限某平台”,脚注里常写历史兼容问题。

  • 版本限定:since 3.2、deprecated in、removed in。这类小字对我们写 Java 的人特别要命,依赖版本一对不上就是半天排查。
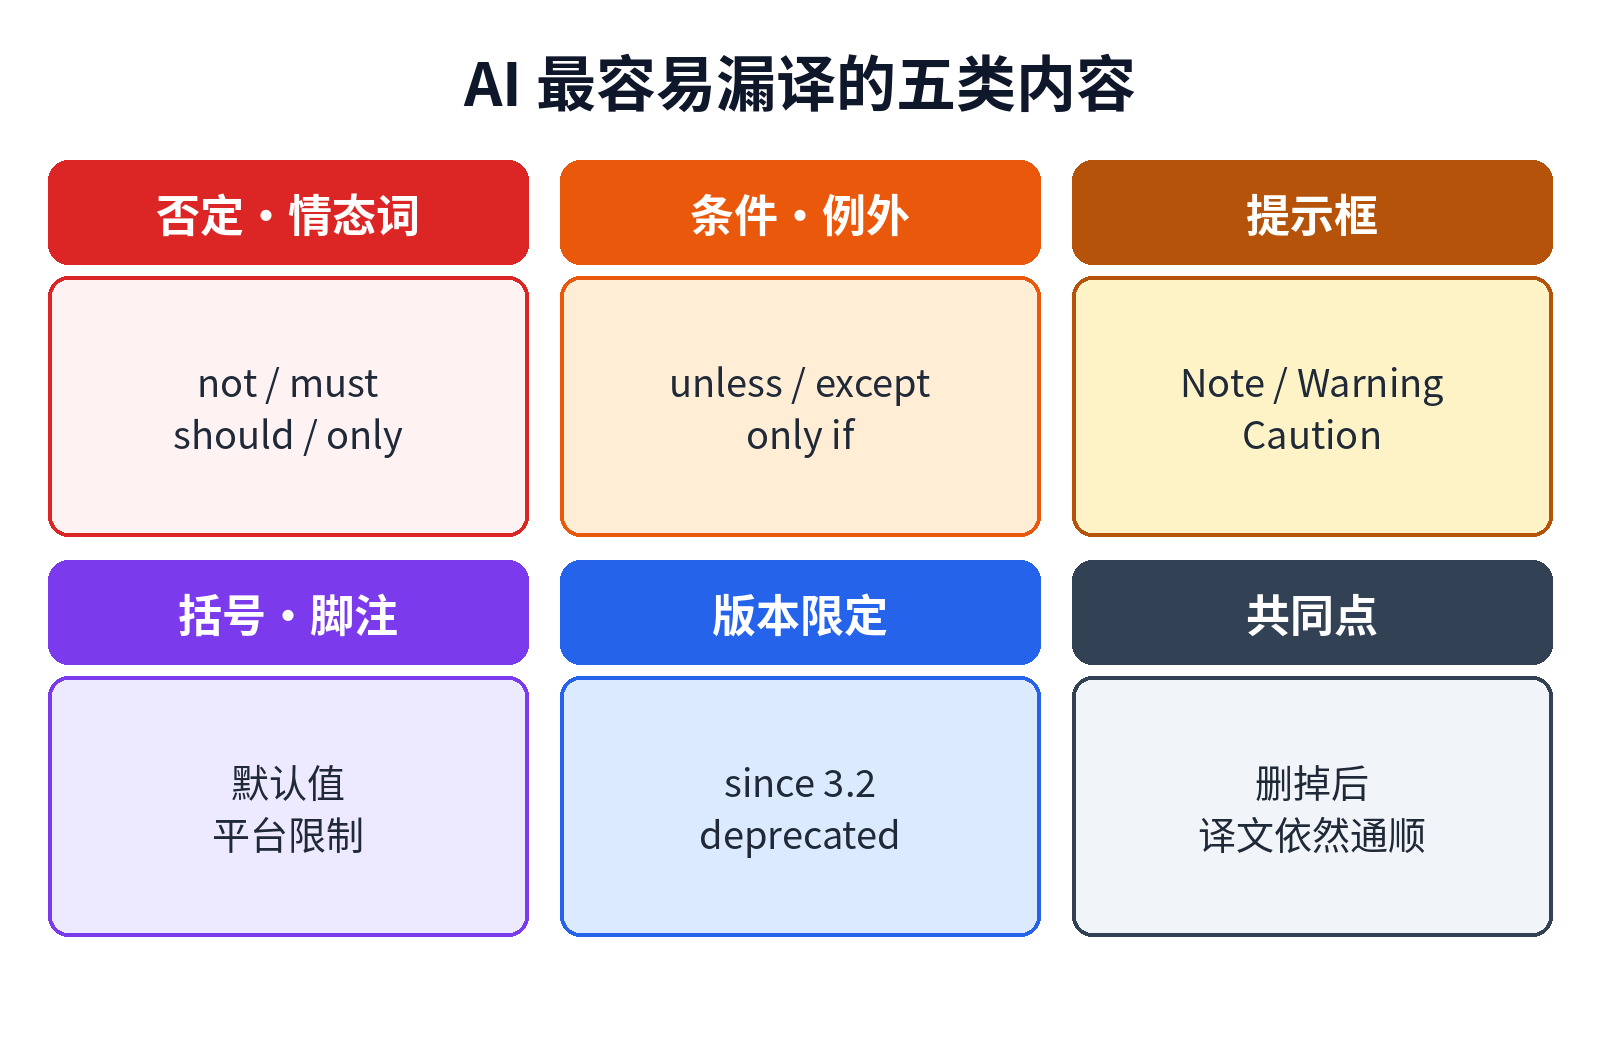
AI 最容易漏译的五类内容:否定情态词、条件例外、提示框、括号脚注、版本限定

图:AI 最容易漏译的五类内容:否定情态词、条件例外、提示框、括号脚注、版本限定(原创示意图)

我后来想明白,这不完全是模型“偷懒”。这些内容本身就是主干之外的修饰,模型在追求通顺的时候,会倾向于把它们压缩掉。翻成自然的中文和逐句忠实,本来就有张力。

第一招:分段编号,逐段对照

最有效的一招非常朴素:不要整页丢进去要一篇中文。

我现在会先把原文按段落切开,每段编个号,然后要求它逐段输出:先贴原文第几段,再给译文。原文和译文挨着放,我扫一眼长度差异就能发现问题。一段英文三行,译文只有一行,那多半少了东西。

提示词大概是这样:

下面是一段英文技术文档,已按段落编号。
请逐段翻译,格式:
[段号] 原文首句前 8 个词……
译文:……
要求:
1. 不合并段落,不省略任何句子,包括括号、Note、Warning。
2. 代码、配置项名、类名、版本号保持原样,不翻译。
3. 拿不准的句子标【存疑】并说明原因,不要自行发挥。

“原文首句前 8 个词”这个要求是我后来加的。它逼着模型每段都回到原文对齐一次,也方便我对照。整页翻译时模型容易越写越顺、越写越飘,逐段对齐能把它拽回来。

第二招:先锁术语表

第二个常见问题是术语飘移。同一个词,前面翻成“代理”,后面翻成“中间人”,再往后又直接写英文。读一篇文档要在脑子里做三次映射,很累,也容易误解成三个不同的东西。

我的做法是开译之前先让它扫一遍全文,列一张术语表:英文原词、建议译法、是否保留英文。然后我改一遍再发回去,要求后面严格按表来。

我自己的偏好是:行业里大家都直接说英文的词,就别翻。比如 offset、commit、idempotent、backpressure、classpath 这类,硬翻成中文反而要再翻回去才能搜到资料。保留英文、首次出现时括号里给个中文解释,是我觉得最舒服的方式。

第三招:清点“小词”

对于特别关键的段落,比如安全配置、兼容性说明、迁移步骤,我会多做一步:让它把原文里所有的否定词、情态词、条件词列出来,每个对应到译文的哪一句。

听起来繁琐,其实就是一条追加指令:“列出原文本段所有 not/never/must/should/may/only/unless/except,以及它们在译文中的对应位置。”如果它列出来原文有四个,译文只对上三个,那第四个就是漏的。

这招我只在关键段落用。全文都这么做,读一页文档要花半小时,就失去用 AI 的意义了。

翻译腔:顺不等于好懂

再说翻译腔。漏译是信息丢了,翻译腔是信息都在,但读起来像隔着一层毛玻璃。

AI 的译文有几种很典型的腔调:

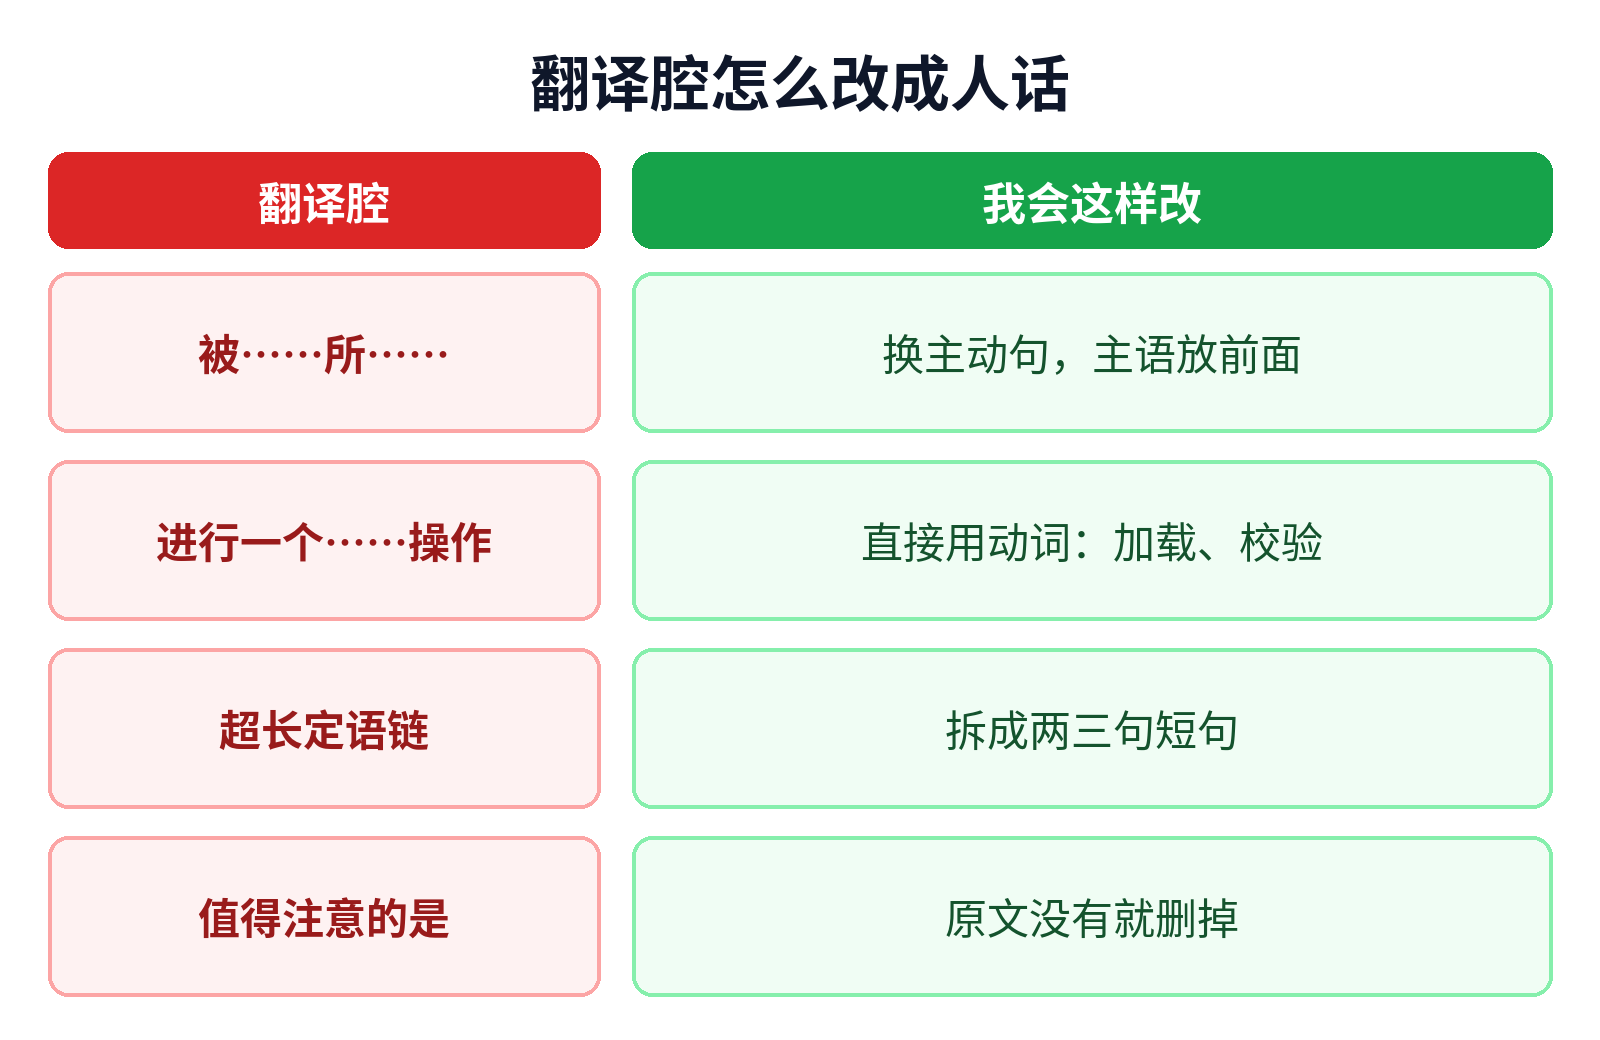
  • “被……所……”的被动句堆叠,英文被动语态原样搬过来;

  • “进行一个……的操作”,动词被名词化,啰嗦一倍;

  • 长定语链,“一个用于在启动时加载由用户指定的配置的类”,读到最后忘了主语;

  • “值得注意的是”“需要指出的是”这种填充词,原文根本没有。

翻译腔对照:被动堆叠、名词化、长定语、填充词怎么改成人话

图:翻译腔对照:被动堆叠、名词化、长定语、填充词怎么改成人话(原创示意图)

我对付翻译腔的办法,是把“翻译”和“讲解”分成两步。第一步要忠实,宁可生硬,逐段对照;第二步才让它“用中文程序员平时说话的方式,把这段讲给同事听”。第二步可以拆长句、调语序、加例子,但不能增删事实。

分两步的好处是,我手里一直有一份忠实版可以回查。讲解版读着舒服,忠实版保证没丢东西。以前我一步要求“又准又顺”,结果它往往为了顺牺牲准。

抽查:数字、代码和“存疑”标记

逐段对照之后,我还会做三个很快的抽查,加起来一两分钟。

第一是数字对账。默认值、超时时间、端口号、大小限制、百分比,原文里出现的每个数字,译文里都应该原样出现。数字是最容易核对的锚点,也是最不能错的东西。我遇到过把毫秒说成秒的情况,不知道是原文本身含糊还是模型理解偏了,总之按译文去配会差一千倍。

第二是代码和配置名对账。我在提示词里要求代码不翻译,但偶尔还是会看到它把配置项名里的单词“顺手”翻成中文,或者把驼峰名改了大小写。复制粘贴之前一定要用原文的写法。

第三是看它标了多少【存疑】。说来有点反直觉:一篇长文档如果它一个存疑都没标,我反而更警惕。英文技术文档里有歧义的句子并不少见,一个存疑都没有,更可能是它把拿不准的地方也翻得很笃定。看到存疑标记,我就去读那一句原文,通常也是全篇最值得读的几句。

什么时候干脆别翻

还有一个习惯,是我用了一段时间之后才形成的:很多时候我其实不需要译文,我需要的是“读懂”。

比如读一篇设计文档,我关心的是它解决什么问题、核心取舍是什么、有哪些限制。这时候让 AI 逐句翻译反而浪费时间。我会改成:“用中文概括这篇文档讲了哪几件事,每件事给出原文中最关键的一句英文原句作为依据。”

带原句作为依据很重要。概括本身可能有偏差,但原句是可以核对的。我会挑一两条最关键的,自己读原句确认。慢慢地,我读原文的能力也在涨,因为每次都在对照真句子,而不是只看二手中文。

反过来,以下几种情况我一定读原文,最多让 AI 帮我查生词:

  1. 涉及安全、权限、加密的配置说明;

  2. 版本迁移指南里的 breaking changes;

  3. 许可证条款;

  4. 接口契约里关于线程安全、幂等、异常的描述。

这些地方一个词的偏差,代价都很大,我不想把判断交给一层我看不见的转述。

我现在的流程

最后把流程串一下,方便大家直接抄:

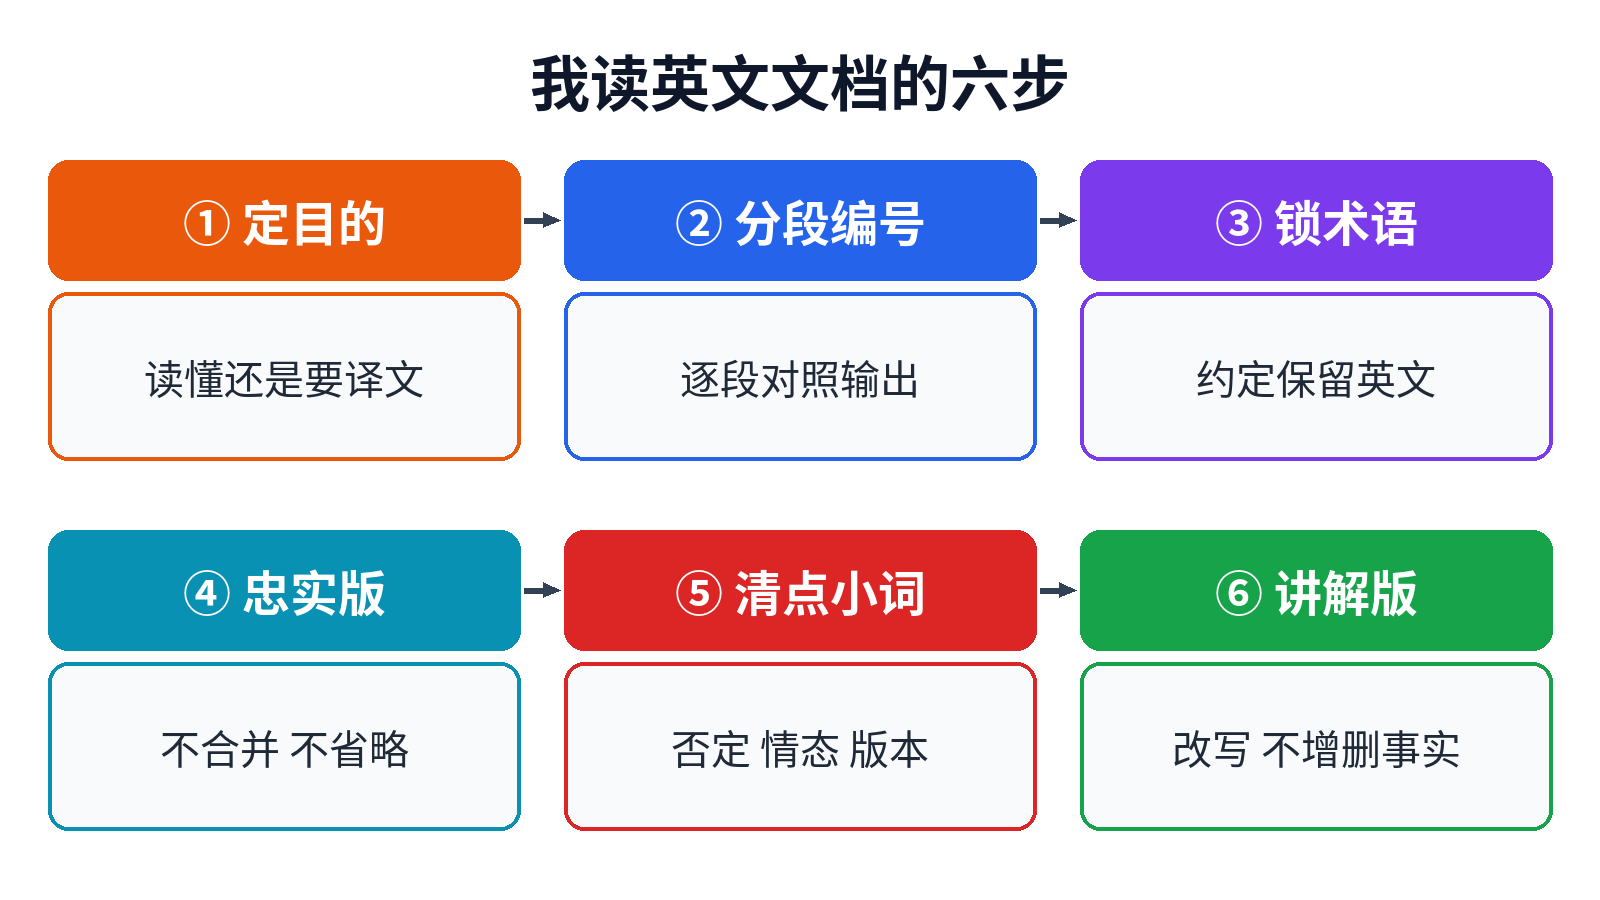
  1. 先判断目的:要读懂还是要译文?读懂就要概括加原句锚点,不必逐句译。

  2. 分段编号:长文切段,每段编号,逐段对照输出。

  3. 锁术语表:开译前先定好术语,约定哪些保留英文。

  4. 忠实版先行:第一遍宁可生硬,不合并不省略,存疑要标注。

  5. 关键段清点小词:否定、情态、条件、版本限定逐个对上。

  6. 讲解版另做:需要顺畅阅读时,在忠实版基础上改写,不增删事实。

读英文文档六步:定目的、分段编号、锁术语、忠实版、清点小词、讲解版

图:读英文文档六步:定目的、分段编号、锁术语、忠实版、清点小词、讲解版(原创示意图)

说到底,AI 是一个非常好的阅读加速器,但它的默认目标是“读起来自然”,而我读技术文档的目标是“一个约束都别漏”。这两个目标不冲突,但需要我在流程上把它们分开。分开之后,我读英文文档的速度确实快了不少,而且没再因为一个消失的 unless 返工过。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

用 AI 读英文技术文档:我怎么防它“翻译腔”和悄悄漏译

用 AI 读英文技术文档:我怎么防它“翻译腔”和悄悄漏译

我英文阅读不算差,但读长篇官方文档还是累。尤其是那种配置参考页、迁移指南、RFC 风格的规范,一页几十屏,读到后面前面的全忘了。所以这两年我读英文文档,基本都会拉上 AI 一起:整段丢进去,让它翻成中文,或者干脆让它讲给我听。

一开始我觉得这是纯赚的事。直到有一次按译文改了配置,上线前同事问我:“文档里不是说这个参数只有在另一个开关打开时才生效吗?”我回去翻原文,还真有那么一句 unless 从句,而 AI 给我的中文里,这半句干干净净地消失了。译文读起来非常顺,顺到我完全没怀疑。

从那以后我对“AI 翻译技术文档”的态度变了:它很好用,但它的错不是乱码式的错,而是读起来很通顺的错。这篇记一下我现在的用法,主要防两件事:翻译腔,和悄悄漏译。

漏译比错译更危险

错译通常会露馅。比如把某个术语翻得很奇怪,你读着别扭,自然会回去看原文。漏译不一样,少了一句话,剩下的部分照样连贯,你根本不知道自己少看了什么。

按我自己的踩坑记录,AI 最容易漏的是这几类内容:

AI 最容易漏译的五类内容:否定情态词、条件例外、提示框、括号脚注、版本限定

图:AI 最容易漏译的五类内容:否定情态词、条件例外、提示框、括号脚注、版本限定(原创示意图)

我后来想明白,这不完全是模型“偷懒”。这些内容本身就是主干之外的修饰,模型在追求通顺的时候,会倾向于把它们压缩掉。翻成自然的中文和逐句忠实,本来就有张力。

第一招:分段编号,逐段对照

最有效的一招非常朴素:不要整页丢进去要一篇中文。

我现在会先把原文按段落切开,每段编个号,然后要求它逐段输出:先贴原文第几段,再给译文。原文和译文挨着放,我扫一眼长度差异就能发现问题。一段英文三行,译文只有一行,那多半少了东西。

提示词大概是这样:

下面是一段英文技术文档,已按段落编号。
请逐段翻译,格式:
[段号] 原文首句前 8 个词……
译文:……
要求:
1. 不合并段落,不省略任何句子,包括括号、Note、Warning。
2. 代码、配置项名、类名、版本号保持原样,不翻译。
3. 拿不准的句子标【存疑】并说明原因,不要自行发挥。

“原文首句前 8 个词”这个要求是我后来加的。它逼着模型每段都回到原文对齐一次,也方便我对照。整页翻译时模型容易越写越顺、越写越飘,逐段对齐能把它拽回来。

第二招:先锁术语表

第二个常见问题是术语飘移。同一个词,前面翻成“代理”,后面翻成“中间人”,再往后又直接写英文。读一篇文档要在脑子里做三次映射,很累,也容易误解成三个不同的东西。

我的做法是开译之前先让它扫一遍全文,列一张术语表:英文原词、建议译法、是否保留英文。然后我改一遍再发回去,要求后面严格按表来。

我自己的偏好是:行业里大家都直接说英文的词,就别翻。比如 offset、commit、idempotent、backpressure、classpath 这类,硬翻成中文反而要再翻回去才能搜到资料。保留英文、首次出现时括号里给个中文解释,是我觉得最舒服的方式。

第三招:清点“小词”

对于特别关键的段落,比如安全配置、兼容性说明、迁移步骤,我会多做一步:让它把原文里所有的否定词、情态词、条件词列出来,每个对应到译文的哪一句。

听起来繁琐,其实就是一条追加指令:“列出原文本段所有 not/never/must/should/may/only/unless/except,以及它们在译文中的对应位置。”如果它列出来原文有四个,译文只对上三个,那第四个就是漏的。

这招我只在关键段落用。全文都这么做,读一页文档要花半小时,就失去用 AI 的意义了。

翻译腔:顺不等于好懂

再说翻译腔。漏译是信息丢了,翻译腔是信息都在,但读起来像隔着一层毛玻璃。

AI 的译文有几种很典型的腔调:

翻译腔对照:被动堆叠、名词化、长定语、填充词怎么改成人话

图:翻译腔对照:被动堆叠、名词化、长定语、填充词怎么改成人话(原创示意图)

我对付翻译腔的办法,是把“翻译”和“讲解”分成两步。第一步要忠实,宁可生硬,逐段对照;第二步才让它“用中文程序员平时说话的方式,把这段讲给同事听”。第二步可以拆长句、调语序、加例子,但不能增删事实。

分两步的好处是,我手里一直有一份忠实版可以回查。讲解版读着舒服,忠实版保证没丢东西。以前我一步要求“又准又顺”,结果它往往为了顺牺牲准。

抽查:数字、代码和“存疑”标记

逐段对照之后,我还会做三个很快的抽查,加起来一两分钟。

第一是数字对账。默认值、超时时间、端口号、大小限制、百分比,原文里出现的每个数字,译文里都应该原样出现。数字是最容易核对的锚点,也是最不能错的东西。我遇到过把毫秒说成秒的情况,不知道是原文本身含糊还是模型理解偏了,总之按译文去配会差一千倍。

第二是代码和配置名对账。我在提示词里要求代码不翻译,但偶尔还是会看到它把配置项名里的单词“顺手”翻成中文,或者把驼峰名改了大小写。复制粘贴之前一定要用原文的写法。

第三是看它标了多少【存疑】。说来有点反直觉:一篇长文档如果它一个存疑都没标,我反而更警惕。英文技术文档里有歧义的句子并不少见,一个存疑都没有,更可能是它把拿不准的地方也翻得很笃定。看到存疑标记,我就去读那一句原文,通常也是全篇最值得读的几句。

什么时候干脆别翻

还有一个习惯,是我用了一段时间之后才形成的:很多时候我其实不需要译文,我需要的是“读懂”。

比如读一篇设计文档,我关心的是它解决什么问题、核心取舍是什么、有哪些限制。这时候让 AI 逐句翻译反而浪费时间。我会改成:“用中文概括这篇文档讲了哪几件事,每件事给出原文中最关键的一句英文原句作为依据。”

带原句作为依据很重要。概括本身可能有偏差,但原句是可以核对的。我会挑一两条最关键的,自己读原句确认。慢慢地,我读原文的能力也在涨,因为每次都在对照真句子,而不是只看二手中文。

反过来,以下几种情况我一定读原文,最多让 AI 帮我查生词:

  1. 涉及安全、权限、加密的配置说明;

  2. 版本迁移指南里的 breaking changes;

  3. 许可证条款;

  4. 接口契约里关于线程安全、幂等、异常的描述。

这些地方一个词的偏差,代价都很大,我不想把判断交给一层我看不见的转述。

我现在的流程

最后把流程串一下,方便大家直接抄:

  1. 先判断目的:要读懂还是要译文?读懂就要概括加原句锚点,不必逐句译。

  2. 分段编号:长文切段,每段编号,逐段对照输出。

  3. 锁术语表:开译前先定好术语,约定哪些保留英文。

  4. 忠实版先行:第一遍宁可生硬,不合并不省略,存疑要标注。

  5. 关键段清点小词:否定、情态、条件、版本限定逐个对上。

  6. 讲解版另做:需要顺畅阅读时,在忠实版基础上改写,不增删事实。

读英文文档六步:定目的、分段编号、锁术语、忠实版、清点小词、讲解版

图:读英文文档六步:定目的、分段编号、锁术语、忠实版、清点小词、讲解版(原创示意图)

说到底,AI 是一个非常好的阅读加速器,但它的默认目标是“读起来自然”,而我读技术文档的目标是“一个约束都别漏”。这两个目标不冲突,但需要我在流程上把它们分开。分开之后,我读英文文档的速度确实快了不少,而且没再因为一个消失的 unless 返工过。


用 AI 读英文技术文档:我怎么防它“翻译腔”和悄悄漏译2026-10-16鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论