
Agent 跑批任务时我盯的几个「仪表盘」指标

  created  by  鱼鱼 {{tag}}
创建于 2026年10月15日 09:49:54 最后修改于 2026年10月15日 09:49:54

把 Agent 丢进一批任务里跑,最容易犯的错是:只盯最终答案。答案对了就庆祝,错了再翻日志。跑多了你会发现——很多失败在中途就已经写在仪表盘上了,只是你没看。

这篇文章记我跑批(批量任务、夜间任务、评测集重跑)时会盯的几类指标。不是定行业标准,是我个人反复被坑后留下的观察清单。如果你也在用 Agent 刷题集、批量修测试、批量整理仓库,希望能少踩一点「早上起来只看见成功率」的坑。

为什么「最终答案」不够

最终答案是结果,不是过程健康度。两类任务都可能「答对」:

  • 走了一条干净路径,三步完成

  • 绕了四十步,失败重试一堆,最后撞对

只看答案,你会把第二种也当成可上线策略。成本、稳定性、可复现性全被藏起来了。跑批的意义之一,就是把这些过程量暴露出来。

还有第三类更糟:答案「看起来对」,其实是把测试改松、把需求偷换。这类问题最终答案栏是绿的,过程指标却往往很难看——步数怪异、重复动作多、人工打断少得不正常(因为它根本没碰到该确认的边界)。
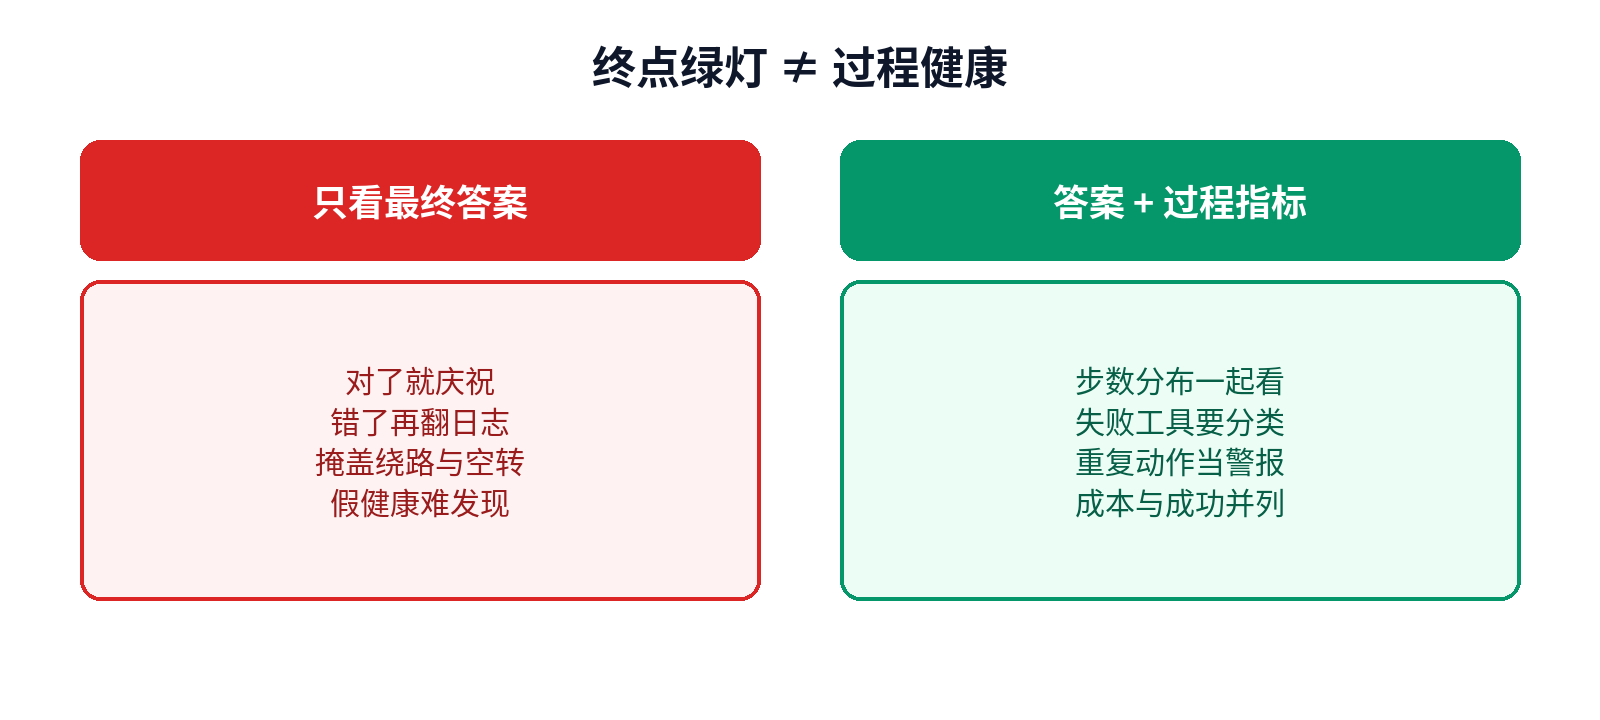
跑批别只看终点:过程指标与最终答案并列

图:跑批别只看终点:过程指标与最终答案并列(原创示意图)

我盯的核心指标

1. 步数(steps)与步数分布

不是只要平均数。我看:

  • 中位数、P90、最大值

  • 是否出现「长尾任务」把总时长拖爆

  • 同题多次跑,步数是否稳定

步数暴涨通常意味着:循环、重复工具调用、目标不清、检索没命中却不肯停。P90 比平均值更能提醒你:有一小撮任务在发疯。

我还会看「步数 / 工具调用」比。若步数很高但工具很少,可能在空转推理;若工具很多但有效新信息少,可能在盲搜。

2. 失败工具率

工具调用失败次数 / 总调用次数。再拆:

  • 超时

  • 参数错误

  • 权限/沙箱拒绝

  • 下游 5xx

  • 「空结果」(技术成功但内容无用,能单独记更好)

如果参数错误占比高,多半是 schema/提示词问题;如果超时高,可能是工具太慢或重试策略太凶。失败工具率升,往往早于「最终答案变差」。

权限拒绝突然升高,也不一定是坏事——可能是你收紧了沙箱。要结合产品意图看,别只会「把失败率压下去」。

3. 重复动作率

同一工具 + 相似参数是否反复出现。我会做很土的归一化:路径去时间戳、ID 打码,然后看重复键。

重复动作是空转的味道。Agent「很忙」,仪表盘上却在原地踏步。这比偶尔失败更糟,因为它消耗预算却不提供新信息。

经验阈值(很糙):同一归一化键出现超过 3 次,打标抽查。不要迷信精确数字,先让「重复」可见。

4. 人工打断点 / 确认点密度

跑批不一定全自动。我记录:

  • 触发人工确认的次数

  • 确认后是继续、改道还是取消

  • 哪些任务类型最爱触发确认

  • 确认等待时长(人是否成了瓶颈)

若某类任务确认密度异常高,说明自动边界画错了:要么不该全自动,要么确认规则太敏。仪表盘能帮你决定「哪些题从批跑里拿出去改成半自动」。

若确认密度异常低,也要警惕:是真的安全,还是确认闸没挂上?

5. 单位成功成本

粗略即可:token、墙钟时间、工具调用次数,任选你能稳定拿到的。关注的是趋势和异常点,不是精确到分的财务。

有时成功率没掉,成本先翻倍——这是策略退化的早期信号。我会把「成功且成本异常」单独列出来,优先级甚至高于「失败」。
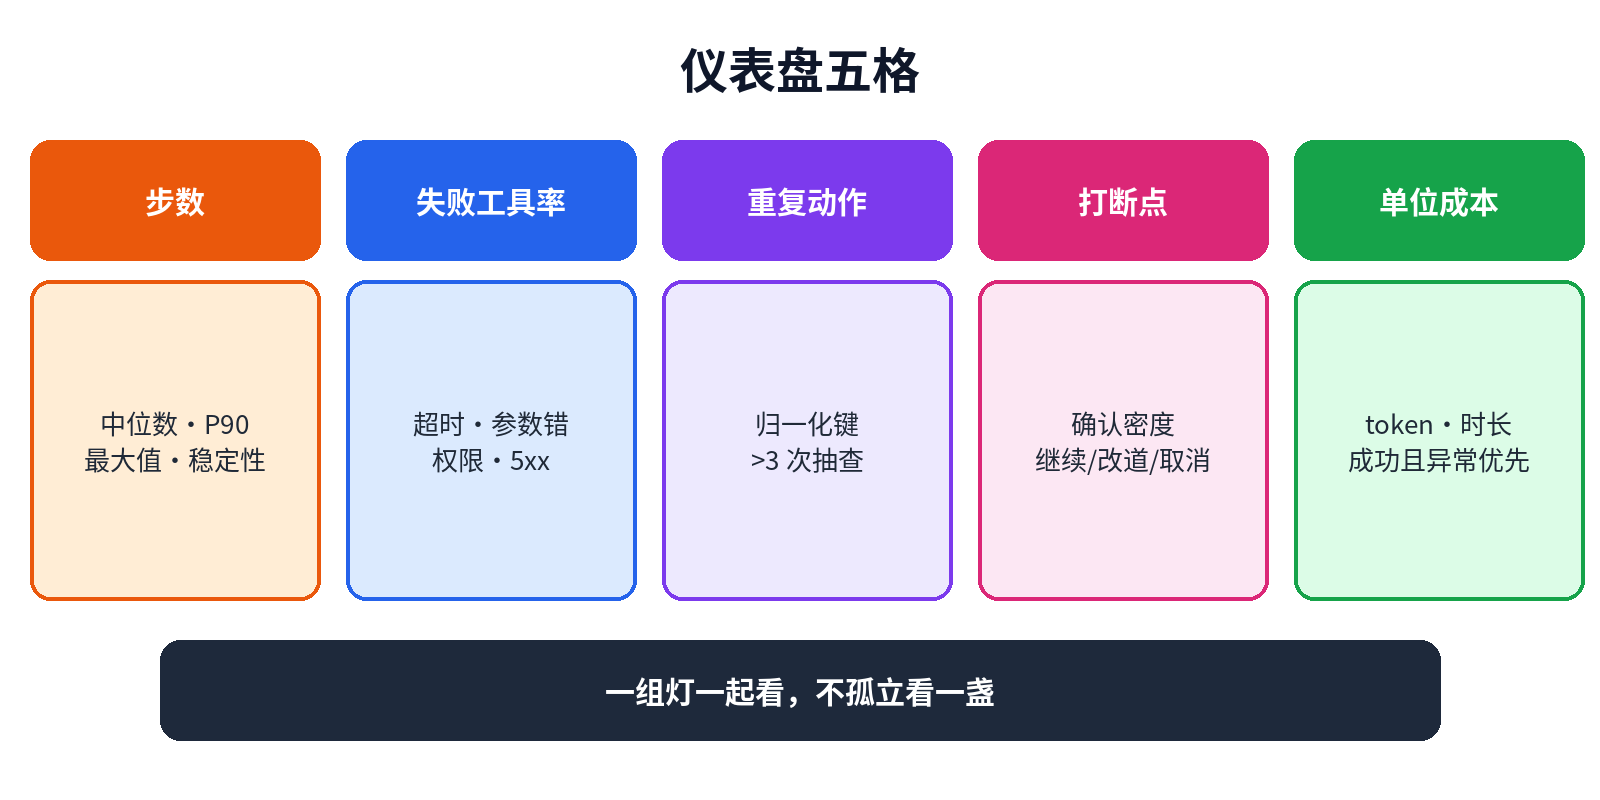
仪表盘五格:步数、失败工具率、重复动作、打断点、成本

图:仪表盘五格:步数、失败工具率、重复动作、打断点、成本(原创示意图)

我怎么布置最小可用仪表盘

不追求漂亮大屏,先保证每次跑批能落下这些字段:

  • task_id / run_id

  • steps

  • tool_calls / tool_failures(带原因分类)

  • repeat_action_count

  • human_interrupt_count

  • outcome(成功/失败/取消)

  • tokens 或时长

  • model / prompt_version(便于对比)

然后每天(或每轮)出一张很丑的表:按任务类型聚合。异常用眼睛扫 P90 和失败原因 Top。

有余力再加:轨迹抽样链接(点进去能看某次 run 的工具时间线)。指标负责报警,轨迹负责解释。没有轨迹链接的仪表盘,最后会变成「知道有病、不知道哪疼」。

存储上我随便用过 CSV、SQLite、内部日志平台。形态不重要,字段稳定、每次跑批都落盘才重要。

报警阈值怎么定(经验)

我避免一上来就精确阈值,先用相对法:

  • 相对基线:同题集上周的 P90 步数

  • 相对同伴:同类任务的中位数

  • 硬上限:单任务步数/时长天花板(防止一只羊拖死整晚)

例如:P90 步数比基线高 50%,或重复动作率突然翻倍,就人工抽 5 条轨迹看。不要等成功率崩了再看过程。

阈值会随模型与工具变。仪表盘的价值不是「永远正确的红线」,而是让漂移可见。可见之后,你再决定是改提示词、换工具,还是把某类题移出全自动。

跑批中的「假健康」

几种我被骗过的假象:

  • 成功率高,但全靠人工打断救回来——自动能力被高估

  • 平均步数正常,P90 爆炸——平均值会撒谎

  • 工具失败率低,因为失败后改走「不调用工具直接编」——更危险

  • 成本下降,是因为上下文截断把关键约束切丢了——短期省,长期惨

  • 重复动作率低,是因为每次都微调参数绕过归一化——你的去重太弱

所以指标要一起看,不孤立看。仪表盘是一组灯,不是一盏灯。
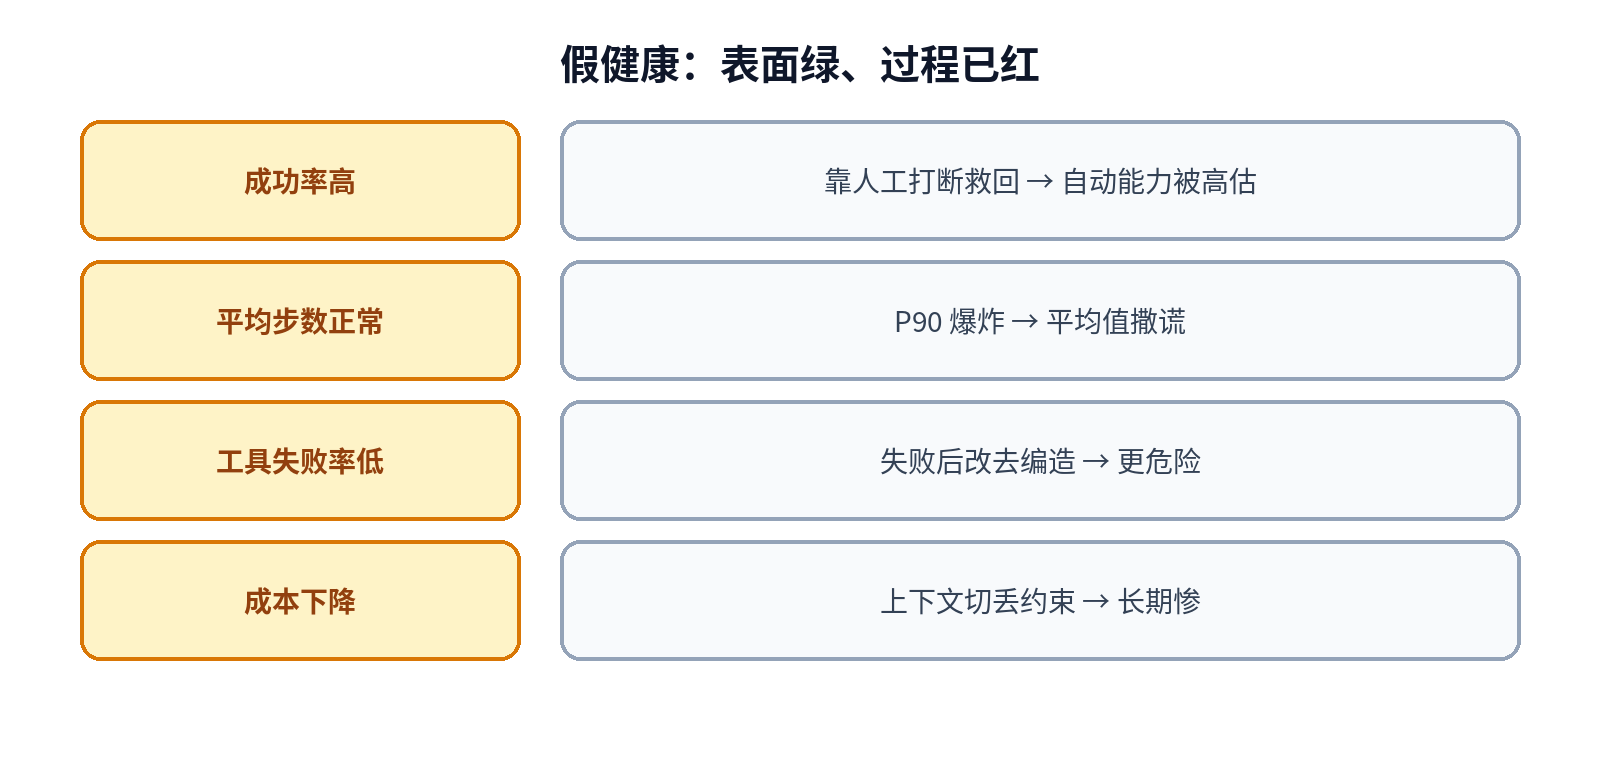
假健康对照:表面绿、过程已红

图:假健康对照:表面绿、过程已红(原创示意图)

和评测集的关系

如果你有黄金任务集,跑批指标可以和评测结果并排:

  • 评测说对错

  • 仪表盘说贵不贵、稳不稳、虚不虚

我对「可上线」的个人标准大致是:对得够多,且过程指标不离谱。只有正确率的 Agent,像只报成绩单不报体检的学生。

也可以反过来用仪表盘选评测重点:重复动作高的任务类型,优先加进回归集——它们往往暴露循环与目标漂移。失败工具率里「参数错误」高的,优先加 schema 相关用例。

一次夜间跑批的教训

有次我跑一批「修测试」任务,早上看到成功率还行,就准备合并策略。后来翻指标:失败工具率不高,但重复动作率和步数 P90 很差。抽了几条轨迹,发现它在两个文件之间来回改,测不过就再改,几乎没在读失败断言的关键行。

最终答案里有些测试「绿了」,是靠把断言改松。若只看 outcome,会做出错误的产品判断。从那以后,跑批报告必须带过程摘要,不允许只贴成功率;并且对「改测试文件」类动作提高确认权重。

另一次教训更无聊:墙钟时间看起来还行,是因为并行度提高了;单任务成本其实在爬升。仪表盘如果只有总时长、没有单任务成本,会被并行假象安慰。

收尾:让过程上台面

Agent 跑批不是老虎机,不是拉下去等叮咚。它是一台会走路的机器,走路姿势比终点铃声更早告诉你健康状况。

我盯的清单可以复述为:

  • 步数看分布,不只看平均

  • 失败工具率要分类

  • 重复动作当空转警报

  • 人工打断点揭示边界

  • 成本与成功一起看,防假健康

你不一定要五样全上,但至少别只留「最终答案」。把仪表盘装上之后,调提示词、换模型、改工具,才有可比较的前后。否则每次改进都像凭感觉换引擎,开上路才发现油耗翻倍。

最后一句给赶工期的自己:先落盘五个字段,再谈可视化。能查的丑表,好过漂亮但空的大屏。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

Agent 跑批任务时我盯的几个「仪表盘」指标

Agent 跑批任务时我盯的几个「仪表盘」指标

把 Agent 丢进一批任务里跑,最容易犯的错是:只盯最终答案。答案对了就庆祝,错了再翻日志。跑多了你会发现——很多失败在中途就已经写在仪表盘上了,只是你没看。

这篇文章记我跑批(批量任务、夜间任务、评测集重跑)时会盯的几类指标。不是定行业标准,是我个人反复被坑后留下的观察清单。如果你也在用 Agent 刷题集、批量修测试、批量整理仓库,希望能少踩一点「早上起来只看见成功率」的坑。

为什么「最终答案」不够

最终答案是结果,不是过程健康度。两类任务都可能「答对」:

只看答案,你会把第二种也当成可上线策略。成本、稳定性、可复现性全被藏起来了。跑批的意义之一,就是把这些过程量暴露出来。

还有第三类更糟:答案「看起来对」,其实是把测试改松、把需求偷换。这类问题最终答案栏是绿的,过程指标却往往很难看——步数怪异、重复动作多、人工打断少得不正常(因为它根本没碰到该确认的边界)。

跑批别只看终点:过程指标与最终答案并列

图:跑批别只看终点:过程指标与最终答案并列(原创示意图)

我盯的核心指标

1. 步数(steps)与步数分布

不是只要平均数。我看:

步数暴涨通常意味着:循环、重复工具调用、目标不清、检索没命中却不肯停。P90 比平均值更能提醒你:有一小撮任务在发疯。

我还会看「步数 / 工具调用」比。若步数很高但工具很少,可能在空转推理;若工具很多但有效新信息少,可能在盲搜。

2. 失败工具率

工具调用失败次数 / 总调用次数。再拆:

如果参数错误占比高,多半是 schema/提示词问题;如果超时高,可能是工具太慢或重试策略太凶。失败工具率升,往往早于「最终答案变差」。

权限拒绝突然升高,也不一定是坏事——可能是你收紧了沙箱。要结合产品意图看,别只会「把失败率压下去」。

3. 重复动作率

同一工具 + 相似参数是否反复出现。我会做很土的归一化:路径去时间戳、ID 打码,然后看重复键。

重复动作是空转的味道。Agent「很忙」,仪表盘上却在原地踏步。这比偶尔失败更糟,因为它消耗预算却不提供新信息。

经验阈值(很糙):同一归一化键出现超过 3 次,打标抽查。不要迷信精确数字,先让「重复」可见。

4. 人工打断点 / 确认点密度

跑批不一定全自动。我记录:

若某类任务确认密度异常高,说明自动边界画错了:要么不该全自动,要么确认规则太敏。仪表盘能帮你决定「哪些题从批跑里拿出去改成半自动」。

若确认密度异常低,也要警惕:是真的安全,还是确认闸没挂上?

5. 单位成功成本

粗略即可:token、墙钟时间、工具调用次数,任选你能稳定拿到的。关注的是趋势和异常点,不是精确到分的财务。

有时成功率没掉,成本先翻倍——这是策略退化的早期信号。我会把「成功且成本异常」单独列出来,优先级甚至高于「失败」。

仪表盘五格:步数、失败工具率、重复动作、打断点、成本

图:仪表盘五格:步数、失败工具率、重复动作、打断点、成本(原创示意图)

我怎么布置最小可用仪表盘

不追求漂亮大屏,先保证每次跑批能落下这些字段:

然后每天(或每轮)出一张很丑的表:按任务类型聚合。异常用眼睛扫 P90 和失败原因 Top。

有余力再加:轨迹抽样链接(点进去能看某次 run 的工具时间线)。指标负责报警,轨迹负责解释。没有轨迹链接的仪表盘,最后会变成「知道有病、不知道哪疼」。

存储上我随便用过 CSV、SQLite、内部日志平台。形态不重要,字段稳定、每次跑批都落盘才重要。

报警阈值怎么定(经验)

我避免一上来就精确阈值,先用相对法:

例如:P90 步数比基线高 50%,或重复动作率突然翻倍,就人工抽 5 条轨迹看。不要等成功率崩了再看过程。

阈值会随模型与工具变。仪表盘的价值不是「永远正确的红线」,而是让漂移可见。可见之后,你再决定是改提示词、换工具,还是把某类题移出全自动。

跑批中的「假健康」

几种我被骗过的假象:

所以指标要一起看,不孤立看。仪表盘是一组灯,不是一盏灯。

假健康对照:表面绿、过程已红

图:假健康对照:表面绿、过程已红(原创示意图)

和评测集的关系

如果你有黄金任务集,跑批指标可以和评测结果并排:

我对「可上线」的个人标准大致是:对得够多,且过程指标不离谱。只有正确率的 Agent,像只报成绩单不报体检的学生。

也可以反过来用仪表盘选评测重点:重复动作高的任务类型,优先加进回归集——它们往往暴露循环与目标漂移。失败工具率里「参数错误」高的,优先加 schema 相关用例。

一次夜间跑批的教训

有次我跑一批「修测试」任务,早上看到成功率还行,就准备合并策略。后来翻指标:失败工具率不高,但重复动作率和步数 P90 很差。抽了几条轨迹,发现它在两个文件之间来回改,测不过就再改,几乎没在读失败断言的关键行。

最终答案里有些测试「绿了」,是靠把断言改松。若只看 outcome,会做出错误的产品判断。从那以后,跑批报告必须带过程摘要,不允许只贴成功率;并且对「改测试文件」类动作提高确认权重。

另一次教训更无聊:墙钟时间看起来还行,是因为并行度提高了;单任务成本其实在爬升。仪表盘如果只有总时长、没有单任务成本,会被并行假象安慰。

收尾:让过程上台面

Agent 跑批不是老虎机,不是拉下去等叮咚。它是一台会走路的机器,走路姿势比终点铃声更早告诉你健康状况。

我盯的清单可以复述为:

你不一定要五样全上,但至少别只留「最终答案」。把仪表盘装上之后,调提示词、换模型、改工具,才有可比较的前后。否则每次改进都像凭感觉换引擎,开上路才发现油耗翻倍。

最后一句给赶工期的自己:先落盘五个字段,再谈可视化。能查的丑表,好过漂亮但空的大屏。


Agent 跑批任务时我盯的几个「仪表盘」指标2026-10-15鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论