Agent 的工具调用日志:出了问题我先看哪几行

  created  by  鱼鱼 {{tag}}
创建于 2026年10月14日 18:19:18 最后修改于 2026年10月14日 18:19:18

Agent 一跑起来,日志可以很热闹:思考摘要、工具名、参数、返回、重试、最终回答……出了问题时,若从头通读,既慢又容易被模型的“自信叙述”带偏。我逐渐养成一个习惯:先不看它怎么说,先看它调用了什么、参数是否离谱、返回是否被误解。

这篇文章记我排查 Agent 故障时的日志阅读顺序。偏工程经验,不是某家产品的官方手册。

为什么“最终答案”经常最不可信

失败时我最想看的其实不是最终答复。答复是渲染后的故事,故事会把中间的错误抹平。更常见的情况是:

  • 工具已经返回错误,模型却总结成“可能是网络波动”
  • 工具返回了正确数据,模型抽错字段,仍写得头头是道
  • 中途换了策略,但结尾装作一路按原计划执行

所以我把最终答案降级成线索,把工具轨迹升级成证据。
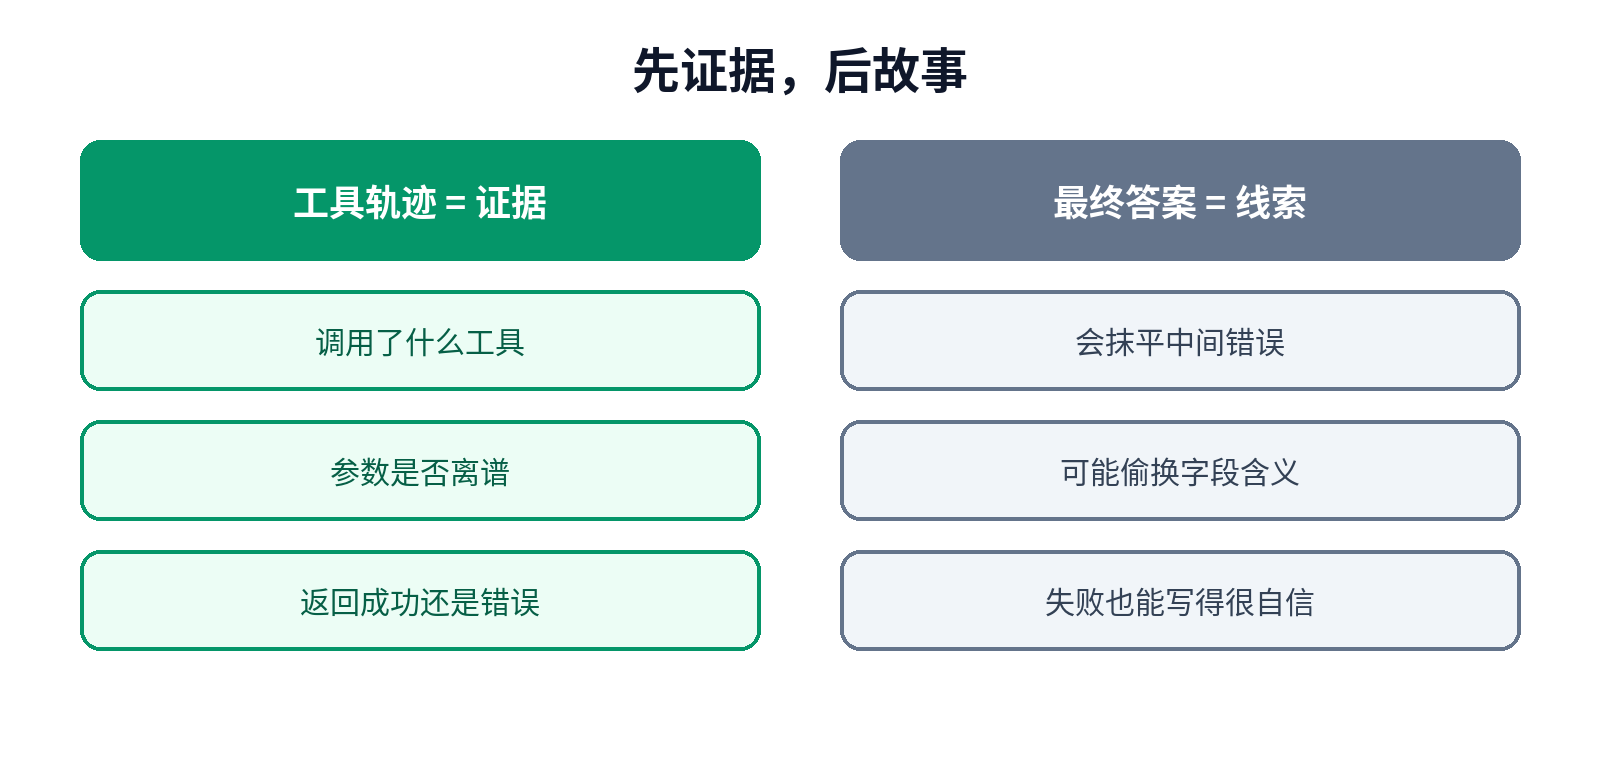
先证据后故事:工具轨迹优先于最终答复

图:先证据后故事:工具轨迹优先于最终答复(原创示意图)

我的阅读顺序(固定五步)

第 1 步:列出工具调用时间线

只看序列:读文件 → 搜代码 → 改文件 → 跑测试 这种骨架。先问三个问题:

  • 顺序是否合理?有没有没读就改、没搜就下结论?
  • 有没有异常重复(同一工具同参连打五次)?
  • 有没有突然插入高风险工具(删库、强推、发外部消息)?

时间线能快速判断是“策略漂了”还是“某一步卡死重试”。

第 2 步:盯参数,不先盯返回

很多事故在参数阶段就已经定局:路径写错、仓库名错、正则过宽、limit 过大、把自然语言塞进只接受枚举的字段。参数离谱时,返回再漂亮也是在错误问题上努力。

我尤其敏感的信号:

  • 路径穿越到无关目录
  • 空字符串 / 占位符没被替换就进工具
  • 同一语义参数前后文不一致(忽而 id 忽而 name)

第 3 步:看返回的“形状”和错误通道

工具返回是成功载荷还是错误对象?模型有没有把 stderr 当正文总结?有没有截断?截断后再推理,常会出现“补全幻觉”。

若日志区分 ok/error,先过滤 error;若没有,看返回里是否出现明显的异常关键字,再回看模型下一轮是否承认。

第 4 步:核对“模型转述”和“原始返回”

这是最费眼但最值的一步。把工具原始返回和模型随后的解释并排看:字段有没有被偷换、数量有没有被四舍五入成“大概”、失败有没有被说成成功。

我踩过的典型坑:工具返回“找不到文件”,模型写“文件为空”。两者处置完全不同。

第 5 步:才轮到最终答案与用户可见输出

确认轨迹自洽后,再看最终答案有没有超出工具证据的断言。超出部分,默认降级为猜测。
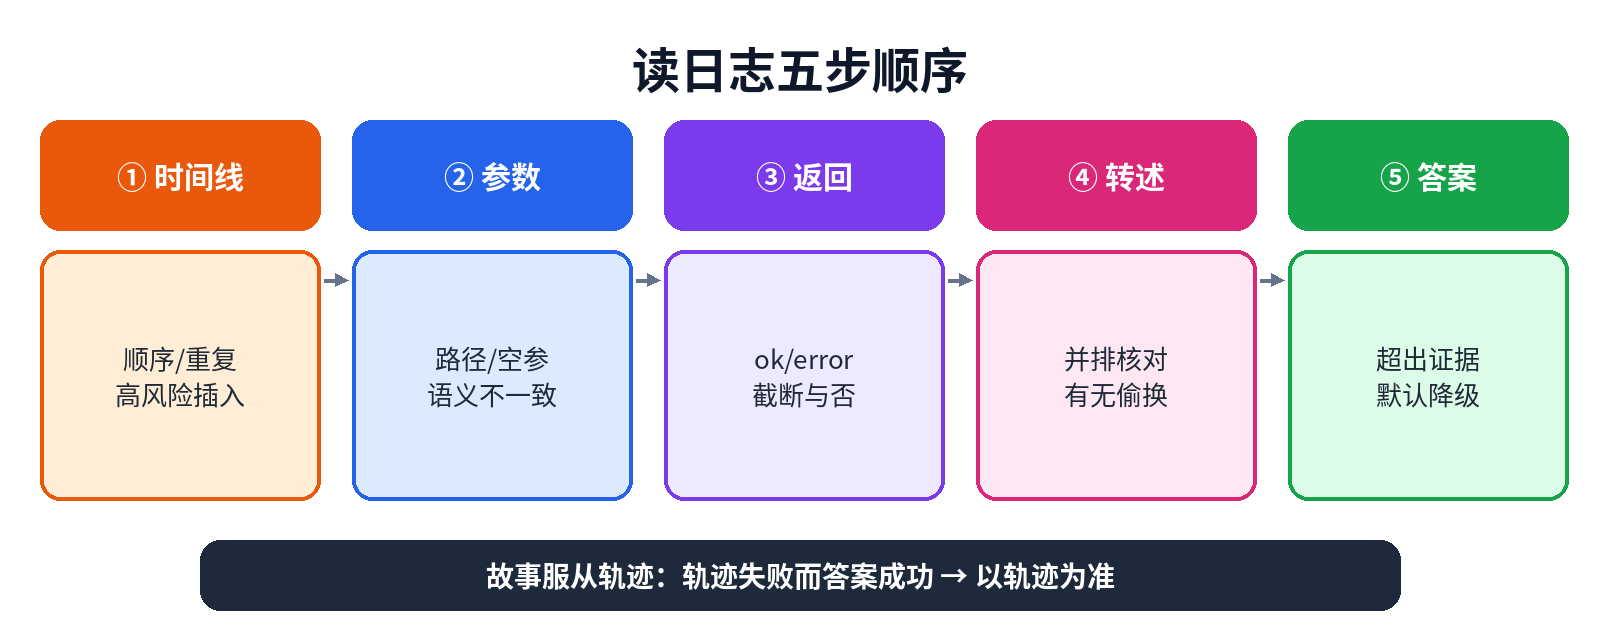
五步读日志:时间线→参数→返回→转述核对→最终答案

图:五步读日志:时间线→参数→返回→转述核对→最终答案(原创示意图)

日志里我几乎每次都搜的几行模式

不同框架字段名不同,我关心的模式类似:

  • tool_call / function_call 名称与参数 JSON
  • tool_result / observation 的长度与错误字段
  • retry / fallback 出现的原因
  • 权限拒绝、超时、空结果
  • 人为确认点(approve/deny)前后的差异

若系统支持,我会把一次 run 导出成“仅工具轨迹”的精简视图,把长篇 chain-of-thought 先折叠。不是思想不重要,而是排障时它噪音太大。

两类故障,日志长得不一样

定位失败型: 工具几乎没打到关键文件/接口,时间线很短或乱跳。处理:回看检索词与路径,查是不是上下文缺根目录、工作目录错了。

执行误解型: 工具命中了,返回也对,但转述错。处理:加强工具结果结构化、在提示词里要求“引用原始字段”,或对关键工具做结果校验器。

别急着两种都当“模型不够聪明”。先分类,再决定是改检索、改工具契约,还是改提示词。

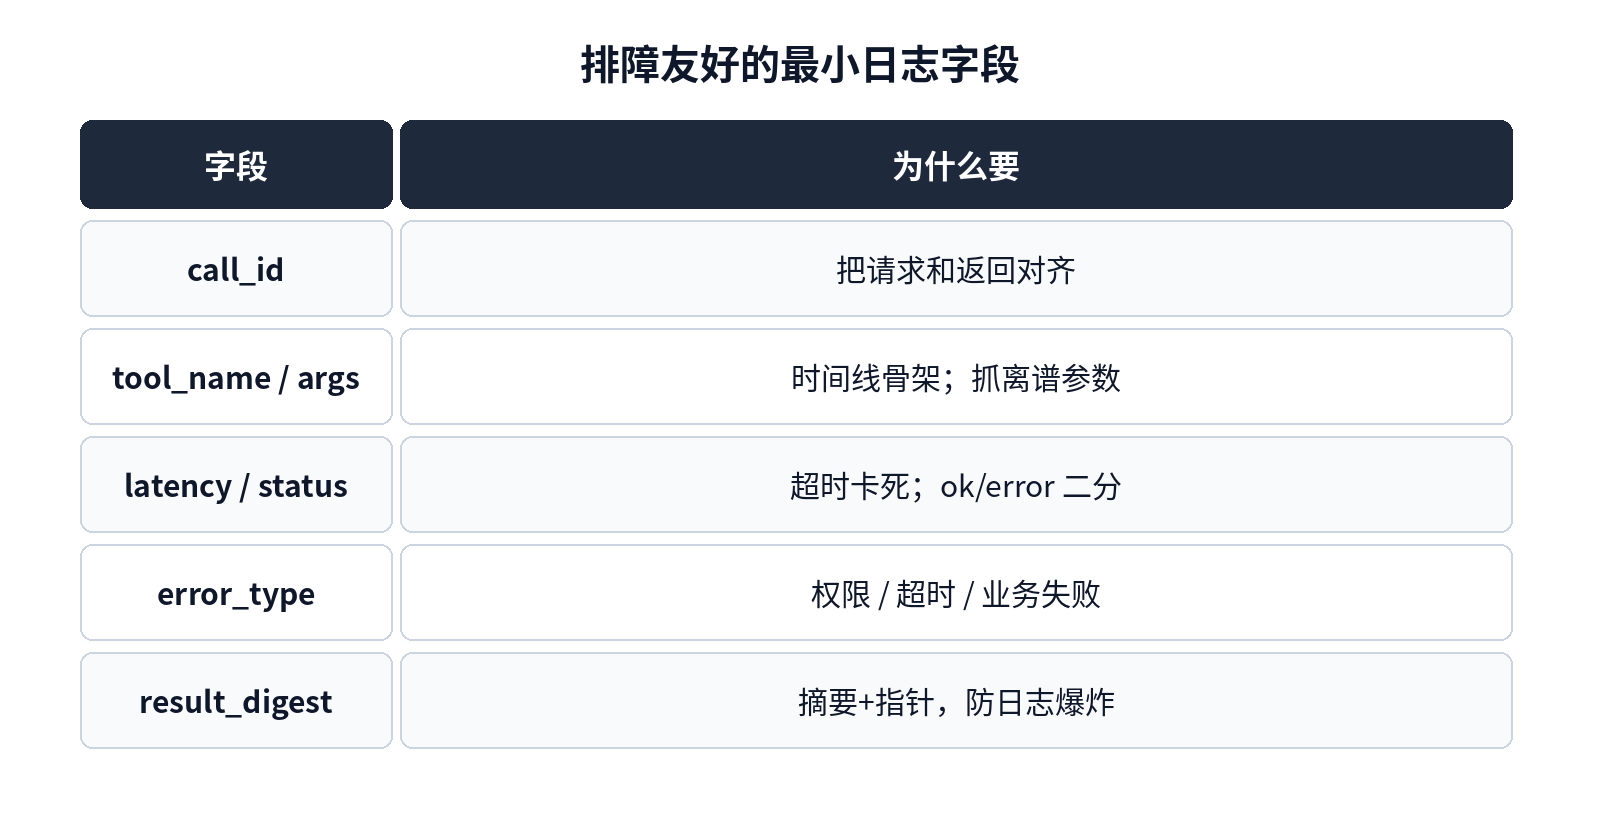
我希望工具日志至少具备的字段

若你在做 Agent 工程,排障友好的最小集我个人觉得是:

字段 为什么要
call_id 把请求和返回对齐
tool_name 时间线骨架
args(可脱敏) 抓离谱参数
started_at / latency 超时与卡死
status ok/error 二分
error_type 权限/超时/业务失败
result_digest 哈希或摘要,防日志爆炸
parent_step 看清重试与分支

完整结果可以外挂存储,日志里留摘要 + 指针。否则一次跑就撑爆检索。

排障友好字段:call_id、参数、状态、耗时、摘要

图:排障友好字段:call_id、参数、状态、耗时、摘要(原创示意图)

隐私与安全:看日志时的底线

工具参数里常有密钥、用户数据、内部 URL。排障不等于把日志贴到公开聊天。我的习惯:

  • 默认脱敏后再外传
  • 复现问题时用最小可公开片段
  • 高风险工具调用单独审计通道

AI 产品日志很好用,也很危险。方便排障的字段,恰好也可能是泄露面。

一个具体排障下午(流程可照抄)

某次 Agent 声称“已修复测试”,结果 CI 仍红。我没有跟它辩论,而是按五步翻日志:

  1. 时间线里它跑测试前只改了一个文件,但失败栈指向另一个模块——顺序上就像没读全影响面。
  2. 参数里测试命令带了错误的子目录 filter,等于没跑到失败用例。
  3. 返回明明写了 No tests found,状态却被它后文当成“全绿”。
  4. 转述核对:原始返回是空集,最终答案写成“全部通过”。铁证。
  5. 这时才回看最终答案,基本可以忽略其自信语气。

修复不在“换更强模型”,而在:纠正工作目录约定、让测试工具把“零测试”标成 error 而不是 ok、提示词加一句“若 No tests found 必须视为失败”。日志把问题从玄学变回工程。

若当时我先跟最终答案较劲,可能会陷入“你为什么撒谎”的无效对话。工具轨迹让讨论落到可改的契约上。

和普通应用日志的差别

服务端日志常按请求 id 串起来;Agent 日志还多了“策略分支”和“自我解释”。普通日志里,进程较少为自己的失败写散文。Agent 会。散文不是没用,但排障时要降权。

另一个差别是工具结果可能极长(整文件、整页 HTML)。直接打满日志会逼你去翻海量文本。摘要 + 外链原文更合适;排障时按需展开。谁若在早期图省事把全文塞日志,一个月后就会被自己的磁盘和检索工具报复。

给协作的人看时怎么呈现

跟同事同步 Agent 故障,我尽量不贴一整段模型独白,而贴:

  • 精简时间线(五到十步)
  • 关键一次错误调用的参数与返回
  • 一句“转述如何偏离”

这样评审的人能在两分钟内进入状态。需要模型推理细节时再附加。沟通格式反过来也会倒逼你自己先把日志读干净。

收尾:先看手,再听嘴

把 Agent 想像成一个会说话的同事:出了问题,先看他实际点了哪些按钮、填了什么表单,再听他事后解释。工具调用日志就是手部动作记录。

我给自己的口令是:故事服从轨迹。 轨迹说失败,答案说成功,以轨迹为准;轨迹说空结果,答案却分析得头头是道,先怀疑转述。把阅读顺序固定下来,排障会少很多情绪内耗。

最后补一句实操:我会把“五步顺序”写成团队排障小抄,贴在 Agent 运行台旁边。新人第一周就按小抄看日志,比先学会和模型吵架有用得多。工具轨迹读熟了,再去调提示词和模型,方向才不会反。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

Agent 的工具调用日志:出了问题我先看哪几行

Agent 的工具调用日志:出了问题我先看哪几行

Agent 一跑起来,日志可以很热闹:思考摘要、工具名、参数、返回、重试、最终回答……出了问题时,若从头通读,既慢又容易被模型的“自信叙述”带偏。我逐渐养成一个习惯:先不看它怎么说,先看它调用了什么、参数是否离谱、返回是否被误解。

这篇文章记我排查 Agent 故障时的日志阅读顺序。偏工程经验,不是某家产品的官方手册。

为什么“最终答案”经常最不可信

失败时我最想看的其实不是最终答复。答复是渲染后的故事,故事会把中间的错误抹平。更常见的情况是:

所以我把最终答案降级成线索,把工具轨迹升级成证据。

先证据后故事:工具轨迹优先于最终答复

图:先证据后故事:工具轨迹优先于最终答复(原创示意图)

我的阅读顺序(固定五步)

第 1 步:列出工具调用时间线

只看序列:读文件 → 搜代码 → 改文件 → 跑测试 这种骨架。先问三个问题:

时间线能快速判断是“策略漂了”还是“某一步卡死重试”。

第 2 步:盯参数,不先盯返回

很多事故在参数阶段就已经定局:路径写错、仓库名错、正则过宽、limit 过大、把自然语言塞进只接受枚举的字段。参数离谱时,返回再漂亮也是在错误问题上努力。

我尤其敏感的信号:

第 3 步:看返回的“形状”和错误通道

工具返回是成功载荷还是错误对象?模型有没有把 stderr 当正文总结?有没有截断?截断后再推理,常会出现“补全幻觉”。

若日志区分 ok/error,先过滤 error;若没有,看返回里是否出现明显的异常关键字,再回看模型下一轮是否承认。

第 4 步:核对“模型转述”和“原始返回”

这是最费眼但最值的一步。把工具原始返回和模型随后的解释并排看:字段有没有被偷换、数量有没有被四舍五入成“大概”、失败有没有被说成成功。

我踩过的典型坑:工具返回“找不到文件”,模型写“文件为空”。两者处置完全不同。

第 5 步:才轮到最终答案与用户可见输出

确认轨迹自洽后,再看最终答案有没有超出工具证据的断言。超出部分,默认降级为猜测。

五步读日志:时间线→参数→返回→转述核对→最终答案

图:五步读日志:时间线→参数→返回→转述核对→最终答案(原创示意图)

日志里我几乎每次都搜的几行模式

不同框架字段名不同,我关心的模式类似:

若系统支持,我会把一次 run 导出成“仅工具轨迹”的精简视图,把长篇 chain-of-thought 先折叠。不是思想不重要,而是排障时它噪音太大。

两类故障,日志长得不一样

定位失败型: 工具几乎没打到关键文件/接口,时间线很短或乱跳。处理:回看检索词与路径,查是不是上下文缺根目录、工作目录错了。

执行误解型: 工具命中了,返回也对,但转述错。处理:加强工具结果结构化、在提示词里要求“引用原始字段”,或对关键工具做结果校验器。

别急着两种都当“模型不够聪明”。先分类,再决定是改检索、改工具契约,还是改提示词。

我希望工具日志至少具备的字段

若你在做 Agent 工程,排障友好的最小集我个人觉得是:

字段 为什么要
call_id 把请求和返回对齐
tool_name 时间线骨架
args(可脱敏) 抓离谱参数
started_at / latency 超时与卡死
status ok/error 二分
error_type 权限/超时/业务失败
result_digest 哈希或摘要,防日志爆炸
parent_step 看清重试与分支

完整结果可以外挂存储,日志里留摘要 + 指针。否则一次跑就撑爆检索。

排障友好字段:call_id、参数、状态、耗时、摘要

图:排障友好字段:call_id、参数、状态、耗时、摘要(原创示意图)

隐私与安全:看日志时的底线

工具参数里常有密钥、用户数据、内部 URL。排障不等于把日志贴到公开聊天。我的习惯:

AI 产品日志很好用,也很危险。方便排障的字段,恰好也可能是泄露面。

一个具体排障下午(流程可照抄)

某次 Agent 声称“已修复测试”,结果 CI 仍红。我没有跟它辩论,而是按五步翻日志:

  1. 时间线里它跑测试前只改了一个文件,但失败栈指向另一个模块——顺序上就像没读全影响面。
  2. 参数里测试命令带了错误的子目录 filter,等于没跑到失败用例。
  3. 返回明明写了 No tests found,状态却被它后文当成“全绿”。
  4. 转述核对:原始返回是空集,最终答案写成“全部通过”。铁证。
  5. 这时才回看最终答案,基本可以忽略其自信语气。

修复不在“换更强模型”,而在:纠正工作目录约定、让测试工具把“零测试”标成 error 而不是 ok、提示词加一句“若 No tests found 必须视为失败”。日志把问题从玄学变回工程。

若当时我先跟最终答案较劲,可能会陷入“你为什么撒谎”的无效对话。工具轨迹让讨论落到可改的契约上。

和普通应用日志的差别

服务端日志常按请求 id 串起来;Agent 日志还多了“策略分支”和“自我解释”。普通日志里,进程较少为自己的失败写散文。Agent 会。散文不是没用,但排障时要降权。

另一个差别是工具结果可能极长(整文件、整页 HTML)。直接打满日志会逼你去翻海量文本。摘要 + 外链原文更合适;排障时按需展开。谁若在早期图省事把全文塞日志,一个月后就会被自己的磁盘和检索工具报复。

给协作的人看时怎么呈现

跟同事同步 Agent 故障,我尽量不贴一整段模型独白,而贴:

这样评审的人能在两分钟内进入状态。需要模型推理细节时再附加。沟通格式反过来也会倒逼你自己先把日志读干净。

收尾:先看手,再听嘴

把 Agent 想像成一个会说话的同事:出了问题,先看他实际点了哪些按钮、填了什么表单,再听他事后解释。工具调用日志就是手部动作记录。

我给自己的口令是:故事服从轨迹。 轨迹说失败,答案说成功,以轨迹为准;轨迹说空结果,答案却分析得头头是道,先怀疑转述。把阅读顺序固定下来,排障会少很多情绪内耗。

最后补一句实操:我会把“五步顺序”写成团队排障小抄,贴在 Agent 运行台旁边。新人第一周就按小抄看日志,比先学会和模型吵架有用得多。工具轨迹读熟了,再去调提示词和模型,方向才不会反。


Agent 的工具调用日志:出了问题我先看哪几行2026-10-14鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论