

AI 写文档很快:README、函数注释、模块说明,几秒就能铺满。我早期几乎照单全收,后来越来越频繁地整段删掉重写。不是因为文笔不好,而是因为很多生成文档在“正确的废话”和“过时的细节”之间晃,读的人费时间,维护的人更痛苦。
这篇文章记我什么时候信它、什么时候动手砍,以及重写时我保什么、扔什么。
生成文档最常见的三种病
1. 正确的废话
“本模块用于处理订单相关逻辑,提供创建、查询与更新能力。”——读完等于没读。它没有告诉我边界、不变量、也没有告诉我别乱用的地方。
2. 和代码赛跑的细节
把当前参数列表、每一步实现按行复述一遍。代码一改,注释就撒谎。AI 特别擅长写这种“现在时”的说明,因为它看见的就是此刻源码。
3. 乐观的完整性
README 里列出“特性:支持 A/B/C/D”,其中有的是实验代码,有的是计划,有的是它从函数名脑补的。看起来很全能,新来的同事按文档调用,踩坑。
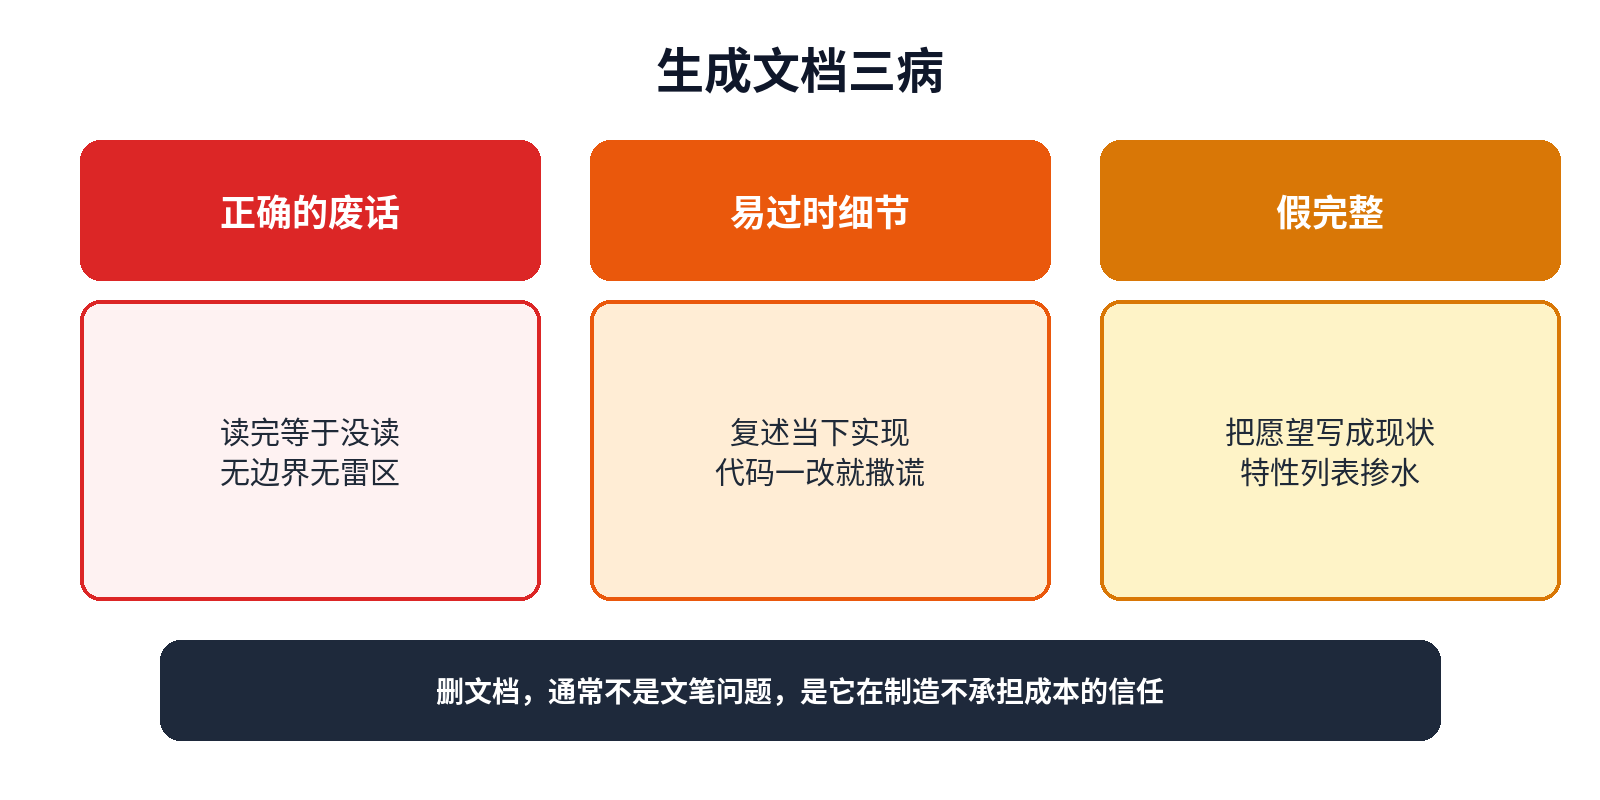
图:生成文档三病:废话、易过时细节、假完整(原创示意图)
这三种病可以共存。我删文档,通常不是因为“写得不优雅”,而是因为它在制造信任,却不承担信任的成本。
我先问:这份文档的读者是谁
动手前我会先定读者,读者不同,去留标准不同。
未来的自己(两周后):要的是“为什么这样”和“坑在哪”,不要讲义式介绍
同队同事:要的是如何本地跑起来、关键约定、别踩的雷
外部使用者:要的是稳定的接口契约与示例,少谈内部实现
只是应付开源模板:那我更倾向短而真,而不是长而假
AI 默认常常写成“给所有人看的产品说明书”。没有读者,就只能堆形容词。
什么可以留,什么必须砍
我的粗暴规则:
可留(常作草稿):
安装与启动的命令草稿(仍需我跑一遍核对)
目录结构的第一版地图
根据代码归纳的“公开方法列表”初稿
英文注释的语法顺句(再由我改术语)
必砍或重写:
没有新信息的段落(删了不影响做事)
复述代码一目了然的逻辑
无法指出来源的“最佳实践”口吻
把愿望写成现状的特性列表
过长的背景故事(仓库不是博客)
一条经验:若一段话不能通过“删掉会不会让人多踩坑”的测试,就删。文档的价值是减少踩坑,不是增加字数。
注释:写“为什么”,少写“做了什么”
函数注释里,AI 最爱写:
遍历列表,过滤无效项,返回结果。
这是“做了什么”,而代码本身通常已经写了。我更想看到:
这里过滤的是“软删除且超过保留期”的项;保留期内的软删除仍要参与对账,不要改成直接跳过所有 deleted=true。
后者是为什么和别乱改。AI 只有在你提供背景时才写得出这种话;你若不说,它只能复述代码。
所以我的流程经常是:先让它生成注释 → 我删掉复述句 → 补上业务约束与历史坑 → 必要时再让它帮我把句子压短。重写不是从头手打每字,是换内容类型。
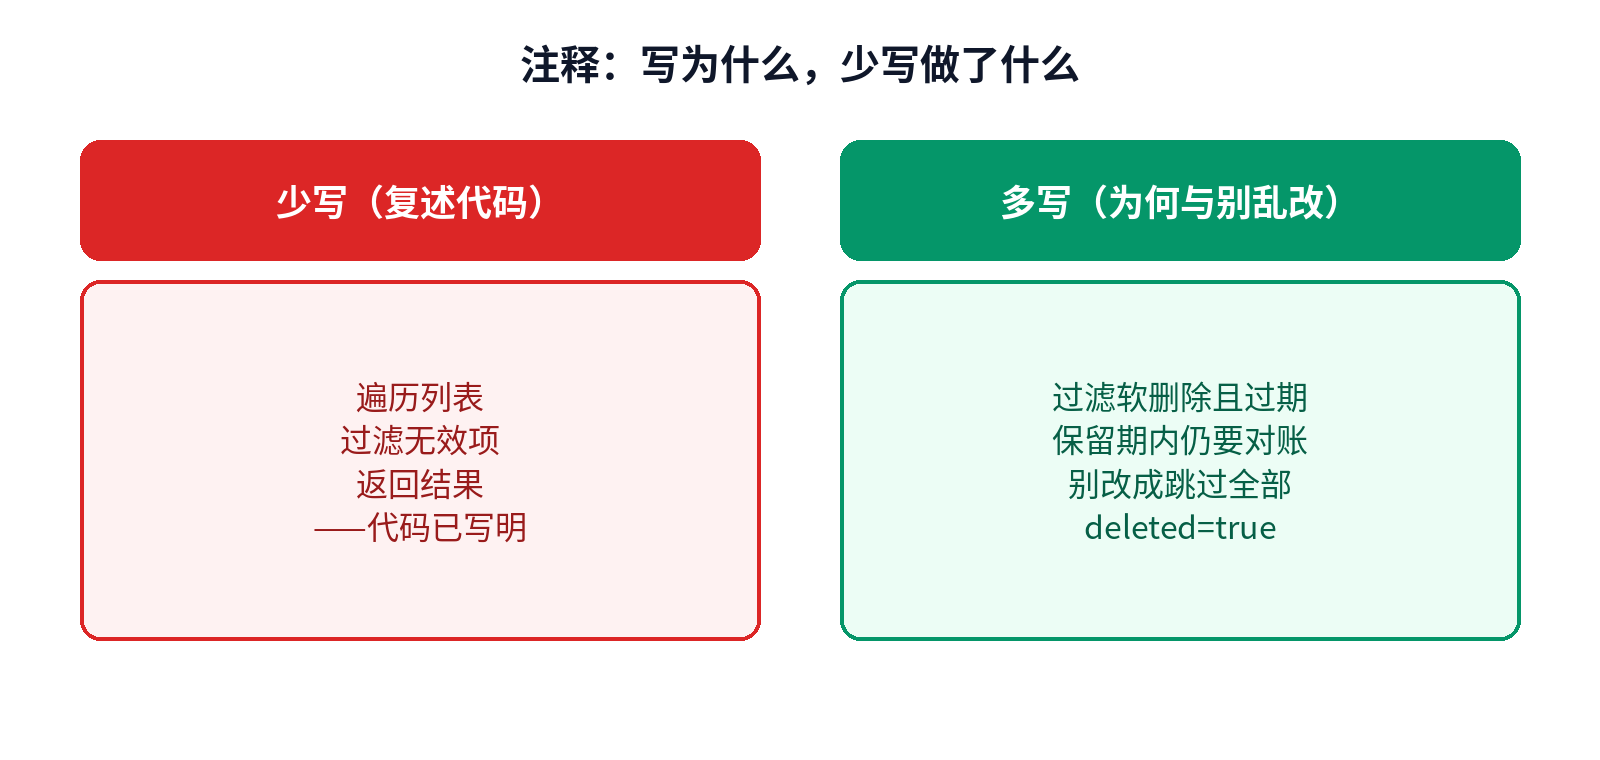
图:注释取舍:复述代码 vs 写清为何与别乱改(原创示意图)
README:宁可短,也不要假完整
我现在的 README 骨架很短:
一句话这项目是干什么的(非口号)
如何在最小环境跑起来(我亲自跑过的命令)
关键配置与默认端口
目录导读(只到“你该先看哪几个文件”)
已知限制与非目标(明确说不做什么)
如何贡献/提问(若需要)
AI 生成的长 README,我常先剪成这个骨架,再往回填。剪的时候心理压力会小很多:不是否定 AI,是拒绝虚假的全面。
“非目标”一节特别值得手写。AI 很少主动写“我们不做什么”,但它能极大降低误用。例如:“本工具不做权限系统,请在网关层解决。”这句话比三段形容词有用。
一个我删掉重写的过程(可照抄节奏)
让 AI 根据代码生成 README 或注释草稿
我通读,用颜色或标记标出:废话 / 易过时 / 可疑完整
整段删除废话;易过时细节改成“见代码/见类型”
手写“为什么、限制、坑”
再让 AI 只做一件事:把我的要点改得更短更顺,禁止新增特性声称
本地按 README 走一遍,命令不对就改文档,不改记忆
第 5 步的“禁止新增”很重要。否则它又会好心帮你补回假完整。
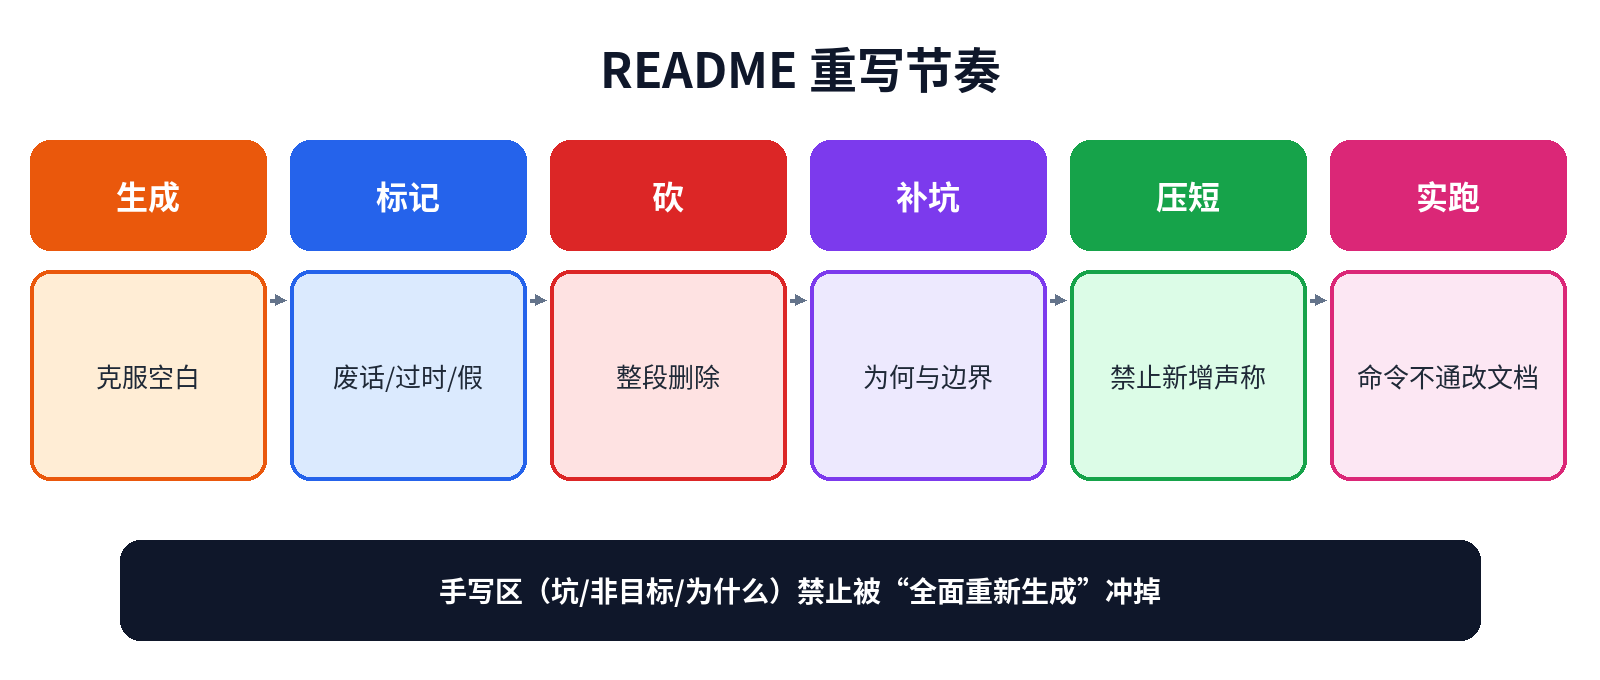
图:README 重写节奏:生成→标记→砍→补坑→压短→实跑(原创示意图)
文档测试:把说明当代码的弱类型
我逐渐把关键文档步骤当成“弱测试”:新同事或未来的我,按文档做,做不通就是文档 bug。AI 生成后再实跑,是最低成本的测试。
对注释,测试更软:做 code review 时问“这句注释若删掉,读者会不会误解不变式?”会,就留;不会,就删。
为什么我仍要用 AI 写文档
听起来我在全面否定,其实不是。AI 适合:
克服空白页:先有结构再砍
把我的要点改通顺
从代码提取“可能需要文档化”的公开面清单
多语言草稿(再由人校对术语)
它不适合独自负责“真实性”。真实性来自你跑过的命令、你踩过的坑、你承诺的边界。这些东西不在权重里,在你的经验里。
和“代码即文档”派怎么和解
有一种观点:代码写清楚就不需要注释。我部分同意——尤其反对复述型注释——但不同意因此把 README 和边界说明也砍光。代码回答“现在做什么”;文档更该回答“别做成别的什么”和“怎样安全地用”。
AI 恰好站在中间:它能把代码翻译成说明,于是人们误以为翻译完成了文档工作。真正缺的往往是代码里写不出来的约束:兼容窗口、迁移顺序、哪类流量还不能切、哪个开关有副作用。这些仍得人写;AI 最多帮你改句子。
团队协作时怎么避免“文档被重新生成覆盖”
还有个工程问题:有人把“用 AI 从代码重新生成 README”当成日常同步手段。代码一变,文档全量重生,于是手写的坑与非目标被冲掉。我见过两次这种回归,后来约定:
生成只发生在新建模块的第一天
之后只允许局部更新(安装命令、端口、公开 API 列表)
“坑 / 非目标 / 为什么”段落标记为手写区,禁止无审阅覆盖
若一定要用生成器,就把手写区拆到单独文件再 include,别和可生成段落混在一个会被整文件覆盖的地方。这是流程问题,不是文笔问题。
有一次我自己也犯浑:觉得手写 README 过时了,让 AI 按最新代码“全面更新”。更新完确实更贴函数名,但那节“不要在生产开某某调试开关”消失了——因为它不在代码里。隔周就有人踩雷。从那以后,全面更新对我约等于高风险操作,默认改成补丁式更新。
收尾:删掉是为了少撒谎
我经常删掉 AI 写的 README 和注释,不是洁癖,是害怕仓库里留下读起来很安心、做起来很坑的文字。文档一旦撒谎,比没有文档更贵——因为它浪费信任。
给自己的口令是:生成可以快,发布前必须能删。 能删掉仍不影响做事的句子,就不该占着坑;删完之后若空了,说明该写的是坑与边界,不是形容词。
 2026-10-14鱼鱼