
给 Agent 设超时和步数预算:别让它无限跑

  created  by  鱼鱼 {{tag}}
创建于 2026年10月13日 09:39:18 最后修改于 2026年10月14日 18:25:12

第一次把 Agent 接到真实仓库时,我犯过一个很土的错:只盯着“它能不能做完”,没盯着“它最多能跑多久、最多能走几步”。结果某次工具调用卡在外部接口,它一边重试一边换策略,token 和墙钟时间一起烧,最后我手动杀掉,现场还一堆半成品文件。

从那以后,我把超时和步数预算当成和权限同级的安全项。不是为了虐待 Agent,而是承认:自动化一旦没有硬上限,失败模式会从“报错”变成“悄悄耗尽”。

为什么“看起来快结束”不可靠

Agent 的轨迹很会制造希望:每一步都有日志,每一步都像在进步。可进步不等于收敛。常见假象包括:

  • 同一类错误换着措辞重试

  • 在几个文件间来回改,测试始终红

  • 搜索范围越扩越大,上下文越来越脏

  • 等待外部资源时既不失败也不成功

没有预算时,你只能靠盯盘。盯得了一次,盯不了每次。预算的意义是:到点必须停,停了才能进入人类决策,而不是无限接近成功。
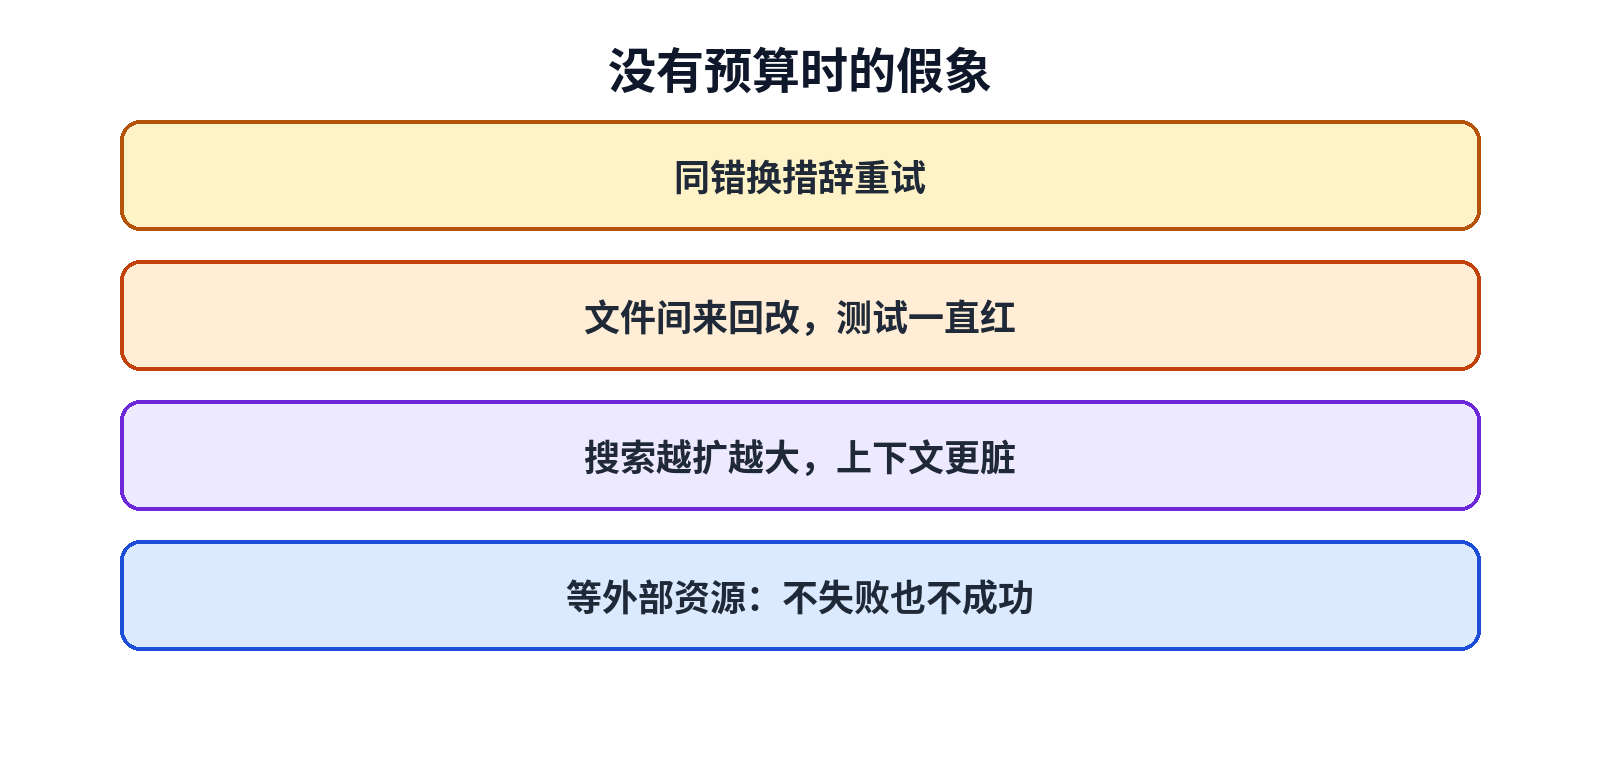
没有预算时的假象:盲重试、来回改、搜索膨胀、干等

图:没有预算时的假象:盲重试、来回改、搜索膨胀、干等(原创示意图)

我设的两类上限

1. 时间上限(墙钟超时)

针对整次任务,也针对单次工具调用。

  • 任务级: 例如本地小改最长 15 分钟,调研类最长 30 分钟。超时后保存状态、退出,而不是“再试一轮”。

  • 工具级: 网络请求、安装、测试套件,各自有更短超时。避免一个慢调用拖死整次运行。

时间上限要按环境调:CI 机器和笔记本不同,外网和内网不同。我的原则是宁短勿长——短了可以人工续跑;长了账单和脏现场先来。

2. 步数 / 工具调用预算

把“一步”定义清楚:一次模型回复、或一次工具调用、或两者合计。我个人常用的是:

  • 简单定位 bug:最多 N 次工具调用

  • 跨模块重构:放宽,但仍有上限,且写操作预算更紧

  • 纯只读调研:步数可稍宽,但时间仍卡死

步数预算能挡住“逻辑上不收敛但一直在动”的情况。光有时间不够:机器很快时,一分钟也能空转上百步。
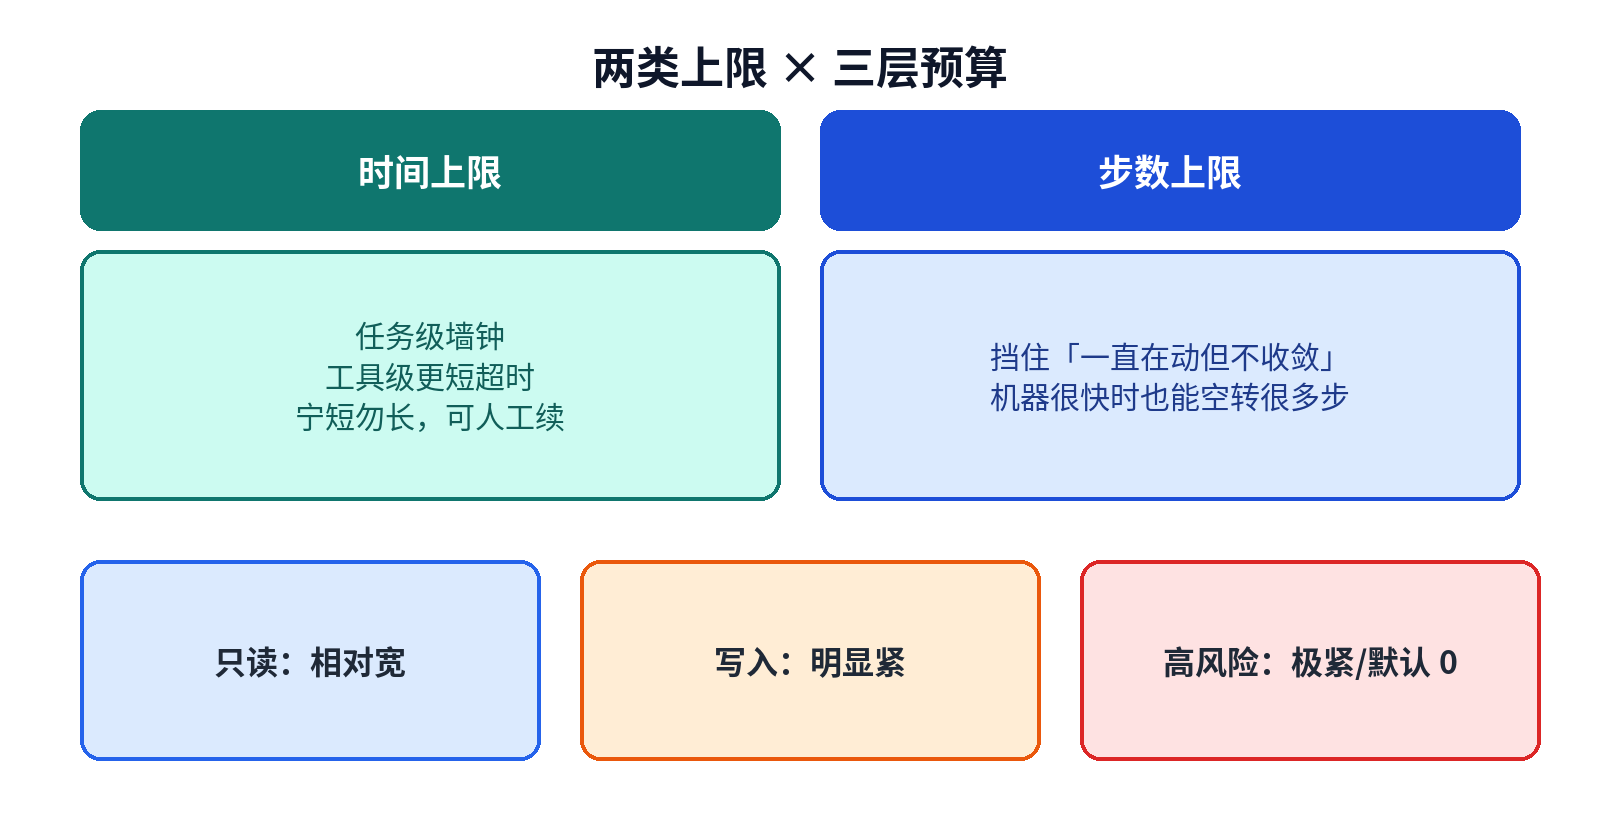
两类上限与三层预算:时间、步数、只读/写入/高风险

图:两类上限与三层预算:时间、步数、只读/写入/高风险(原创示意图)

预算要分层,不要一刀切

我现在会把预算拆成三层:

  1. 只读预算: 搜索、读文件、跑只读检查——相对宽

  2. 写操作预算: 改文件、格式化、本地提交——明显更紧

  3. 高风险预算: 推远程、改基础设施、装依赖、删数据——极紧,甚至默认 0,必须人类抬栏

这样 Agent 可以在只读阶段多探索,但不容易在写阶段把仓库拧成麻花。以前我用单一总预算,它会把步数花在反复写入上;分层之后,写入花超会提前停,留下更多只读线索给人类。

超时后做什么,比超时本身更重要

超时不是成功,也不是简单失败。我要求运行时至少做三件事:

  1. 冻结现场: 记录最后目标、已改文件列表、最后错误签名

  2. 尽量可恢复: 能 git 恢复就恢复到安全点;不能恢复就明确标“脏”

  3. 给人类一句可读摘要: 别只甩原始日志;说明卡在哪一类问题上

没有这三步,超时等于制造烂摊子。有了这三步,超时是一次可交接的暂停。

和重试策略的关系

预算不是禁止重试,而是给重试封顶。我的经验是:

  • 瞬时网络错误:短重试 + 退避,计入工具级超时

  • 同一错误签名重复出现:不要吞预算盲重试,直接换路或停

  • 写失败:默认不自动重试,先报告

“再试一次”很便宜的错觉,在 Agent 场景里特别危险,因为它会乘以模型调用和后续推导。预算表上的数字,就是用来对抗这种错觉的。
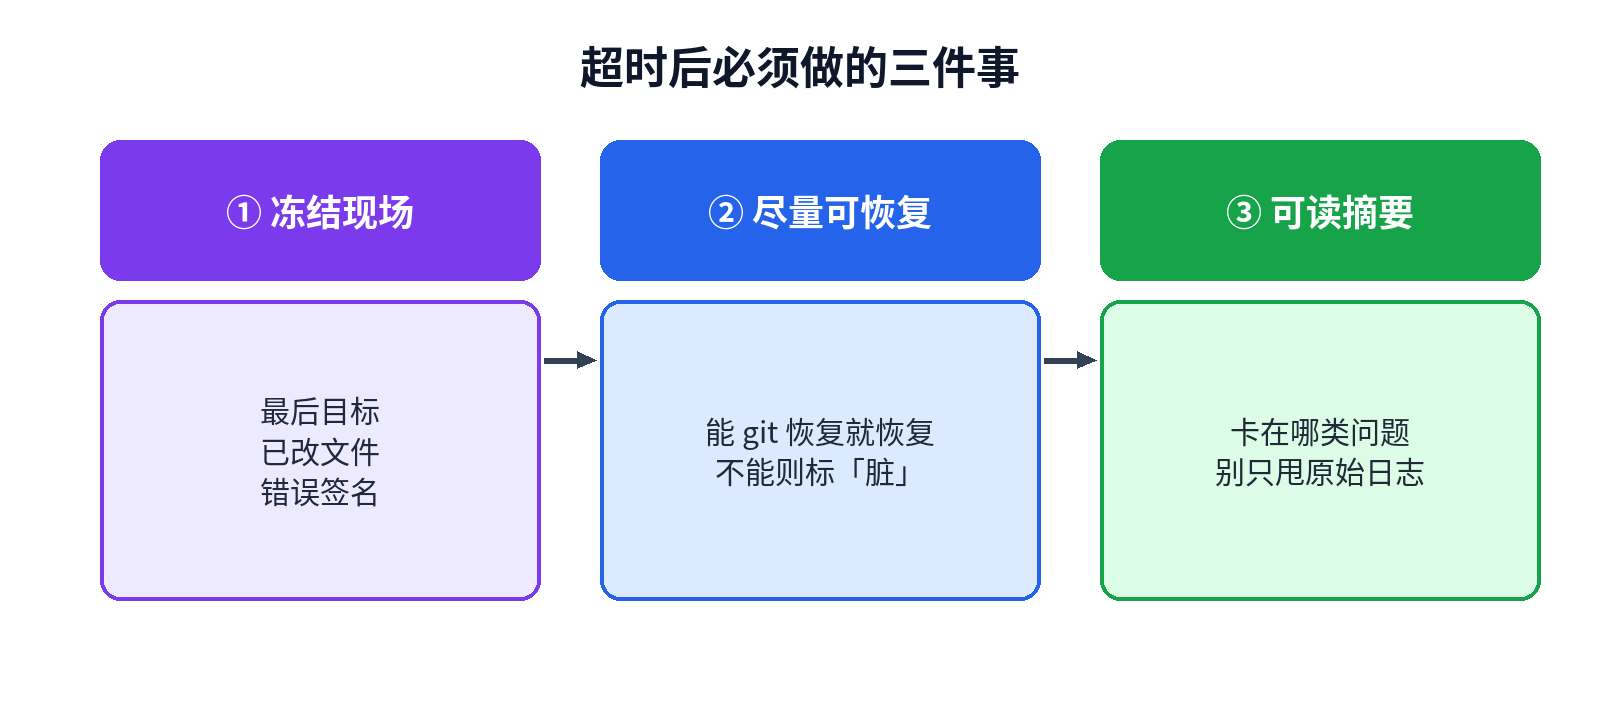
超时后三件事:冻结现场、可恢复、可读摘要

图:超时后三件事:冻结现场、可恢复、可读摘要(原创示意图)

怎么观测:没有计数就不算设了预算

我踩过的另一个坑是:配置里写了 max_steps=20,但日志里看不到当前步数,挂了才发现计数器没接上。

所以上线预算时,我会同时要:

  • 每步日志带 step=i/max

  • 任务结束带原因:completed / timeout / budget_exhausted / aborted_by_user

  • 简单仪表:近一周因预算耗尽停下的比例

若耗尽比例奇高,可能是任务切得太大,或工具太容易失败;若几乎从不为预算停下,可能是上限虚高,等于没设。

给产品/业务同学的一句话翻译

如果你不写 Agent 运行时,只需要记住:

任何会自己循环调用模型或工具的东西,都要有“最多跑多久、最多走几步”的硬开关;开关触发后必须能安全停,并且告诉人卡在哪。

这和网页请求超时是同一类工程常识,只是 Agent 的循环更隐蔽,更容易被“它还在思考”安慰过去。

实操上我怎么写进任务说明

给 Agent 的任务提示里,我会显式写:

  • 本任务墙钟上限

  • 工具调用上限

  • 允许的写操作次数

  • 超时后必须输出的摘要字段

写进提示,不只是写进平台配置。原因是:有的 Agent 会自己开子任务;提示里的预算意识,能减少它在子任务里“假装没有上限”。当然,真正强制仍靠运行时;提示只是双保险。

收尾

给 Agent 设超时和步数预算,本质是承认自动化会失败,而且失败可能很贵。我的默认立场是:

  • 时间与步数都要有硬上限

  • 只读、写入、高风险分层

  • 超时必须可交接,不可只杀进程

  • 日志里要看得见计数与停止原因

别让它无限跑。 宁肯多次短跑 + 人类续杯,也不要一次长跑烧出不可解释的现场。预算不是冷漠,是对系统和账单的基本礼貌。

预算数字从哪来:我怎么定初始值

没有神圣数字,只有可调整的起点。我的起点通常是:

  • 个人本机、小修复:15 分钟,工具调用 25 次,写操作 8 次

  • 功能开发会话:30 分钟,工具调用 40 次,写操作 15 次

  • 只读调研:20 分钟,工具调用 40 次,写操作 0

跑一周看耗尽率。若总是在还差一口气时耗尽,说明任务切太大或上限略紧,就微调;若几乎从不触顶,把上限降下来,逼任务更早暴露不收敛。

数字写进配置,也写进周记。靠感觉调,最后会漂回“反正给大一点”。

子 Agent 的预算怎么切

一旦有子 Agent,总预算要切块,而不是每个子 Agent 各自拿一份满额。否则五个子任务等于五倍账单。我的做法是:父任务持有总预算,子任务申请配额;父任务可回收未用完的配额。实现可简可繁,但概念上要有“同一笔钱”。

若平台还不支持配额下发,至少在提示里写死子任务上限,并在父任务日志核对。软约束好过没有。

超时与用户体验

对人可见的产品里,超时要转换成可读状态:“已暂停:达到时间上限,你可以续跑或收窄任务。”不要只显示转圈消失。对内工具也一样:给续跑按钮,等于承认预算是暂停而非死刑。

续跑时应继承冻结现场,而不是从零再探索一遍。否则预算系统只是把一次长烧变成多次长烧。

和成本告警的配合

步数/时间是近端保险丝,账单告警是远端保险丝。我建议两层都有:

  • 近端:单任务立刻停

  • 远端:日/周额度告警,防止很多小任务合谋杀死预算

只有远端时,单任务仍可能失控很久;只有近端时,小任务洪水仍可能把月账单打穿。

失败案例(简化复盘)

一次“帮我把测试弄绿”的任务,没有写操作分层。Agent 在失败断言间反复改实现、改测试、再改实现,步数耗在写入上,最后测试仍红,工作区却已难读。若当时写操作预算为 5,它会更早停在“测试仍红,已尝试的方向如下”,我就能接手做判断。预算不是让它更聪明,是让失败更干净。

收尾补一句

时间和步数都要有硬上限。 上限会冒犯那种“再给我两分钟就能好”的幻觉——恰恰该冒犯。自动化值得拥有的,是可控的短跑,不是浪漫的长跑。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

给 Agent 设超时和步数预算:别让它无限跑

给 Agent 设超时和步数预算:别让它无限跑

第一次把 Agent 接到真实仓库时,我犯过一个很土的错:只盯着“它能不能做完”,没盯着“它最多能跑多久、最多能走几步”。结果某次工具调用卡在外部接口,它一边重试一边换策略,token 和墙钟时间一起烧,最后我手动杀掉,现场还一堆半成品文件。

从那以后,我把超时和步数预算当成和权限同级的安全项。不是为了虐待 Agent,而是承认:自动化一旦没有硬上限,失败模式会从“报错”变成“悄悄耗尽”。

为什么“看起来快结束”不可靠

Agent 的轨迹很会制造希望:每一步都有日志,每一步都像在进步。可进步不等于收敛。常见假象包括:

没有预算时,你只能靠盯盘。盯得了一次,盯不了每次。预算的意义是:到点必须停,停了才能进入人类决策,而不是无限接近成功。

没有预算时的假象:盲重试、来回改、搜索膨胀、干等

图:没有预算时的假象:盲重试、来回改、搜索膨胀、干等(原创示意图)

我设的两类上限

1. 时间上限(墙钟超时)

针对整次任务,也针对单次工具调用。

时间上限要按环境调:CI 机器和笔记本不同,外网和内网不同。我的原则是宁短勿长——短了可以人工续跑;长了账单和脏现场先来。

2. 步数 / 工具调用预算

把“一步”定义清楚:一次模型回复、或一次工具调用、或两者合计。我个人常用的是:

步数预算能挡住“逻辑上不收敛但一直在动”的情况。光有时间不够:机器很快时,一分钟也能空转上百步。

两类上限与三层预算:时间、步数、只读/写入/高风险

图:两类上限与三层预算:时间、步数、只读/写入/高风险(原创示意图)

预算要分层,不要一刀切

我现在会把预算拆成三层:

  1. 只读预算: 搜索、读文件、跑只读检查——相对宽

  2. 写操作预算: 改文件、格式化、本地提交——明显更紧

  3. 高风险预算: 推远程、改基础设施、装依赖、删数据——极紧,甚至默认 0,必须人类抬栏

这样 Agent 可以在只读阶段多探索,但不容易在写阶段把仓库拧成麻花。以前我用单一总预算,它会把步数花在反复写入上;分层之后,写入花超会提前停,留下更多只读线索给人类。

超时后做什么,比超时本身更重要

超时不是成功,也不是简单失败。我要求运行时至少做三件事:

  1. 冻结现场: 记录最后目标、已改文件列表、最后错误签名

  2. 尽量可恢复: 能 git 恢复就恢复到安全点;不能恢复就明确标“脏”

  3. 给人类一句可读摘要: 别只甩原始日志;说明卡在哪一类问题上

没有这三步,超时等于制造烂摊子。有了这三步,超时是一次可交接的暂停。

和重试策略的关系

预算不是禁止重试,而是给重试封顶。我的经验是:

“再试一次”很便宜的错觉,在 Agent 场景里特别危险,因为它会乘以模型调用和后续推导。预算表上的数字,就是用来对抗这种错觉的。

超时后三件事:冻结现场、可恢复、可读摘要

图:超时后三件事:冻结现场、可恢复、可读摘要(原创示意图)

怎么观测:没有计数就不算设了预算

我踩过的另一个坑是:配置里写了 max_steps=20,但日志里看不到当前步数,挂了才发现计数器没接上。

所以上线预算时,我会同时要:

若耗尽比例奇高,可能是任务切得太大,或工具太容易失败;若几乎从不为预算停下,可能是上限虚高,等于没设。

给产品/业务同学的一句话翻译

如果你不写 Agent 运行时,只需要记住:

任何会自己循环调用模型或工具的东西,都要有“最多跑多久、最多走几步”的硬开关;开关触发后必须能安全停,并且告诉人卡在哪。

这和网页请求超时是同一类工程常识,只是 Agent 的循环更隐蔽,更容易被“它还在思考”安慰过去。

实操上我怎么写进任务说明

给 Agent 的任务提示里,我会显式写:

写进提示,不只是写进平台配置。原因是:有的 Agent 会自己开子任务;提示里的预算意识,能减少它在子任务里“假装没有上限”。当然,真正强制仍靠运行时;提示只是双保险。

收尾

给 Agent 设超时和步数预算,本质是承认自动化会失败,而且失败可能很贵。我的默认立场是:

别让它无限跑。 宁肯多次短跑 + 人类续杯,也不要一次长跑烧出不可解释的现场。预算不是冷漠,是对系统和账单的基本礼貌。

预算数字从哪来:我怎么定初始值

没有神圣数字,只有可调整的起点。我的起点通常是:

跑一周看耗尽率。若总是在还差一口气时耗尽,说明任务切太大或上限略紧,就微调;若几乎从不触顶,把上限降下来,逼任务更早暴露不收敛。

数字写进配置,也写进周记。靠感觉调,最后会漂回“反正给大一点”。

子 Agent 的预算怎么切

一旦有子 Agent,总预算要切块,而不是每个子 Agent 各自拿一份满额。否则五个子任务等于五倍账单。我的做法是:父任务持有总预算,子任务申请配额;父任务可回收未用完的配额。实现可简可繁,但概念上要有“同一笔钱”。

若平台还不支持配额下发,至少在提示里写死子任务上限,并在父任务日志核对。软约束好过没有。

超时与用户体验

对人可见的产品里,超时要转换成可读状态:“已暂停:达到时间上限,你可以续跑或收窄任务。”不要只显示转圈消失。对内工具也一样:给续跑按钮,等于承认预算是暂停而非死刑。

续跑时应继承冻结现场,而不是从零再探索一遍。否则预算系统只是把一次长烧变成多次长烧。

和成本告警的配合

步数/时间是近端保险丝,账单告警是远端保险丝。我建议两层都有:

只有远端时,单任务仍可能失控很久;只有近端时,小任务洪水仍可能把月账单打穿。

失败案例(简化复盘)

一次“帮我把测试弄绿”的任务,没有写操作分层。Agent 在失败断言间反复改实现、改测试、再改实现,步数耗在写入上,最后测试仍红,工作区却已难读。若当时写操作预算为 5,它会更早停在“测试仍红,已尝试的方向如下”,我就能接手做判断。预算不是让它更聪明,是让失败更干净。

收尾补一句

时间和步数都要有硬上限。 上限会冒犯那种“再给我两分钟就能好”的幻觉——恰恰该冒犯。自动化值得拥有的,是可控的短跑,不是浪漫的长跑。


给 Agent 设超时和步数预算:别让它无限跑2026-10-14鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论