

前阵子我想补一块还不熟的中间件知识。打开文档、丢给 AI 一句“帮我讲讲原理和常见坑”,它讲得很顺,例子也漂亮。读完我心里有种熟悉的错觉:好像已经懂了。
第二天动手搭一个最小示例,卡在配置项和错误信息上。再回头看昨晚的“懂”,其实只是跟着叙述走了一遍,脑子里没有自己踩过的脚印。这种“看完就觉得自己会了”,是我用 AI 学习时最常踩的坑。
这篇文章不是反 AI,而是记我现在怎么用它学新技术,又怎么强制自己露馅、再补洞。写的都是个人习惯,不保证适合每个人,但对我自己很管用。
先承认:解释流畅 ≠ 你会了
AI 很擅长把陌生概念讲成一条平滑的故事线。平滑本身没问题,危险在于:故事线会掩盖你还不知道自己不知道的地方。
我以前的坏习惯是:
让它“从零讲到能上手”
一路点头,偶尔追问一句
关掉对话框,感觉已经入门
真正入门的标志,至少应该是:离开对话,你还能独立完成一个小目标,并且说得出自己为什么这么做。 如果做不到,昨晚那次就只是“听懂了别人的讲解”,不是“学会了”。
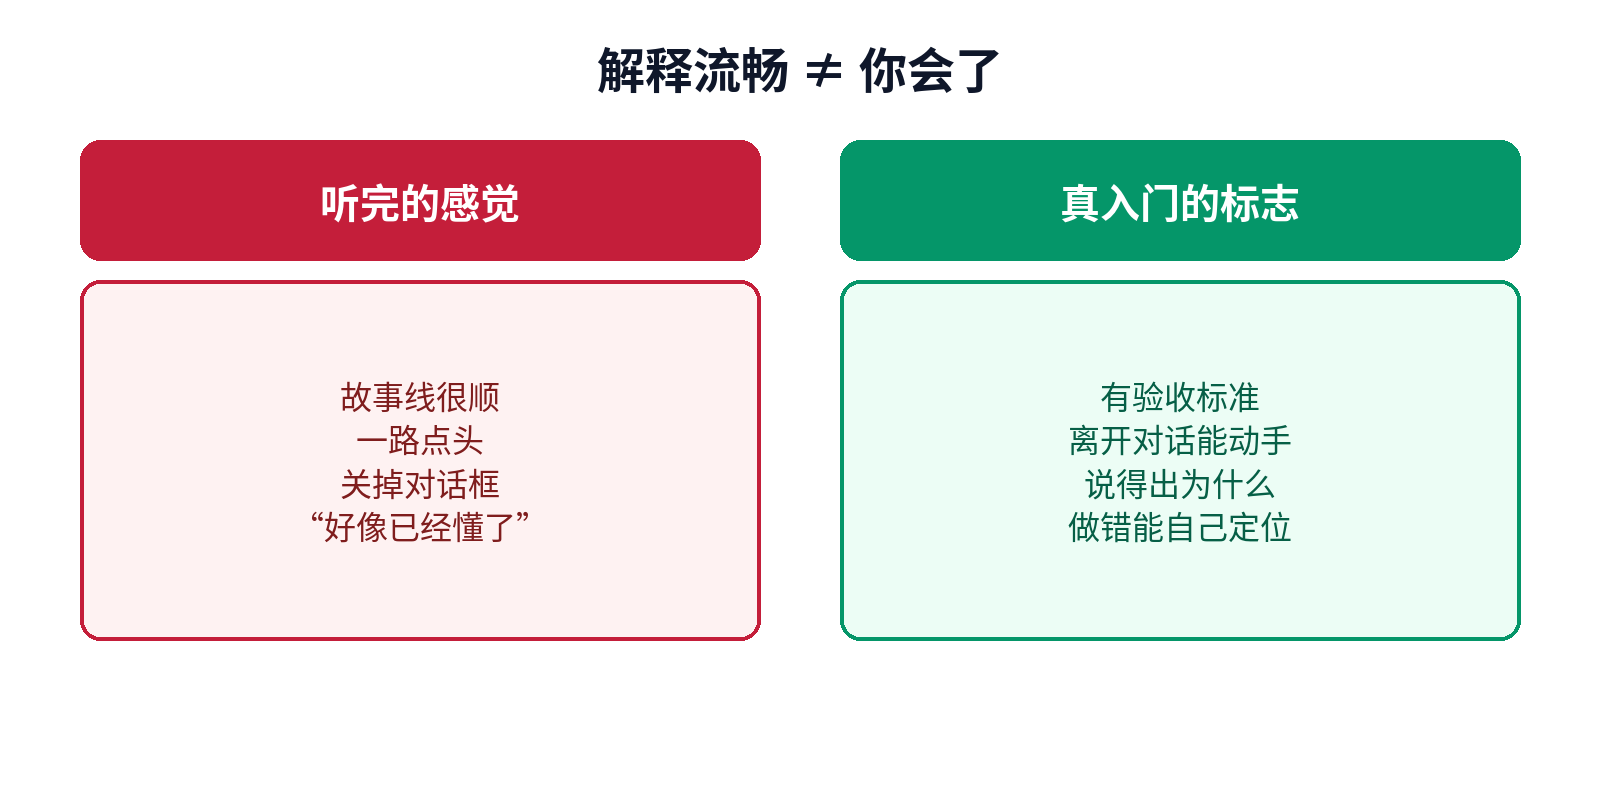
图:解释流畅不等于你会了:听完的感觉 vs 真入门标志(原创示意图)
我现在会在开学之前先写下一句很土的验收标准,比如:“今晚要能在本地起一个最小服务,发一次请求,看懂返回里的三个字段。”有验收,才有地方露馅;没有验收,AI 讲得再好,也只是情绪上的满足。
验收标准还有一个副作用:它会限制我乱问。没有标准时,我容易顺着 AI 的热情一路问到“进阶架构”“生产最佳实践”,看起来收获很多,其实和今晚目标无关。有了标准,我可以礼貌地打断:“先停,我们只解决能跑通这件事。”
三步循环:问 → 做 → 对答案
我把学习拆成一个很短的循环,刻意不让“问”独占整晚。
第一步:只问够动手的那一层。
不要一上来就要“完整体系”。先问:最小依赖是什么、默认端口、第一个 hello 命令怎么敲。体系可以后补;先有一个能跑的点。
第二步:立刻自己动手,不看对话。
把对话框缩到一边,甚至关掉。按记忆敲命令、改配置。卡住了先自己搜报错关键字三分钟,再回来问。这一步很烦,但露馅几乎都发生在这里。
第三步:带着自己的失败再问。
不是“还是不懂,再讲一遍”,而是:“我按你说的做了 X,实际报了 Y,我猜是 Z,对吗?”把猜测写出来,逼自己先形成一个临时模型,再让 AI 校正。
循环跑两到三轮,比连续听一个小时讲解扎实得多。我有过一次反例:让它把某协议“一次讲透”,笔记记了两大页,结果第二天连握手顺序都画不出来。后来改成“先跑通一次,再问为什么”,反而记得住。
还有一个细节:第二步里我会故意换一个小参数,比如改端口、改超时、关掉某个可选功能,看现象是否符合我的预期。若现象对不上,说明我只是复述了默认路径,还没建立因果。
强制露馅的几个小招
光有循环还不够,我会故意给自己挖坑,让幻觉提前破掉。
1. 合上文档默写流程
学完一个流程,合上材料,在纸上或空白文件里按步骤默写。写不出来的格子,就是假懂区。再回去问 AI 时,只问这些格子,不问已经写得出的部分。
2. 让 AI 出题,自己闭卷答
学到一个段落,我会说:“根据刚才内容出三道小题,不要给答案,等我答完再批。”题可以很土:填空、判断、给一个错误配置让我找茬。关键是我先答,它再批。如果反过来让它边出边讲,又变回听故事。
3. 换一个场景迁移
如果教程用的是 HTTP,我会试着问:“如果换成消息队列场景,对应概念怎么映射?”迁移失败说明我只是记住了例子表面,没有抓住结构。
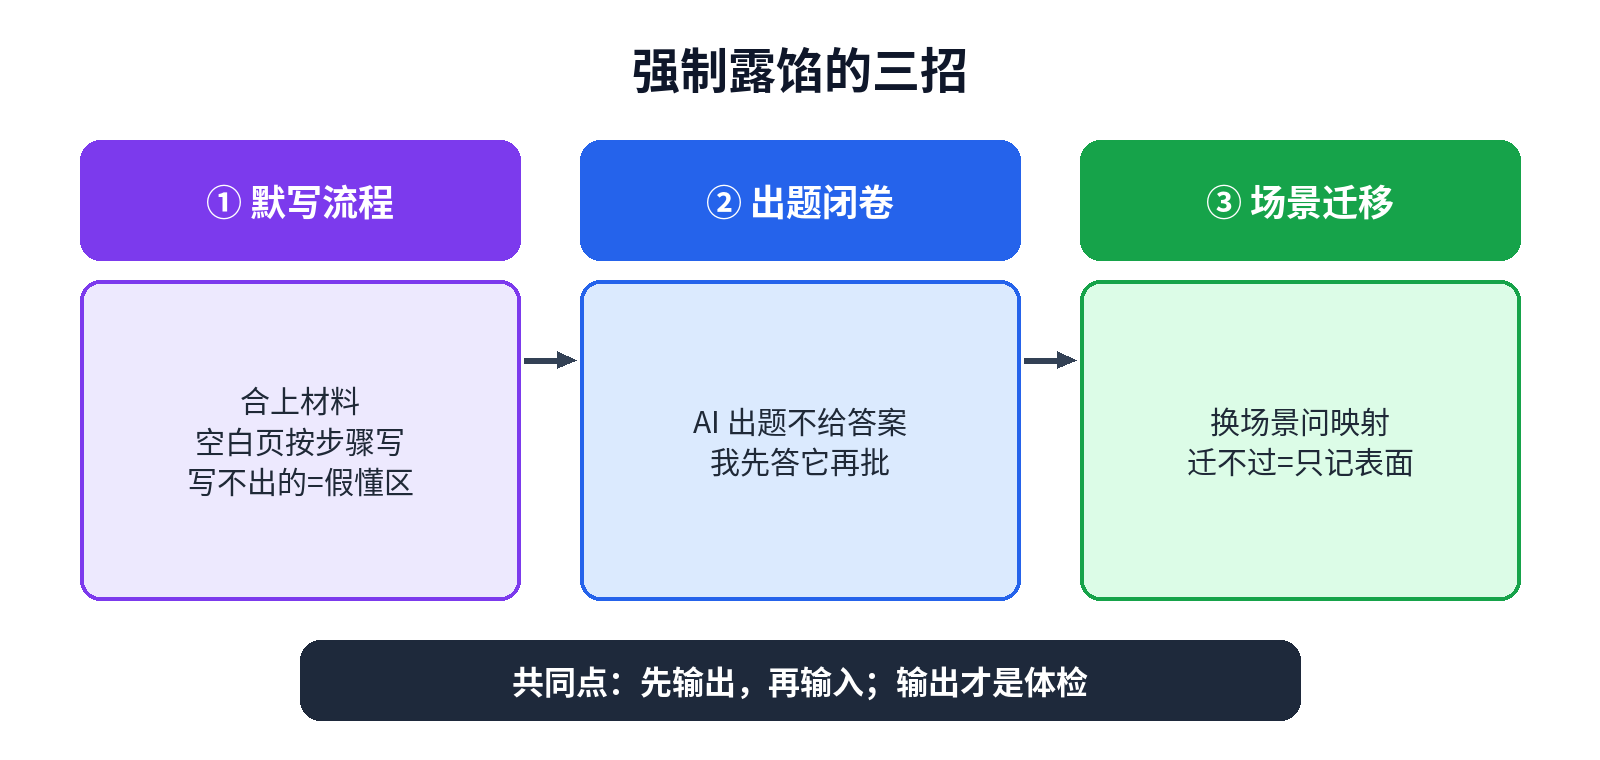
图:强制露馅三招:默写流程、出题闭卷、场景迁移(原创示意图)
这三招有个共同点:都把“输出”放在“输入”前面。学的时候输入太舒服,输出才是体检。我还会加一条更狠的:第二天不看聊天记录,只看自己的笔记复现。很多“昨晚明明会了”的东西,隔夜就露馅;露馅不可怕,可怕的是从来没安排过隔夜检查。
什么内容适合问 AI,什么必须自己啃
我也不是什么都自己默写。大致分工是:
适合问 AI 的: 术语对照、常见报错含义、某配置项大概干什么、帮我列一个最小清单、把一段官方英文摘要成要点
必须自己啃的: 官方 breaking change、安全相关默认值、和你们业务强绑定的约定、生产上翻过的事故记录、许可证与合规要求
AI 对“公开、稳定、文档里写过”的东西通常靠谱;对“你们团队口头传统”和“某个小版本悄悄改了默认行为”就容易编。拿不准时,我默认去对一手文档或源码,而不是再问一轮把幻觉问圆。
还有一点:版本号一定要自己钉死。学新技术时我会先写明“我用的是某某版本”,再问问题。它若开始讲另一个大版本的 API,我会打断纠正。版本漂了,后面全是假懂。我甚至会把版本写进笔记标题,防止一周后回头时对不上号。
一个具体晚上的节奏(可照抄)
假设我想学一个还不熟的客户端库,我会这样排大约 90 分钟:
10 分钟:写验收标准 + 查清版本,问 AI 只要“最小安装与 hello”
25 分钟:自己装、跑、改一个参数看变化(对话框先别开)
15 分钟:把卡住的点和我的猜测发给 AI,只要针对性解释
20 分钟:合上材料默写流程,做错的地方标红
20 分钟:让它出题,我闭卷答,再对官方文档核对可疑点
收工时我只留两样东西:一份能跑的最小示例,一张写着“我以为会但其实不会”的清单。第二天从清单继续,而不是从头再听一遍科普。
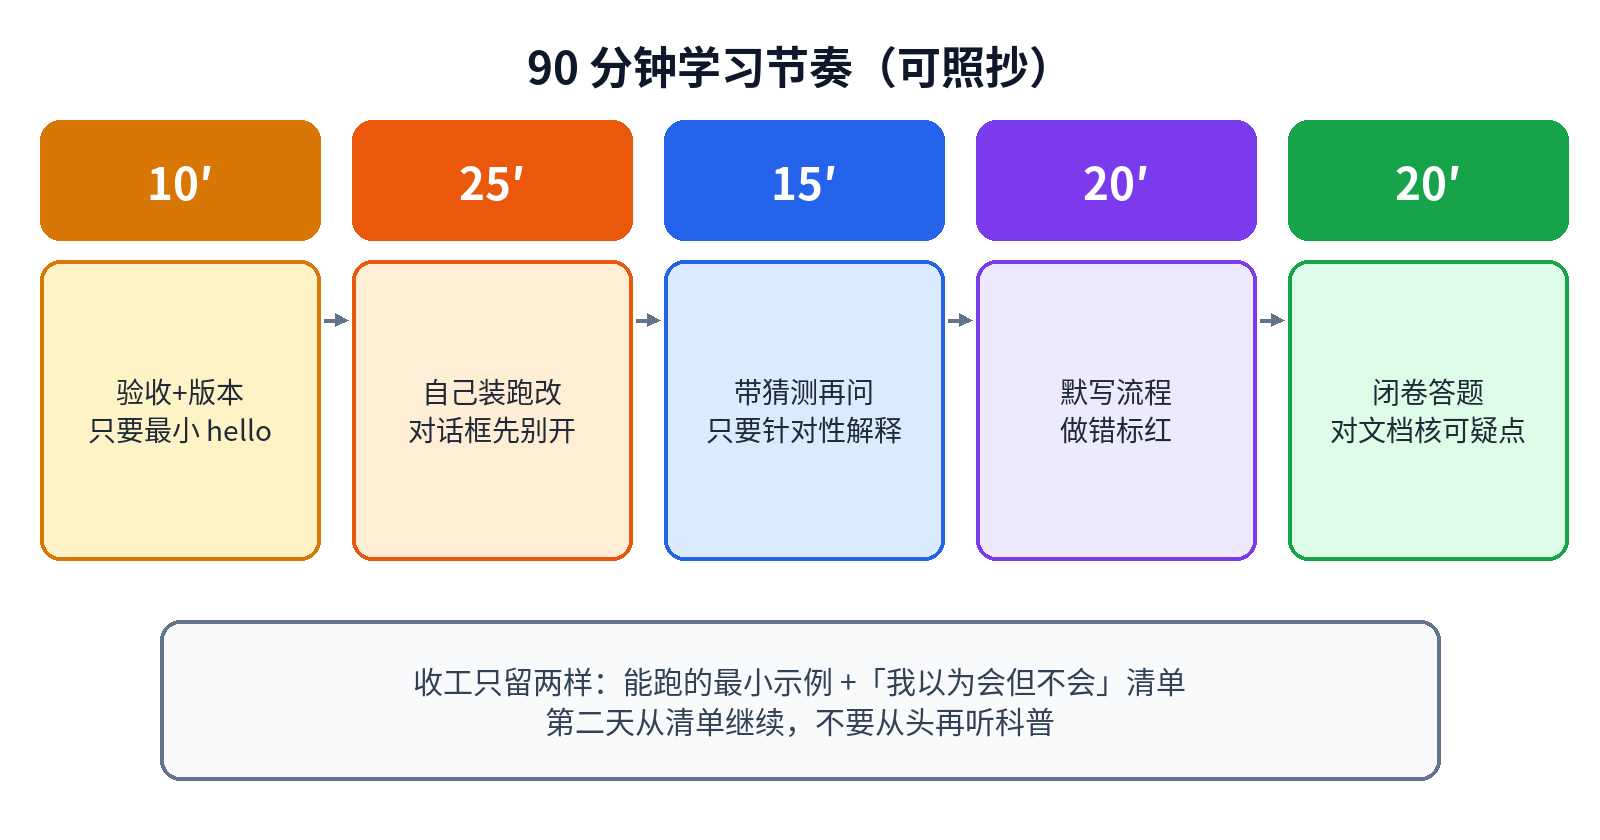
图:90 分钟学习节奏:验收、动手、再问、默写、闭卷(原创示意图)
如果当晚时间不够,我会宁肯砍掉“体系讲解”,也不砍掉“动手 + 默写”。体系可以明天补;假懂一旦形成,后面要花更长时间拆。
怎么判断自己是真懂了一点点
我给自己的标准很朴素,满足两条就算这轮达标:
能独立复现: 换一台干净环境,按自己的笔记(不是按聊天记录)再跑通一次
能讲清取舍: 别人问“为什么用 A 不用 B”,我能说出至少一个真实代价,而不是复述 AI 的优缺点列表
如果只能复述“它有高可用、易扩展”,大概率还是在背广告词。真懂一点点时,话会变短,也会更具体,比如“我们这个流量下 B 的冷启动太慢,所以先用 A”。
第三条可选标准是:能教别人最容易踩的两个坑。教不出来,通常说明自己还没踩过,或踩过但没沉淀。AI 可以帮你列坑,但“哪个坑在我们环境里真的会炸”,还是要靠自己的实验和团队经验。
和“用 AI 写代码”的一点区别
写代码时,我可以接受 AI 先给草稿,我再改。学习时如果也全程“先看草稿再改”,很容易变成只改表面。学习更需要空白页上的第一笔是自己写的——哪怕写错。错才是记忆的钉子。
所以我现在有个简单分界:任务目标是交付代码,可以多让 AI 起草;目标是自己会,就多让自己先输出。两者都用 AI,但主次不同。
最后留一句给自己的提醒
AI 是很好的讲解员和陪练,但不是替你完成“从不会到会”的那个人。流畅的讲解最容易制造学会的错觉;动手和默写才会把错觉拆掉。
下次再学新技术,我会继续用它,但会更狠一点:先定验收,少听长篇,多露馅,再带着自己的错误回去问。看起来慢半拍,实际上少反复“重新入门”好几次。若你也有“看完超有收获、一写就空”的体验,不妨先试一晚这个节奏,看看假懂会不会少一点。
 2026-10-14鱼鱼