

先放链接:jev.fishmaple.cn。这是我前两天搭的一个小调试台,叫 Jev Lab。打开就能用,填一个 OpenRouter 的 Key,就可以直接在浏览器里调 JEV。这篇想聊聊 JEV 到底是个什么东西,它跟传统分类器、重排序差在哪,以及九月它出来之后,OpenAI、微软、Cloudflare、阿里、Perplexity 这些大厂怎么对标的。
第一次看到 JEV,我以为又是个聊天模型
九月中旬刷 OpenRouter 的模型列表,看到一个叫 typesafe/jev-1.13 的东西,上线日期是 2026 年 9 月 18 日。价格那栏把我看愣了:输入每百万 token 0.042 美元,输出是 0。
输出免费?我第一反应是标错了。点进去才发现,它压根不输出文字。官方的说法是 TypeSafe 家的第一个“System One”模型。你给它一份上下文,再问它几个有固定格式的问题,它回你的是一个选项、一个档位或者一个概率,没有一句废话,也没有推理过程。文档里有个 FAQ 问得很直接:JEV 是 LLM 吗?答案是“不是”。
说实话,“System One”这个名字我一开始觉得有点玄,大概是借了“系统 1 / 系统 2”那套快思考、慢思考的说法。但用了几次之后,我觉得这个名字还挺贴切:它就是干那种不用想太久、但得快和准的判断。
它能干什么:三种问题,叫 Choice、Score、Noul
JEV 只认三种问题,文档里管它们叫 primitive:
Choice 是“从这几个里选一个”。你给出候选项和每个候选项的描述,它返回选中的那个,外加每个选项的概率和一个 confidence。我在调试台里看 app.js 的校验,候选项最少 1 个,最多 255 个。
Score 是“落在哪一档”。你按从低到高写 2 到 10 个档位描述,它返回一个按概率加权的位置,还有每一档的概率。比如愤怒程度分“平静、克制的不满、强烈愤怒”三档,它可能回你 2,也可能回 1.4 这种中间值。
Noul 是“是不是”。名字很怪,我猜是 null 和 bool 的某种谐音梗,官方没解释,这只是我瞎猜。你写清楚 true 和 false 各自的标准,它只回一个数:条件成立的概率。
最让我觉得顺手的一点是,这三种问题可以塞进同一个请求里,共享一份上下文(文档里叫 state)。文档特意强调,同一请求里的问题是并行回答的,互相看不到对方的答案。所以一条客服工单进来,“这是什么诉求”“用户有多生气”“是不是在说重复扣款”可以一次问完,各问各的,不会互相带偏。
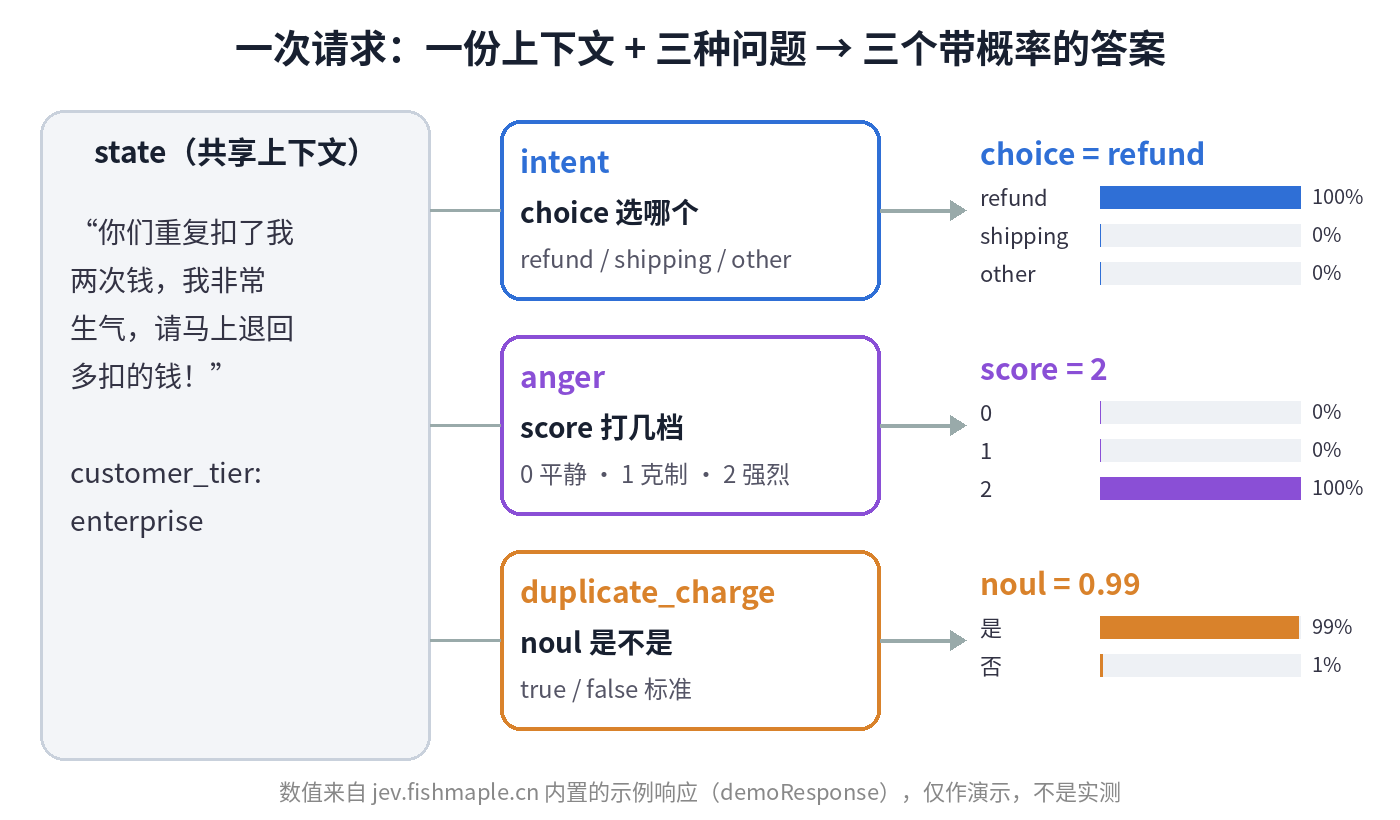
一份 state,三个问题,三个各自带概率分布的答案。图里的数值是调试台内置示例响应,不是实测。
为什么我要做 jev.fishmaple.cn
原因挺朴素:JEV 不走 OpenAI 那套 chat completions 接口,走的是 OpenRouter 单独开的 Decisions API,地址是 POST https://openrouter.ai/api/alpha/decisions,路径里还带着 alpha。平时顺手用的那些聊天客户端全都接不上。想试一个问题,我得开终端拼 JSON。criteria 里少个引号,就要回头改半天。
拼了几次之后我烦了,干脆写了个页面。现在 jev.fishmaple.cn 上大概是这样:
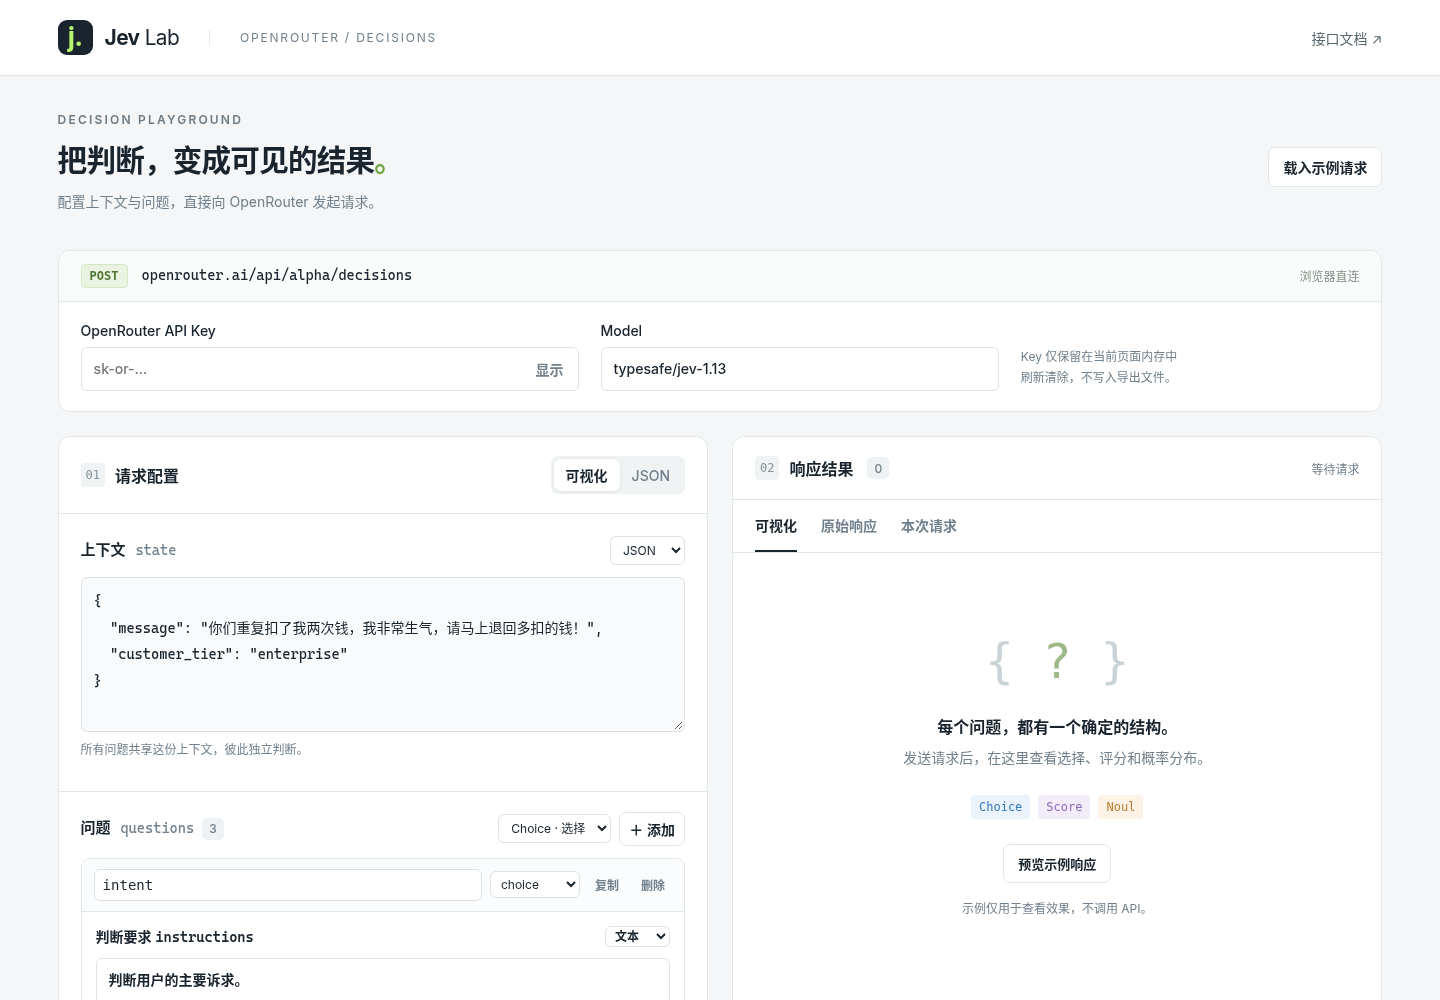
Jev Lab 首屏:左边配请求,右边看结果。图里已经点了“载入示例请求”。
我自己一般这么用。先点右上角“载入示例请求”,它会塞进来一条客服消息:“你们重复扣了我两次钱,我非常生气,请马上退回多扣的钱!”,还有 intent、anger、duplicate_charge 三个问题,正好 Choice、Score、Noul 各一个。然后我就开始改:把 state 换成自己手上的真实数据,把选项改成自己业务里的分类。
问题区域有“可视化”和“JSON”两种编辑方式。可视化模式下,Choice 一行一个候选项,Score 一行一档,还能上下挪顺序。Noul 的 true/false 两行是锁死的,删不掉,因为 API 本来就要求两个都有。要是改着改着想看原始请求,切到 JSON 就行,两边会同步。
发请求之前不用填 Key 也能玩:点右侧的“预览示例响应”,能看到结果长什么样。Choice 显示选中项和一排概率条,Score 显示加权分数和每一档的概率,Noul 显示“是”的百分比。真发请求的话,下面还会列出这次的耗时、输入输出 token 和费用。费用是从响应里的 usage.cost 读出来的,精确到小数点后八位,因为真的太便宜了。
还有几个是我自己用着用着加上的:
Key 只放在页面内存里,刷新就没了,导出 JSON 的时候也不会带上,请求是浏览器直连 OpenRouter 的。我不想做一个替别人保管 Key 的东西,这点我比较在意。
“复制 c$OPENROUTER_API_KEY 这个环境变量。调好了直接贴进脚本,不用再手拼。
“高级参数”里能填 provider、session_id、user、trace 这些 OpenRouter 的通用字段。超时可以设 1 到 600 秒,请求发出去之后也能取消。
贴一个调试台导出的最小请求,跟页面里的示例是一致的:
curl --request POST 'https://openrouter.ai/api/alpha/decisions' \
  --header "Authorization: Bearer $OPENROUTER_API_KEY" \
  --header 'Content-Type: application/json' \
  --data-raw '{
  "model": "typesafe/jev-1.13",
  "state": {
    "message": "你们重复扣了我两次钱,我非常生气,请马上退回多扣的钱!",
    "customer_tier": "enterprise"
  },
  "questions": {
    "intent": {
      "type": "choice",
      "instructions": "判断用户的主要诉求。",
      "criteria": {"refund": "要求退回款项。", "shipping": "查询物流或配送。", "other": "其他诉求。"}
    },
    "anger": {
      "type": "score",
      "instructions": "判断用户表达出的愤怒程度。",
      "criteria": ["语气平静,没有表达不满。", "表达不满,但语气克制。", "明确表达强烈愤怒。"]
    },
    "duplicate_charge": {
      "type": "noul",
      "instructions": "用户是否在报告重复扣款?",
      "criteria": {"true": "用户表示同一笔消费被扣款多次。", "false": "用户没有报告重复扣款。"}
    }
  }
}'
返回大概长这样(结构以官方文档为准):answers.intent 里有 choice、confidence、probabilities;answers.anger 里有 score 和每档的 probabilities;answers.duplicate_charge 只有一个 noul 数值。外面再包一层 model、provider、usage。
它和传统分类器、重排序模型到底差在哪
这个问题我被朋友问过好几次。乍一看都是“给文本打标签、打分”,好像差不多,真用起来差别挺大。
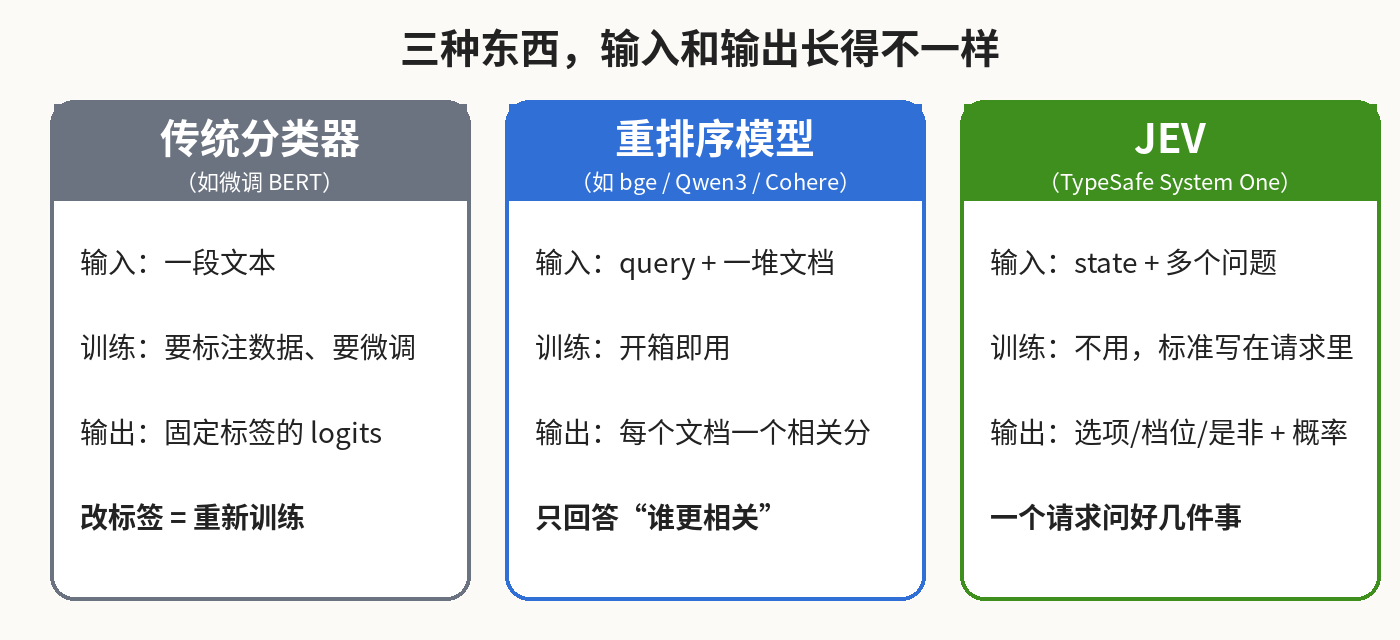
这张图还是原先那套:传统分类器、重排序、JEV 三者的输入输出差在哪。后面大厂对标那一节另有一张表,别混在一起看。
先说传统分类器,就是拿 BERT 一类的模型、用自己的标注数据微调出来的那种。它的优点我很认,一旦训好,又快又便宜,还能私有化部署。OpenRouter 自己做的那份评测里也承认,在 Banking77 这个数据集上,JEV 和 Claude Opus 5 都没跑过专门微调的编码器模型。但它的麻烦也很明显:标签是训练时就定死的。产品经理哪天说“加一个‘催发票’分类”,你就得重新标数据、重新训一遍。
重排序模型(reranker)是另一回事。bge-reranker、Qwen3-Reranker、Cohere Rerank、Jina Reranker 这些,干的活是“给一个 query 和一堆候选文档,按相关性重新排一遍”。它输出的是每个文档一个相关分,回答的只有一个问题:谁更相关。在 RAG 里它非常好用,可你要问它“这条消息是不是在投诉重复扣款”,就不太对路了。硬拿来用当然也行,把每个标签描述当成“文档”去排,不过那是在拧螺丝刀当锤子用。
JEV 的位置,我的理解是夹在中间偏另一侧:标签和标准不在训练里,而是每次写在请求里。今天三个选项,明天五个,改的只是 JSON。而且它一次能问好几个不同类型的问题。官方文档有句话我觉得说得很准:它替代的是“问 LLM 一个窄问题、再从它的回答里抠出标签”这一步。
| 传统分类器 | 重排序模型 | JEV | |
|---|---|---|---|
| 输入 | 一段文本 | query + 候选文档列表 | state(文本/对象/数组)+ 多个带类型的问题 |
| 要不要训练 | 要,得有标注数据 | 一般开箱即用,也能微调 | 不用,标准写在请求里 |
| 输出 | 固定标签的 logits / 概率 | 每个文档一个相关分 | 选项、档位或是非概率,带分布 |
| 改需求 | 重新标数据、重训 | 换 query 即可,但只能排序 | 改 criteria 即可 |
| 一次问多件事 | 通常要多个头或多个模型 | 不支持 | 支持,问题之间互不可见 |
| 部署 | 可本地私有化 | 开源的可本地,Cohere 是 API | 目前经 OpenRouter 调用;对标里已有开源可自建的 |
| 适合 | 标签稳定、量极大、要求离线 | 检索结果重排 | 路由、审核、校验、Agent 守门这类会变的判断 |
我自己的归纳,部署和适用场景这两行带主观判断。
说到“准不准”,OpenRouter 九月下旬发过一篇对比文章,数据我觉得挺实在。在 Banking77(77 个意图、3080 条测试)上,JEV 1.13 准确率 81.0%,Claude Opus 5 是 84.4%,JEV 低了 3.3 个点。但 JEV 的中位延迟是 175 毫秒,Opus 是 2266 毫秒,每千次请求的成本分别是 0.11 和 2.42 美元。他们还试了个级联:JEV 的 confidence 低于 0.90 的才交给 Opus,准确率能到 84.0%,成本降到每千次 0.69 美元。文章自己也说了,这个级联结果是在同一个测试集上调出来的,算偏乐观的上限。
还有一个细节我觉得必须说:模型页写的是“calibrated probabilities”(校准过的概率),但那篇评测说它的 confidence 并不是严格校准的概率,在中间区间会高估自己。好在排序能力不错:confidence ≥ 0.99 的那 58% 样本,准确率有 96.3%。所以我的用法是,阈值别拍脑袋,拿自己的一小批标注数据去试出来。
另外有个数字对不上:OpenRouter 的模型页写的上下文是 64K,Jev 的文档页写的是 32,000 token。我不确定哪个是最新的,用之前最好自己确认一下。
JEV 出来之后,大厂怎么对标
九月中旬的时候,OpenRouter 的 Decisions 这条线上几乎就只有 JEV 一家。到十月初,事情一下子热闹起来:OpenAI、Cloudflare、微软、阿里百炼、Perplexity,再加上 Upstage,陆续都扔出了同一类东西——不写字、只出带类型判断的 decision model。OpenRouter 现在专门有个 Decisions 排行榜,JEV 请求量还是第一,但后面一串新名字都已经挤进来了。
先用一张表把几家摆在一起(价格都是每百万输入 token;输出基本都是免费,因为它们根本不吐文字)。数字以公开页为准,我没做跨厂商实测:
| 模型 | 厂商 | 上线 | 价格($/M in) | 上下文 | 输入形态 | 一句话 |
|---|---|---|---|---|---|---|
| typesafe/jev-1.13 | TypeSafe | 2026-09-18 | 0.042(输出免费) | 32K / 64K 说法不一 | 文本 | 先发、最便宜档之一,P50 约 0.15s |
| GPT-6 Luna Decisions | OpenAI | 2026-10-06 | 0.10 | ~1.05M | 多模态 | 自家 /v1/decisions beta;OR 上映射成 noul/choice/score |
| Microsoft-Decision-1 | Microsoft | 2026-10-09 | 0.042 | 32K | 文本 | Foundry + OpenRouter;声称在 36 项盲测里领先 |
| Clef | Cloudflare | 2026-10-01 | 0.24 | ~64–66K | 多模态 | Apache 2.0,Jev-API 兼容,可自建 |
| decision-model-preview | 阿里百炼 | ~2026-10-11 | 限时免费 | 65536 | 文本(System One) | compatible-mode/v1/systemone;建议 ≤16 问/请求 |
| Decider V1.1 27B | Perplexity | 2026-10-07 | 0.02 | 262K | 多模态 | 目前看到的最便宜档之一;≤128 问/请求 |
| Solar Decide | Upstage | 2026-09-28 | ~0.05–0.10 | 512K | System One | 韩文场景强;可选看 |
价格和上下文会变,阿里那行“限时免费”尤其可能随时改。我没有自己跑过跨厂商对照评测,上面只是公开资料的对照。
OpenAI · GPT-6 Luna Decisions。 十月六号上的。它走的是 OpenAI 自己的 Decisions API(/v1/decisions,目前还是 beta),在 OpenRouter 上也能调,模型名 openai/gpt-6-luna-decisions。和 JEV 一样给 choice / score,是非题在 OpenAI 那边叫 predicate,到 OpenRouter 就映射成 noul——名字不一样,意思差不多。贵一点,大概 0.10 美元每百万输入;但上下文一下子拉到大约 105 万,而且能吃图。适合已经在 OpenAI 体系里、上下文又特别长的场景。我没专门拿它和 JEV 对打过准确率。
Microsoft · Microsoft-Decision-1。 十月九号,Azure AI Foundry 和 OpenRouter 两边都能看到。价格跟 JEV 一样是 0.042,上下文 32K,纯文本。公开材料里说它是从 Qwen3.5-9B 后训练出来的,还声称在一组 36 项盲测里排第一。具体盲测清单和对照对象我没逐条核对,先当厂商说法听着。想找“跟 JEV 同价、微软生态里能用”的选项,可以盯一下这个。
Cloudflare · Clef(还有个 Clef-flash)。 十月一号的博客里直接点名 Typesafe Jev,说自己是同一类。最大的差别是 Apache 2.0 开源,权重在 Hugging Face 上,Workers AI 也能托管,而且号称 Jev-API 兼容——接口形状差不多,换 endpoint 和 model 就能试。支持多模态,上下文大概 64K 到 66K。托管价大约 0.24 美元每百万输入,比 JEV 贵一截。社区有人提到长文本时 Workers AI 侧可能截断,自己用的时候最好压一下输入长度。想自建、或者数据不能出内网的,Clef 这点挺有吸引力。
阿里百炼 · decision-model-preview。 文档大概十月十一号前后能看到,走的是 System One 那套路,接口在 compatible-mode/v1/systemone。上下文 65536,推荐单次请求问题数别超过 16。现在标的是限时免费——这个词我特意写出来,过两天可能就变了。中文业务、已经在百炼上的团队,这条路径最省事。
Perplexity · Decider V1.1 27B。 十月七号,27B,价格看到的是 0.02 美元每百万输入,比 JEV 还低一截;上下文 262K,多模态,单次最多大概 128 个问题。OpenRouter 的 Decisions 排行里请求量已经能排到前面。便宜、上下文也够用,值得拿自己的数据摸一下。
Upstage · Solar Decide(可选)。 九月二十八号,也是 System One 这一路,上下文 512K,韩文场景口碑不错,价格大概在 0.05 到 0.10 之间。中文主力场景我未必会优先选它,但如果你业务里韩文占比高,可以放进候选。
几个公开数字我得老实交代一下:JEV 的 64K 和 32K 对不上;“校准概率”是模型页说法,OpenRouter 那篇 Banking77 评测并不完全认;OpenAI 的 predicate 和 OpenRouter 的 noul 是同一类是非题的不同叫法;阿里的限时免费随时可能改;Cloudflare Workers AI 长文本有截断的反馈。另外,我没有自己做跨厂商基准测试,上面的准确率、速度对比都是各家自己的材料或第三方文章,别当成我的实测。
不是对标、别混
还有几样东西经常被跟人一起提,但我觉得不该塞进上面那张表:
重排序模型——Jina Reranker、Cohere Rerank、Qwen3-Reranker——干的是“query 对文档谁更相关”,不是“按你写的标准做判断”。跟 JEV 是互补,不是替代。
安全护栏——gpt-oss-safeguard、Qwen3Guard、Llama Guard——只管安全策略这一维,会生成文字或标签,不是通用的 Choice/Score/Noul 决策模型。
typesafe/jev-router 是基于 JEV 做的路由应用,按质量、速度、成本帮你挑模型和推理强度。它是应用,不是另一个决策模型。
再往外说,Gemini 的 structured output、Anthropic 那套分类器接口,本质还是让聊天模型按 schema 吐结果,跟“非生成、只出带概率的判断”不是一类东西。别因为都能“出结构化结果”就混着比。
我会在哪用它,哪里不会
我会用它的地方:工单分流,Agent 调工具前先问一句“这个操作和用户原始请求对得上吗”,批量给评论打标签,还有“便宜模型先答、JEV 校验、不过关再升级大模型”这种级联。OpenRouter 的 cookbook 里正好有这几个例子,连给 Claude Code、Cursor 这类工具自动批准权限弹窗都有一篇。大厂对标出来之后,入口多了,但我自己调试台目前还是围着 JEV 转——先把请求形状摸熟,再换模型名去试别家,成本最低。
不会用它的地方:需要解释“为什么”的场景,它就给不出来。文档建议的做法是让 JEV 做决定,再让聊天模型去写解释;或者 confidence 低就转人工。还有标签几年不变、一天几千万条、必须离线的场景,我还是老老实实训个小分类器;真要离线决策模型,Clef 那种开源权重倒是新选项。
以上大部分是看文档和公开评测得出的。我自己在调试台里试的量还不大,不敢说替你验证过准确率,更没做过跨厂商对照。最靠谱的办法还是拿你手上的真实数据去试一试。
所以,最后再放一次链接:jev.fishmaple.cn。不填 Key 也能先点“载入示例请求”和“预览示例响应”看看效果。有 OpenRouter Key 的话,把你手上一条真实消息贴进 state,写三个问题发出去,一次请求花不了几分钱的零头。玩出什么有意思的用法,欢迎来评论区告诉我。
 2026-10-14鱼鱼