

做长任务 Agent 时,我最早的做法特别朴素:把所有中间结果、计划、反思,一股脑追加进对话上下文。反正模型“看得见”,多写点总没错。
错就错在“多写点”。上下文很快又脏又长:旧计划和新计划并存,失败的工具输出还在,模型开始引用过期结论,或者在同一段推理上打转。更麻烦的是,你很难回答一个基本问题——此刻 Agent 到底相信什么?
后来我给 Agent 加了一个显式的“草稿本”(scratchpad):工作记忆外置到一块可读写的状态里,prompt 里只放当前需要的摘要和指针。稳定性和可调试性都好了不少。这篇讲讲为什么,以及我怎么划分什么该进草稿本。
全塞进 prompt 的三种难受
1. 噪声淹没信号。
工具返回动辄几千字,失败堆栈、HTML 片段、长 JSON,全进上下文。下一轮真正关键的约束(用户目标、权限边界、已确认的事实)反而变矮了。
2. 版本纠缠。
计划 v1、v2、v3 都在历史里。模型有时会突然执行 v1 的某一步,因为它“又看见了”。人靠滚动条都能晕,何况它。
3. 不可检查。
对话日志很长,不等于状态清晰。你想知道“当前已验证的事实有哪些”,得靠翻聊天记录考古。工程上这不可接受。
草稿本要解决的,就是把“此刻有效的工作记忆”从聊天历史里抽出来,变成一份可更新、可覆盖、可审查的对象。
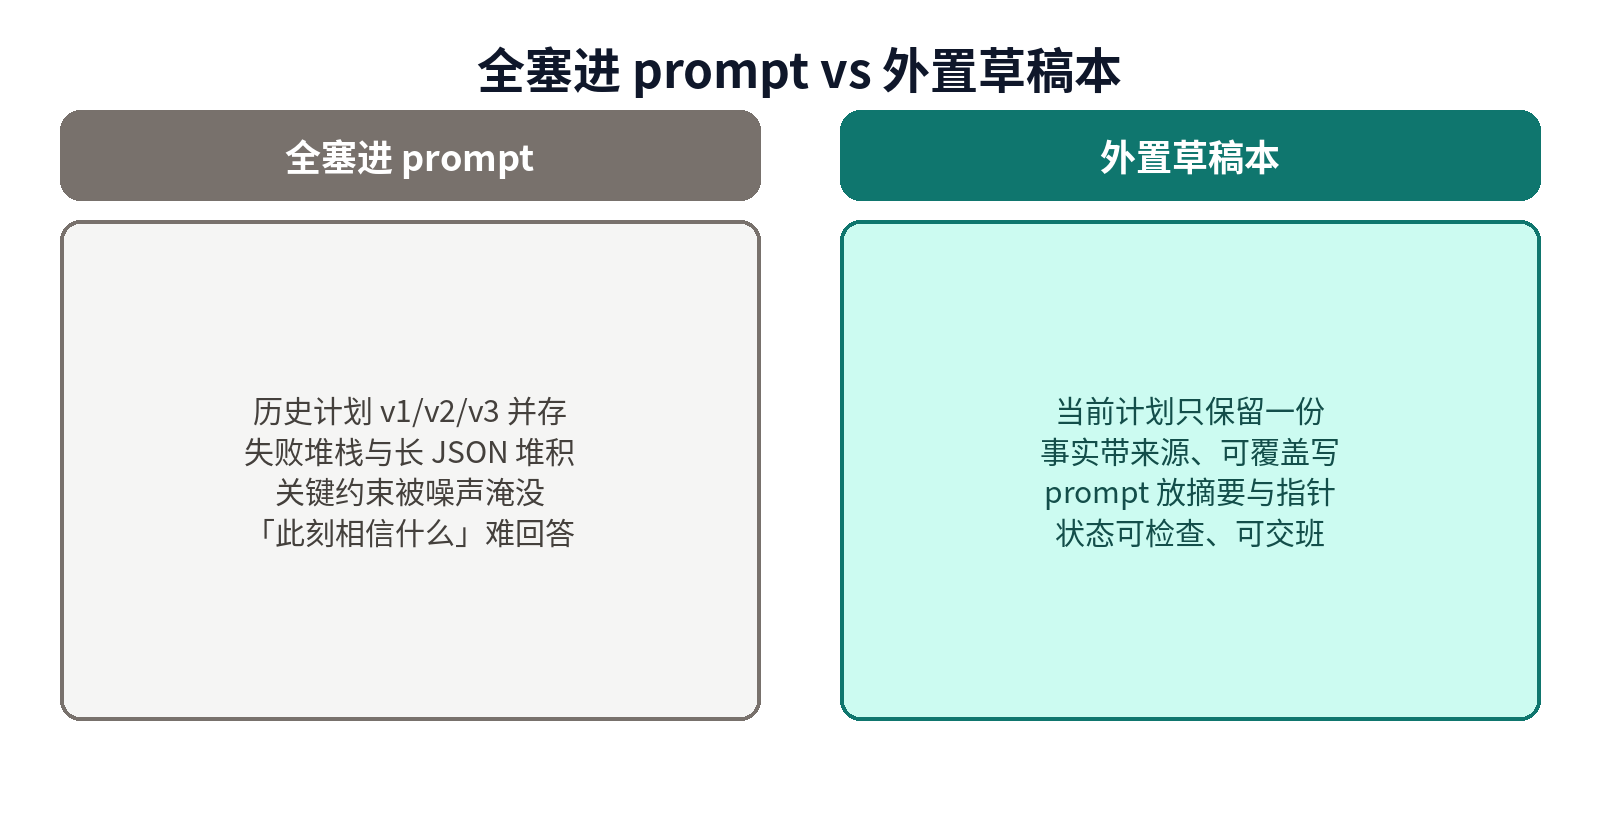
图:全塞进 prompt vs 外置草稿本(原创示意图)
草稿本里放什么
我习惯把草稿本分成几格(名字随意,结构重要):
目标与约束:用户要什么、不能做什么、成功标准
当前计划:最多一份,覆盖写,不追加历史计划
已确认事实:带来源(哪个工具、哪次观察),尽量短
未决问题 / 假设:明确标成假设,防止当成事实
进度与下一步:现在走到哪、下一步打算做什么
失败与禁区:此路不通的记录,避免重复踩坑
注意:草稿本不是第二份完整日志。日志仍要另存。草稿本是“给当下决策用的浓缩状态”。
有人会问:这不就是记忆系统吗?可以说是工作记忆的一种。它不必上向量库,先做成结构化文档或 JSON 就很好:能读、能写、能 diff。
为什么比“靠模型自己总结”更稳
也可以让模型每轮自我总结,把总结塞回 prompt。我试过,有用,但不稳。
原因大致是:
自由总结爱丢约束,也爱把猜测写成事实
没有固定字段时,每轮摘要结构漂移,后面的提示词不好依赖
出了问题,你不知道是总结错了,还是推理错了
草稿本强迫你(和模型)往固定格子里写。更新是显式动作:“修订计划”“追加事实”“标记失败”。显式更新可以被规则检查,比如:计划字段只能有一份;事实必须带来源;假设不能自动升格为事实。
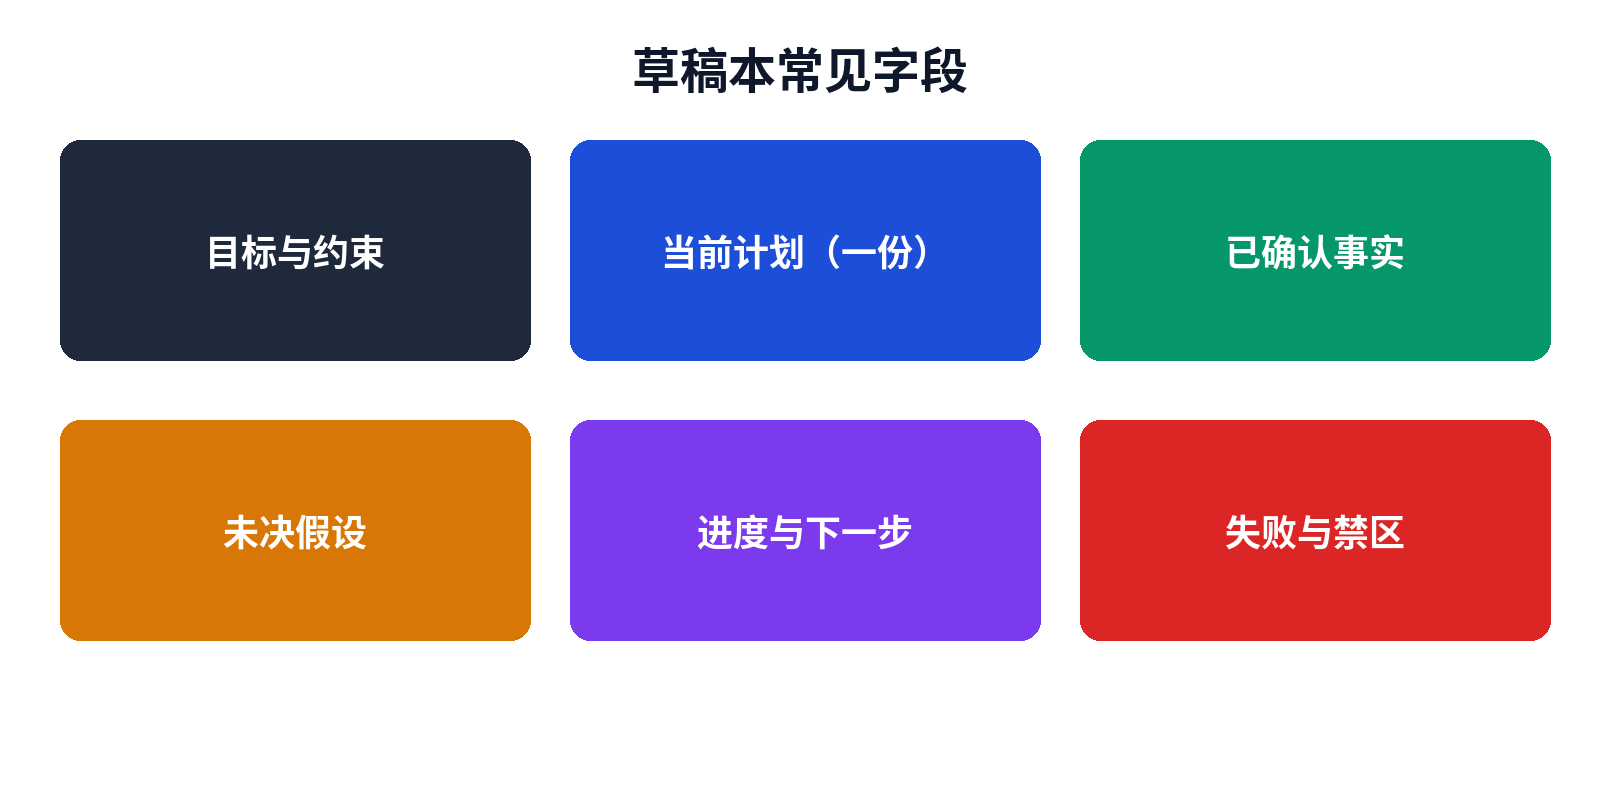
图:草稿本常见字段:目标、计划、事实、假设、进度、禁区(原创示意图)
和上下文压缩怎么配合
长任务难免还要压缩历史。有了草稿本,压缩策略会清晰很多:
历史对话可以大胆删、大胆摘要
但草稿本里的约束、已确认事实、禁区,默认保留
压缩后做一次“探针”:问模型当前目标/关键约束是什么,对不上就回滚压缩或重写摘要
我把草稿本当作压缩时的“保底清单”。没有保底清单的压缩,像搬家时随机扔纸箱——东西是少了,但钥匙也可能没了。
实现上不必很重
最小可行可以是:
一个
scratchpad.md或state.json工具:
read_scratchpad/update_scratchpad(按字段更新)系统提示规定:每轮开始先读草稿本;重要结论写回;不要把大段工具原文写进事实栏
进阶一点再加:字段校验、大小上限、自动把超长工具输出存到外部并在事实栏留指针。
指针这个想法特别值钱。很多时候你不需要模型记住整页 HTML,只需要记住“标题在第 2 个 h1,内容已存 uploads/a.html”。要用再读。这比把整页塞进上下文干净一个数量级。
一个对比场景:多步调研
假设任务是“对比三个方案并给出建议”。
全塞进 prompt 的版本:三次搜索、三次打开页面、大段摘录全留在对话里,最后让模型“综合一下”。常见结局是:综合时引用了第一次搜索里已经被后来证伪的句子,或者漏掉第三次打开的关键段落。
草稿本版本:每次搜索后,只把“与决策相关的三条事实”写入已确认事实(带来源链接);计划字段更新为“下一步验证 X”;矛盾出现时,把旧事实标记为撤销并写明原因。最后综合时,模型主要面对的是事实栏,而不是三小时的聊天考古。
我不是说后者永远正确,而是:出错时你能看见状态,也知道该修哪一格。 这在工程上比“再碰运气跑一遍”珍贵得多。
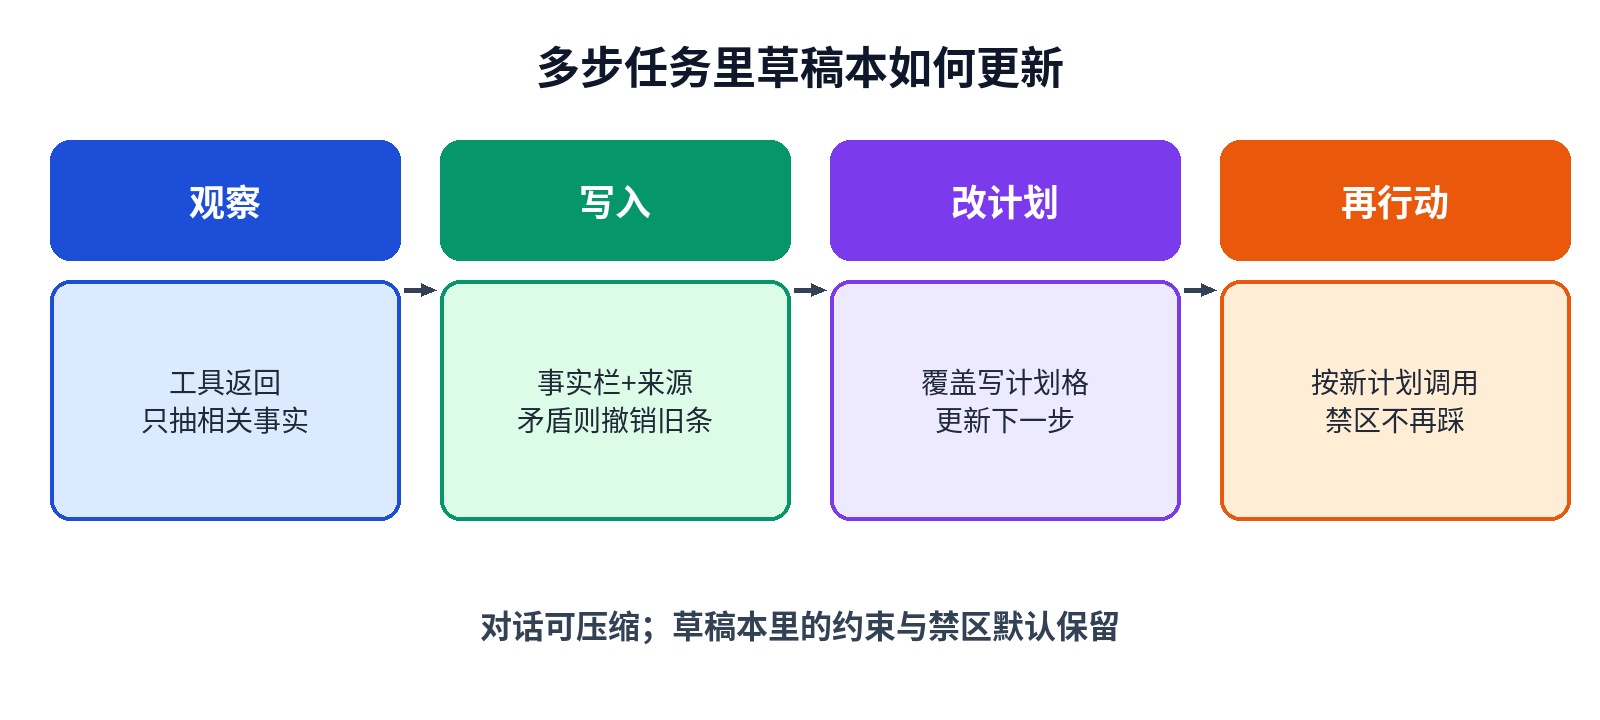
图:多步任务中草稿本如何被更新(原创示意图)
风险和边界
草稿本也会引入新问题:
写错格子比写错一句聊天更危险,因为会被反复当作真相
更新过于频繁,模型会把时间花在“记账”而不是做事
如果工具不强制,模型可能偷懒不更新,草稿本变假
所以要有轻量护栏:关键步骤后检查必填字段;限制每轮更新篇幅;定期(或由规则)核对手稿本与最近工具结果是否一致。
另外,敏感信息进草稿本要当心。它往往比聊天记录更集中、更持久。权限、脱敏、过期策略,都要当成一等公民。
和“笔记给人类看”的差别
有的产品会把 Agent 的思考过程展示给用户。那是 UX。草稿本首先是给系统自己用的工作记忆;能不能展示,是第二件事。我建议默认按内部状态设计,再决定哪些字段可对用户可见。别为了好看把内部状态做成散文,否则又回到难检查的老路。
团队协作时草稿本更好交班
长任务经常跨会话、跨同事。对话记录很难交接:“你接着跑”意味着下一个人要读两千行聊天。草稿本不一样:打开 state,看目标、计划、事实、禁区,五分钟内能接着干。
我甚至觉得,草稿本质量是 Agent 产品是否“可运维”的试金石。如果只有对话流,出了事故你只能回放;如果有结构化状态,你还能热修一格事实、改一步计划,再让它继续——前提是你的编排支持从状态恢复。
这也反过来约束设计:不要让关键决策只存在于模型隐式激活里。能写进草稿本的,就写进去。
什么时候不必上草稿本
不是所有 Agent 都需要。短问答、单次工具调用、强流程编排且状态已在业务 DB 里的系统,再造一份 scratchpad 可能重复。
更适合上的信号是:
任务跨很多步,中间会分叉
需要根据观察不断改计划
失败后要避免重复路径
你经常问“它现在到底认为什么”
有这些痛点,再上。为了架构图好看而加一层,没必要。
最后
Agent 变强之后,最容易膨胀的不是工具数量,而是上下文里堆积的“好像有用”的文字。全塞进 prompt,短期省事,长期像一间从不扔东西的房间。
给它一个草稿本,本质是承认:工作记忆需要结构,需要覆盖写,需要可检查。 上下文负责交谈与证据的流动;草稿本负责当下相信什么。两者分工清楚了,长任务才不像一场越聊越糊的马拉松。
如果你的 Agent 已经开始“忘记约束”或“重复已失败路径”,先别急着上更复杂的记忆网络。试着加一个很小的、字段固定的 scratchpad。很多时候,稳,是从少而清楚开始的。
 2026-10-14鱼鱼