

做 Agent 的人,迟早会碰到同一个设计题:工具调用失败了,下一步是原地再试,还是换个策略?
听起来像工程里的重试策略老话题,放到 Agent 里却更别扭——因为失败的原因经常不是“网络抖了一下”,而是“这条路根本走不通”,或者“模型把错误理解歪了,越重试越执着”。
我踩过两边的坑:该重试时太早放弃,任务脆;该换路时死磕重试,账单和日志一起爆炸,最后还是失败。这篇整理一下我现在怎么做判断。
先把失败分个类
不是所有失败都该一视同仁。我大致分成四类:
瞬时故障:超时、限流、连接重置。特征是:同一请求,过一会儿可能就好。
输入问题:参数缺了、格式不对、路径不存在。特征是:原样再发,几乎必败。
权限/策略拒绝:没权限、被安全策略拦住。特征是:换参数也不行,除非换身份或换工具。
逻辑走不通:工具成功返回了,但结果显示前提错了(比如搜不到、页面没有该字段)。特征是:技术上“成功”,任务上“没用”。
很多人一上来就写 for i in range(3): try...,等于假设全世界都是第 1 类。Agent 场景里,第 2、4 类其实非常常见。
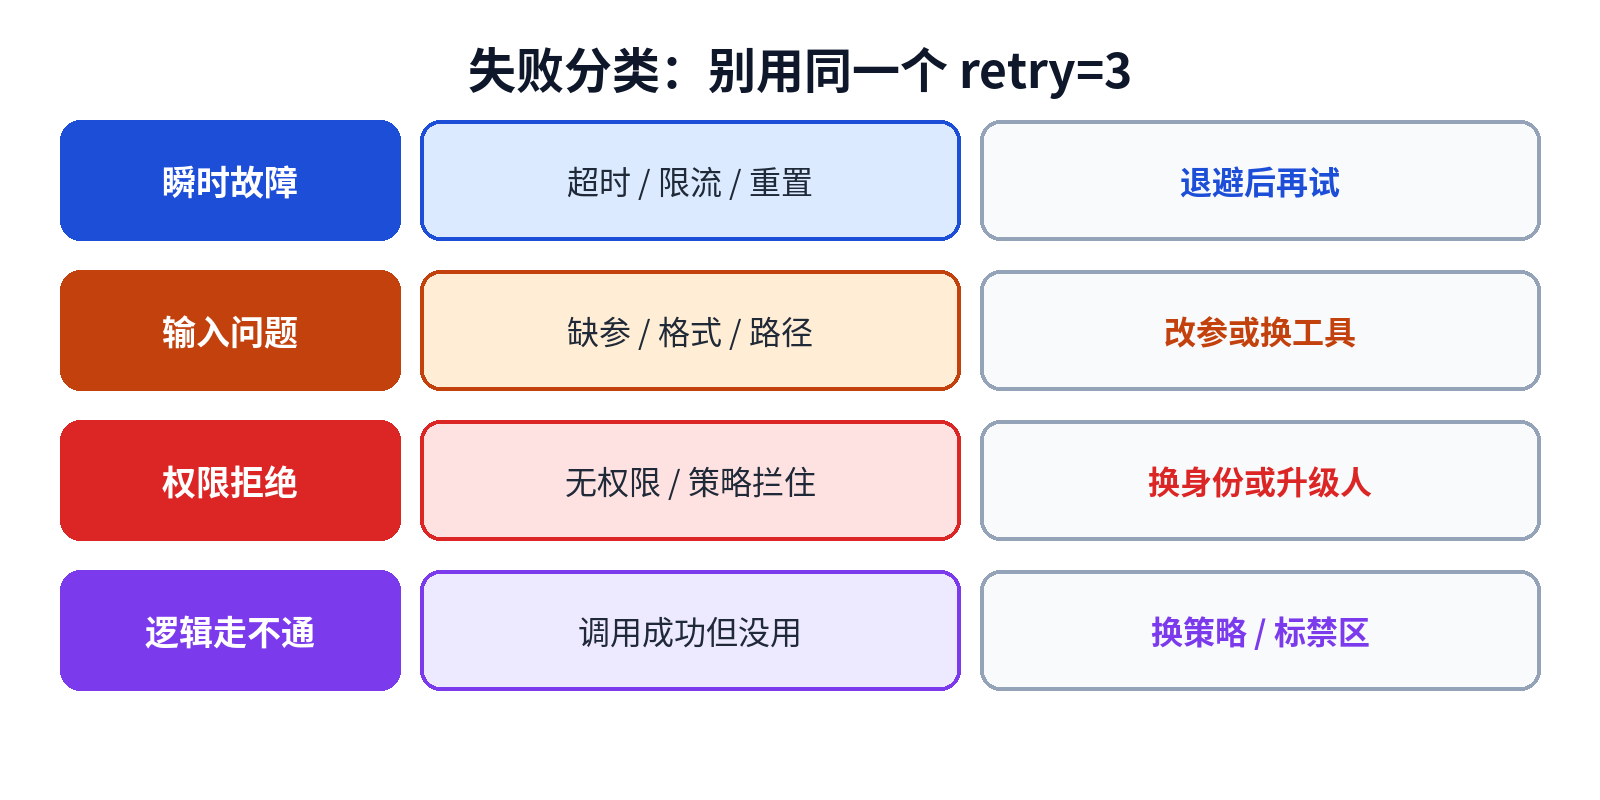
图:失败分类:瞬时、输入、权限、逻辑走不通(原创示意图)
同错不盲重试
我给自己立过一条很硬的规矩:如果错误签名相同,不要原地裸重试。
“错误签名”可以很朴素:异常类型 + 关键消息模板 + 工具名。两次失败长得一样,第三次还用同一参数打过去,多半是在烧钱。
更合理的动作是:
瞬时类:退避后再试(后面说)
输入类:先修参数,或让模型根据错误信息改参数;改不了就换工具/换路径
权限类:升级给能处理权限的人,或换有权限的工具,而不是循环撞墙
逻辑走不通:把“此路不通”写进状态,换检索词、换数据源、换分解方式
有一次我们的 Agent 调一个搜索工具,连续五次都返回空结果。日志看起来像“成功调用”,重试逻辑也认为“没抛异常,继续”。其实它在用一个过时的关键词死磕。后来加了规则:空结果也算一种“任务失败信号”,累计两次就强制换查询策略。成功率立刻好看了——不是模型突然聪明,是别让它在空井里打水。
退避:等一等,但要等得明白
瞬时故障当然该退避。指数退避 + 抖动,是老生常谈,我就不展开公式了。更想说的是 Agent 特有的两点:
第一,退避信息要进上下文。
别只在运行时 sleep。最好让模型知道:“刚才超时了,已退避,这是第 2 次尝试。”它若完全不知情,可能换一种更重的调用方式,反而更糟;或者重复解释同一错误,浪费 token。
第二,退避有预算。
总重试次数、总等待时间、总工具调用次数,都要有上限。Agent 很会“看起来还在努力”,实际上在原地踏步。没有预算的努力,是事故。
我还喜欢把“重试预算”按工具差异化:读操作可以宽一点,写操作(发消息、改数据、提交变更)要窄很多。写操作的盲重试,风险不是钱,是副作用。
什么时候该换路
换路比重试难,因为你要承认:当前计划错了。
我常用的换路触发器:
同一错误签名达到阈值(比如 2 次)
工具明确返回“不可重试”或“参数无效”
连续 N 步没有推进可观察的进度(进度定义要事先想好)
模型自己开始循环:反复调用同一工具、同一参数、同一解释
换路不是“换个同义说法再问一遍”。那叫换措辞,不叫换路。真正的换路包括:
换工具(搜索换官方文档抓取,本地文件换仓库检索)
换任务分解(大目标拆小,或先验证前提)
换信息来源(别只信第一次检索的前三条)
升级人类(有些坑不值得继续自动挖)
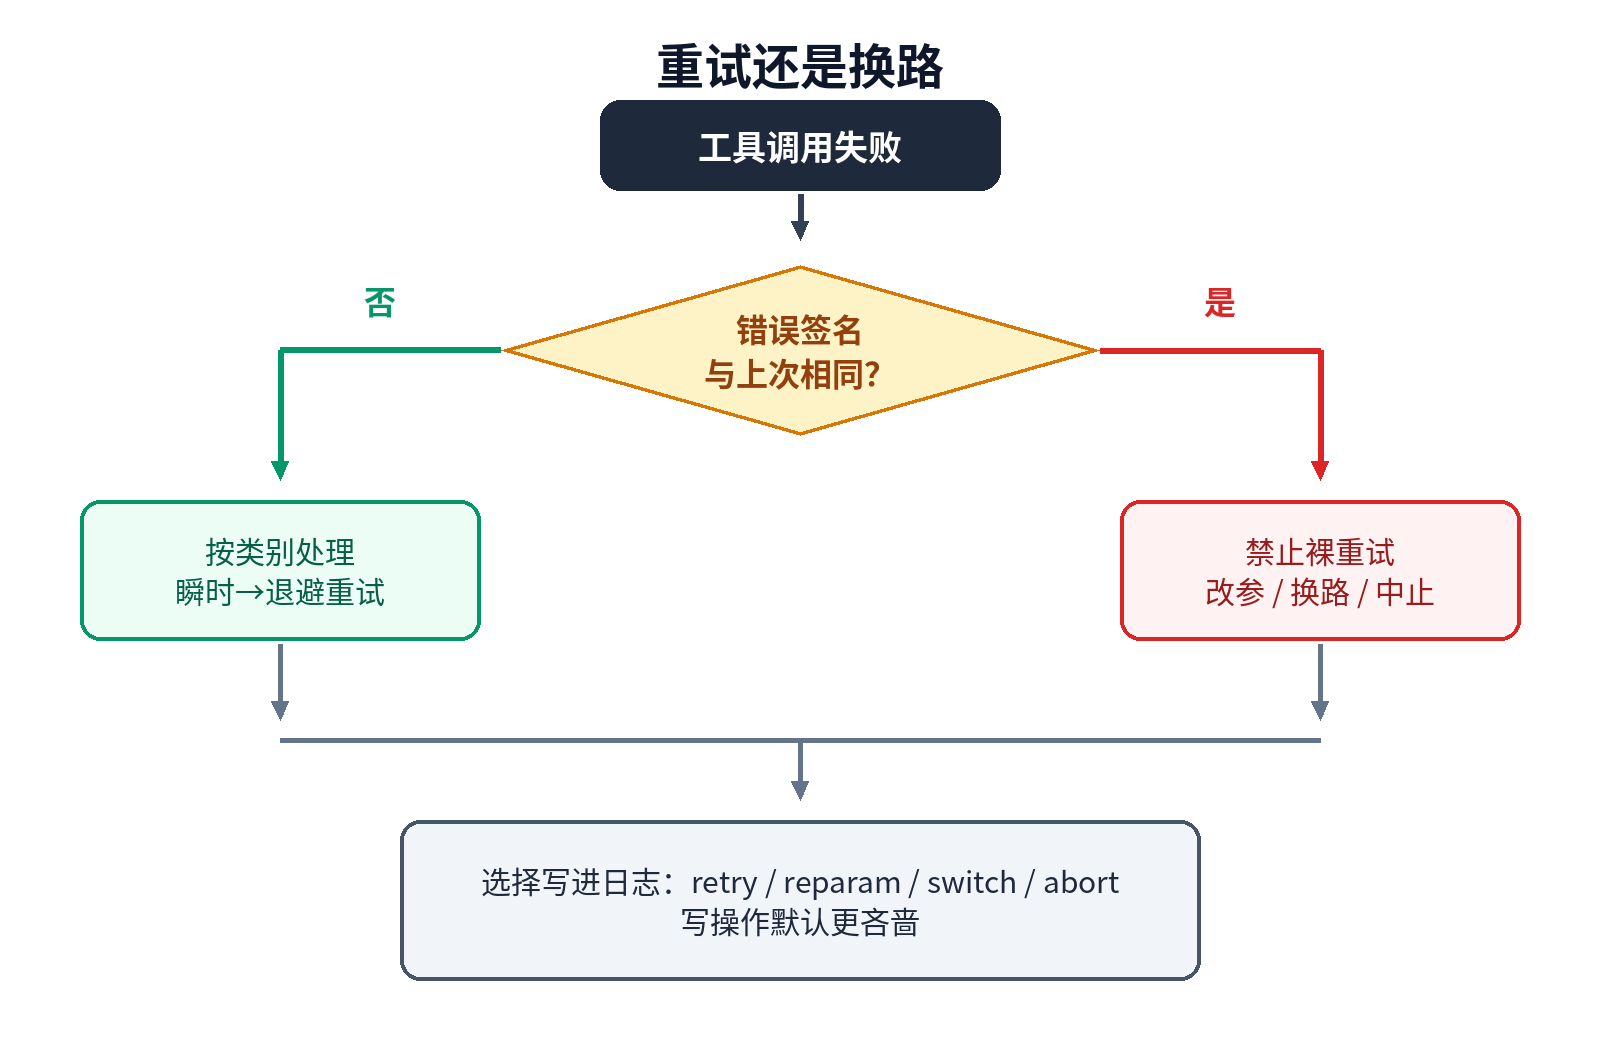
图:重试还是换路:按错误签名决策(原创示意图)
一个小模式:尝试 → 诊断 → 选择
我现在更愿意把失败处理写成显式三拍,而不是藏在 catch 里偷偷再调一次:
尝试:调用工具
诊断:把结果归到失败类别,生成简短诊断(可给模型,也可规则)
选择:重试 / 改参再试 / 换路 / 中止并汇报
把“选择”暴露出来,有两个好处:可观测(日志里能看到为何换路),可干预(人可以改策略)。很多 Agent 难调试,就是因为重试和换路发生在黑盒循环里,事后只看到一长串工具调用。
和提示词怎么配合
策略不全是代码。提示词里也可以写清楚,例如:
遇到相同错误不要重复同一调用
先根据错误信息提出假设,再选动作
写操作失败后默认不要自动重试,先汇报
不过提示词只能“劝”,不能“保”。真正不能破的底线(最大重试、写操作确认、预算)还是要落在编排层用规则卡死。模型心情好的时候听话,心情不好的时候……你懂的。
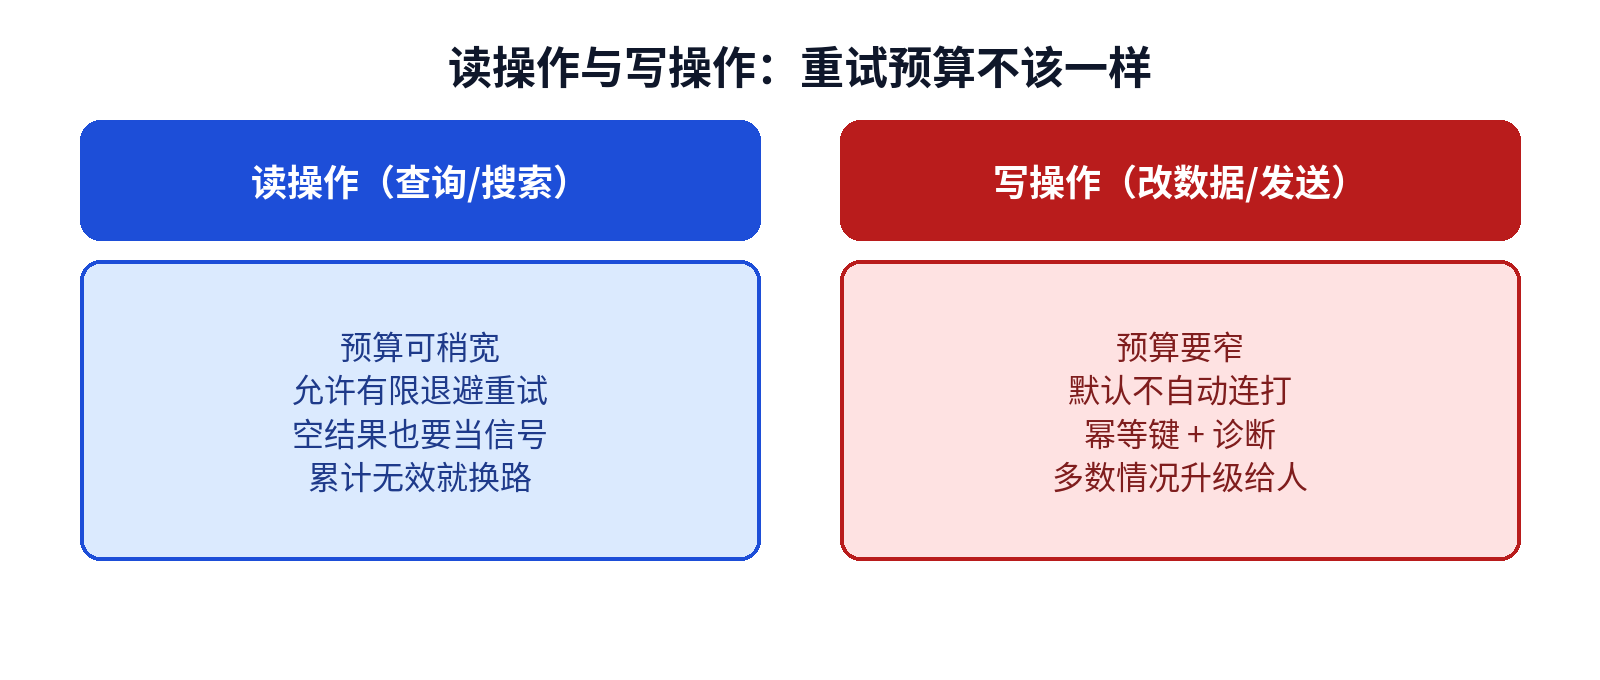
图:读操作与写操作:重试预算不该一样(原创示意图)
可观测性:没有日志就没有策略
这句也像废话,但 Agent 的重试日志特别容易糊成一团。我建议至少记下:
工具名、参数摘要、错误签名、类别判断
第几次尝试、退避多久
最终选择:retry / reparam / switch / abort
换路时的原因一句话
有了这些,你才能回答“我们是不是重试太多”或者“是不是过早换路”。没有数据的策略讨论,最后都会变成口味之争。
一个具体例子:下单前的库存校验
假设 Agent 要完成“帮用户下单”这类带副作用的流程。中间有一步是查库存。
查库存超时:这是瞬时类,可以退避重试,但次数要少,并且超时本身要记入诊断。
查库存返回“SKU 不存在”:这是输入/数据问题,原样重试毫无意义;应该换查询方式(换编码、换搜索)或向用户确认。
查库存成功但为 0:工具成功、任务受阻。继续“再查一次”偶尔有用(缓存延迟),但两次之后就该换路:建议替代商品、通知用户、或创建预留失败单——取决于产品设计。
真正下单接口失败:写操作。默认策略应是:记录幂等键、诊断错误、多数情况交给人,而不是自动连打三次下单。
把这个例子写进设计评审,比空谈“我们要智能重试”有效得多。因为大家会立刻看到:同一条链路里,不同步骤的失败策略根本不能共用一个 retry=3。
和人类协作时的换路
自动换路走到尽头,还有一种换路叫“交给人”。这不是认输,是分级。
我倾向在这些信号出现时升级:
涉及钱、权限变更、对外发送、不可逆删除
已经消耗了大部分预算仍无进展
模型连续两次提出互相矛盾的计划
工具返回明确要求人工处理的内容
升级时不要只丢一句“失败了”。把诊断、已尝试路径、错误签名、建议的人工选项一起交出去。人接得越轻松,Agent 才越像同事,而不是定时炸弹。
测试时怎么验证策略
策略写完如果不测,上线就是玄学。我常用几类注入:
强制超时 / 强制 429
固定返回参数错误
固定返回空结果
第一次写失败、第二次成功(测是否错误重试写)
同错重复(测是否触发换路)
看的指标也很直接:平均工具调用次数、同签名重复率、任务成功率、写操作重复执行次数(理想是接近 0 的意外重复)。提示词可以慢慢调,这些指标得先能看见。
最后
重试的本质是:我相信噪声会过去。
换路的本质是:我承认模型或计划可能错了。
Agent 难的地方在于,这两种情况长得很像——都是“这一步没达成目标”。所以我才会先做失败分类,再谈次数和退避。同错别盲重试,该换就换;写操作尤其要吝啬。
如果你正在调一个“偶尔能跑完、经常原地转圈”的 Agent,不妨先去日志里数一数:有多少次调用其实是同一错误签名的重复。这个数字,通常比再改两句提示词更接近真相。
 2026-10-14鱼鱼