

code review 一直是我又爱又烦的环节。爱的是能提前拦住问题;烦的是有些 PR 又长又绕,下午三点看到,眼睛先花了。
后来我开始让 AI 帮忙“先看一眼”。效率确实上来了:它能很快列出一堆疑点,有的还挺准。但用了一阵子,我也被它带偏过——有一次它言之凿凿说某段并发不安全,我跟着在评论区写了很长一段,作者委婉回复:那段代码根本不会并发进入。我再看,确实如此。尴尬归尴尬,也逼我把用法收紧了。
这篇不是教你“用 AI 替代 review”,而是聊聊:怎么让它当助手,却不把结论权交出去。
它擅长什么,不擅长什么
先说我自己的体感(不是评测数据,是使用感受)。
相对擅长:
扫一眼有没有明显的空指针、资源没关、错误被吞
对照 diff,指出“这里改了签名,调用方可能没改全”(在你把相关文件也喂给它的前提下)
把又长又碎的 diff 先总结成“这个 PR 大概想干什么”
按清单检查:日志、权限、事务、测试有没有明显缺项
不太擅长、或者说需要我警惕的:
对业务语义下结论(“这样用户会不会重复扣款”)——它不懂你们真实的业务不变量
对性能拍板(“这里会很慢”)——没有数据就容易吓人或漏人
对“作者意图”过度脑补——看着像问题的,可能是有意为之
风格偏好当成缺陷——命名丑不丑,不该占 review 的主场
一句话:让它找疑点,很合适;让它当法官,不合适。
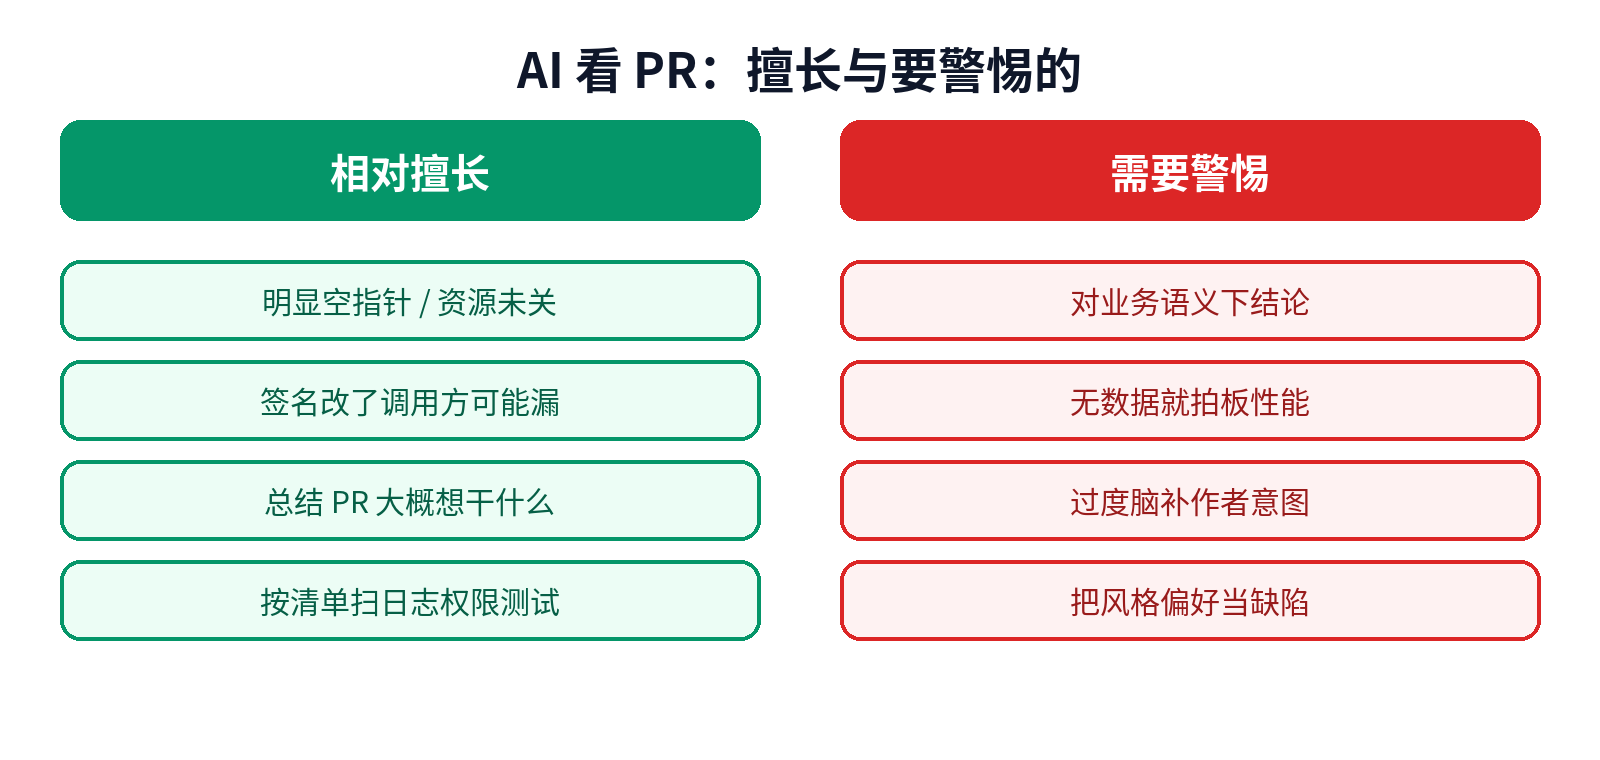
图:AI 看 PR:擅长与要警惕的对照(原创示意图)
我现在的固定流程
流程不复杂,关键是顺序。
第一步:我自己先读 PR 描述和测试说明。
连描述都不读就丢给 AI,等于把“理解意图”也外包了。意图都没建立,后面它说什么你都难判断。
第二步:让 AI 做“疑点清单”,并强制格式。
我会明确要求:
按严重程度分组:必须讨论 / 建议改进 / 仅供参考
每一条都要引用具体文件和大致位置
每一条都写“为什么你觉得可能有问题”,以及“怎样才能证实或证伪”
不允许只给空泛的“建议增加注释”“建议优化性能”
格式一固定,它就很难用套话灌水;我也更容易一条条核对。
第三步:我只挑“必须讨论”和我觉得可疑的“建议改进”去看代码。
其他的可以快速扫。AI 列了十二条,不代表我要评论十二条。review 的质量不看评论数量。
第四步:评论里写的是我的判断,不是它的原话。
即便某条完全来自 AI 的提醒,我也会用自己的话重述,并补上上下文。这样作者看到的是可讨论的观点,而不是“机器人说你错了”。
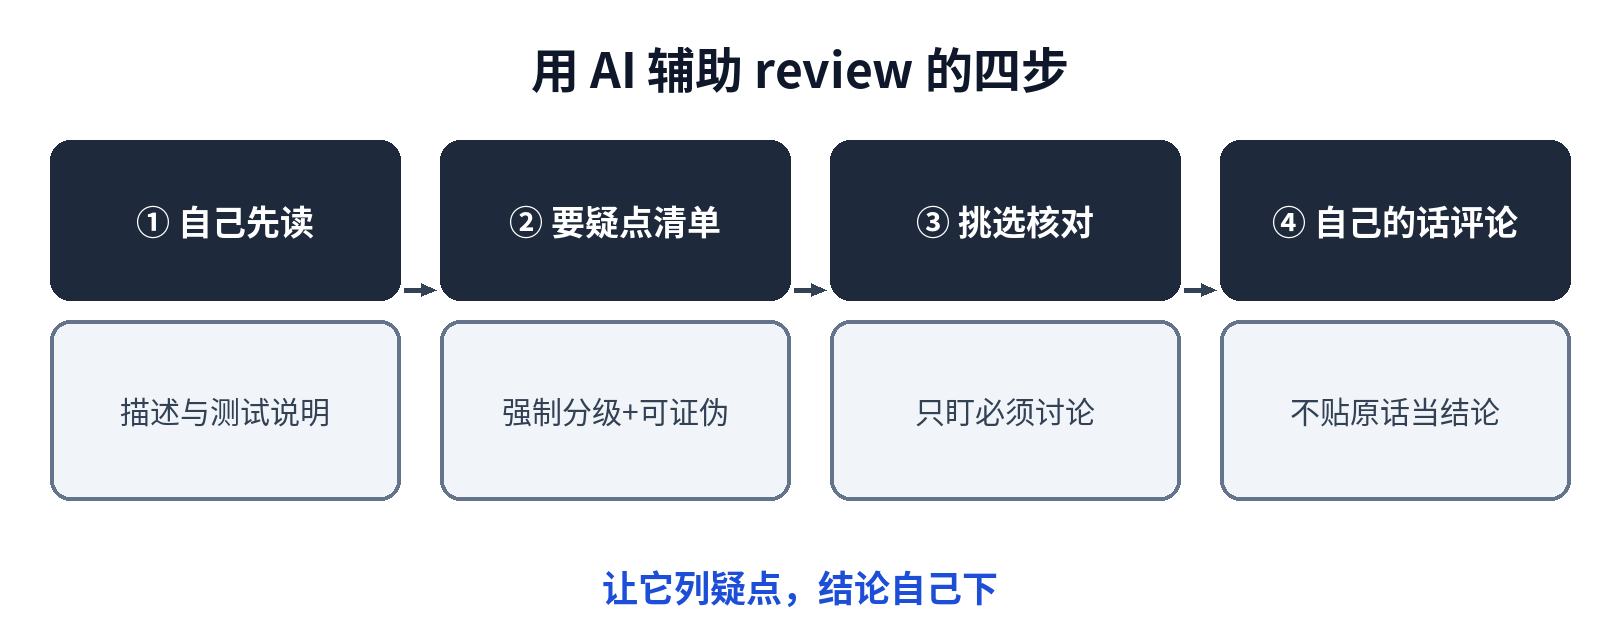
图:用 AI 辅助 review 的四步流程(原创示意图)
怎么喂上下文,才不容易胡说
早期我只贴 diff,结果它经常基于想象补全“调用方会怎样”。后来我改成:
贴 PR diff(或让工具读取变更文件)
额外补:相关的接口定义、核心不变量说明、作者在描述里强调的风险点
如果涉及并发/事务,补一段“我们线上实际的调用方式”
还有一个很有用的约束句:“不确定就标不确定,不要把猜测写成事实。”
加了这句之后,清单里会出现更多“可能……需要确认……”——这看起来弱,其实更健康。弱一点的疑点,比斩钉截铁的误判值钱。
被带偏的几种典型姿势
我把自己踩过的坑归了类,方便警惕:
权威感陷阱。 它输出条理清晰、编号齐全,读起来就像正式审查意见。条理清晰不等于正确。
清单强迫症。 列得越多越安心,于是把“仅供参考”也变成必须回复的评论,PR 讨论区噪音变大。
风格霸权。 它按某种“最佳实践”模板扫,跟你们仓库惯例冲突时,会把惯例当缺陷。
责任外包。 心里暗暗想:AI 都看过了,我少看一点也行。这是最危险的——出了问题,背锅的是人。
对应的反制也很简单:限制输出条数(比如“最多 8 条”)、强制分级、自己重述后再评论、以及保留“我至少完整读一遍关键路径”的底线。
和作者怎么相处更舒服
用 AI 辅助 review,最好在团队里把预期说开。我倾向这样表达:
“我用工具帮忙扫了一遍,下面几条是我核对后觉得值得讨论的。”
不说“AI 认为你这里有问题”——既不礼貌,也把讨论引到工具对错上。
如果某条最后证明是误报,就坦然收回,别硬刚。
作者侧其实也能受益:有人会在开 PR 前自己先让 AI 扫一轮,把显而易见的问题先清掉。这跟“提交前跑 lint”差不多,不丢人。
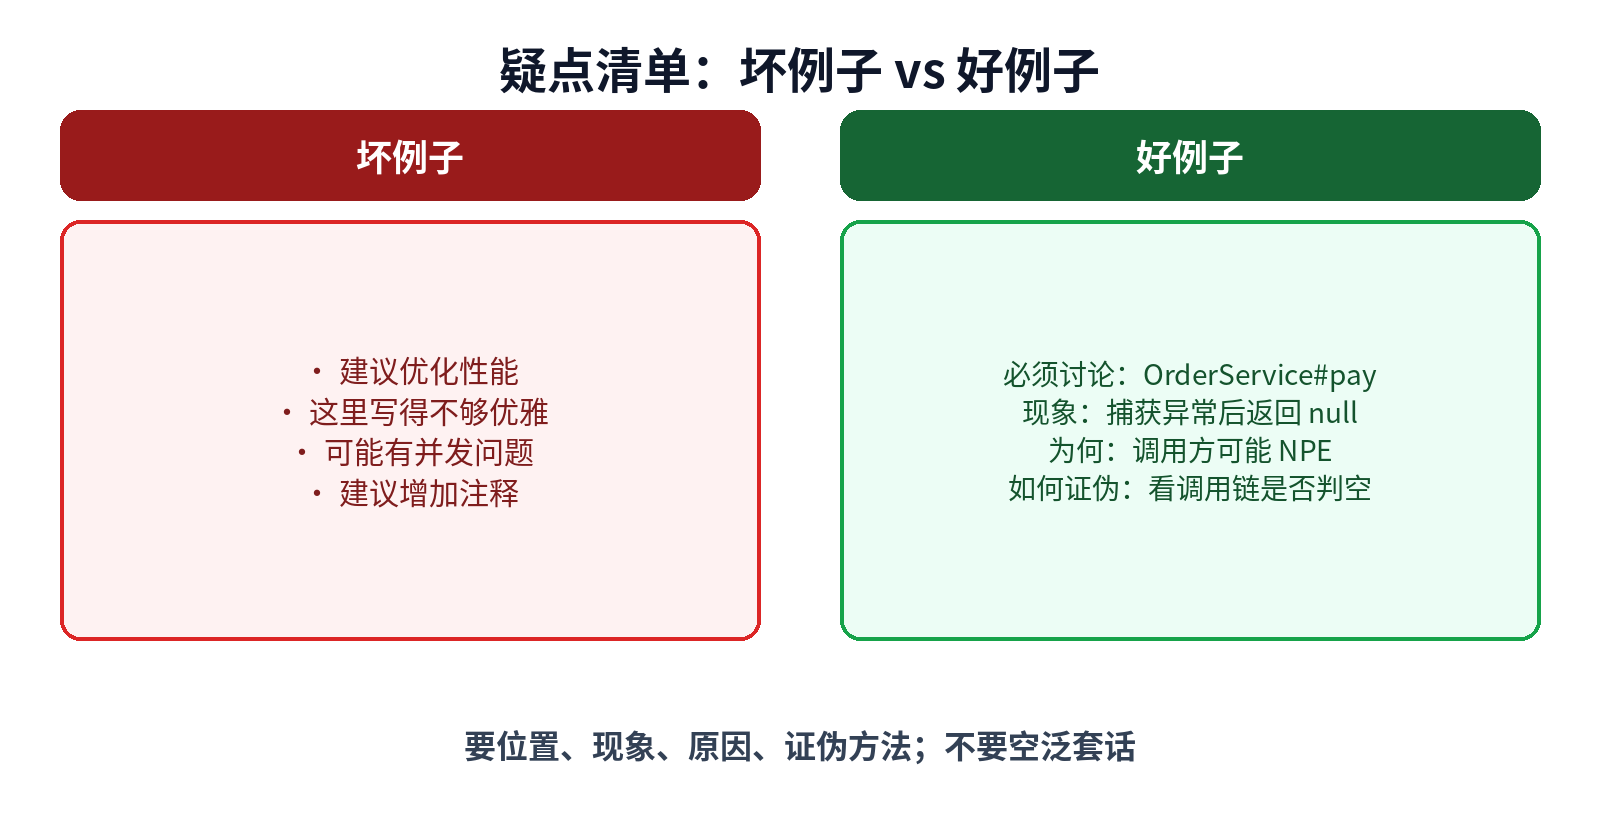
图:疑点清单的坏例子与好例子(原创示意图)
什么 PR 我几乎不用 AI
也有不适用的时候:
改动极小、意图极清楚(修个文案、调个超时)
强依赖领域知识,而我自己就是领域负责人——工具帮不上太多
涉及安全敏感、权限模型重构——可以让它找表面问题,但核心必须人审,而且最好多人审
反过来,特别适合用的是:大而机械的重构、大量样板变更、我不太熟的模块的“先摸清在干什么”。它先帮我画地图,我再决定在哪里下钻。
一个我觉得好用的提示词骨架
我不迷信“神级提示词”,但有一个骨架用下来比较稳,大致是这样(按需裁剪):
你在协助我做 code review,不是代替我下结论。
请只基于我提供的 diff 和补充材料。
输出格式:
1)必须讨论(可能影响正确性/安全/数据)
2)建议改进(可读性、结构、测试缺口)
3)仅供参考(风格、可选优化)
每条包含:位置、现象、为何可能有问题、如何证实或证伪。
不确定请明确写不确定。不要编造未提供的调用关系。最多 8 条。
然后把 PR 描述、关键文件 diff、以及我知道的不变量贴进去。
用骨架的好处不是“它会突然变聪明”,而是把输出形状固定住,方便我审查它的审查。没有形状的长文,最容易把人带进沟里。
误报怎么处理,才不浪费时间
AI 辅助 review 一定有误报。我的处理方式是分级消化:
一眼能否掉的:直接忽略,不进评论区。
吃不准的:自己花两分钟读相关代码;还吃不准,就写成疑问句问作者(“这里会不会出现……?”),而不是断言。
确认是问题的:正常提,附上复现或推理。
千万别把误报也当成“严格”的证明。严格的意思是抓住真问题,不是把空气都审一遍。作者被误报轰炸几次之后,对 review 的信任会掉——这比漏一条中等问题更伤团队。
和“自己写的代码让 AI 看”有何不同
看别人的 PR,和看自己即将提交的代码,心态不一样。看自己的,我允许它更狠一点,甚至故意让它“找茬”;看别人的,我必须更克制,因为评论是社交行为,不只是技术行为。
所以同一套工具,我会用两套温度:自扫时可以要“尽量多找潜在问题”;看别人时要“少而准,且可证伪”。温度调不对,要么得罪人,要么放过该拦的东西。
最后
AI 看 PR,最容易让人膨胀的一点是:你好像瞬间变得更“严谨”了,输出更多意见、覆盖更多检查项。但 review 的本质不是意见的密度,而是有没有抓住真风险,有没有帮作者把变更讲清楚、留得安全。
我现在的原则就一句:让它列疑点,结论自己下。 它负责扩大我的视野,我负责负责。视野可以借,责任不能借。
如果你也在用类似方式,不妨回头看最近两条自己的 review 评论:有没有哪条是“读起来很专业,但自己其实没核对过”的?有的话,那就是被带偏的信号。收一收,会更踏实。
 2026-10-14鱼鱼