

用 AI 写代码久了,我会下意识把它分成两种节奏:一种是编辑器里那个“跟着你敲”的补全;另一种是对话框里“给我写一整段 / 一整文件”的生成。
表面上都是 AI 在写,体感完全不一样。补全像有人在旁边帮你把下一句顺出来;整段生成像你把需求扔出去,过一会儿收回来一份成品。我早期几乎只用后者,觉得效率高;后来越写越觉得:很多时候,补全才是更省心的那一个。这篇就聊聊我现在怎么选。
补全:跟手,但别关机思考
补全的好处很直观——上下文就在光标周围,你刚写的函数名、变量名、注释,它都能“看见”。你按 tab 接受一行,再敲两下,它继续跟。这种节奏很接近自己写,只是手变快了一点。
我特别喜欢在这些场景用补全:
-
写样板代码:DTO 字段、简单的 getter/mapper、重复的校验
-
顺着已有风格往下写:同一个文件里已经有三个类似分支,第四个让它跟
-
补测试数据、补日志、补明显的空值判断
-
把注释里的意图落成代码(注释写清楚的时候,补全命中率会高得吓人)
但补全也有坑。最大的坑不是“写错”,而是写得太顺,我就不审了。有几次我连续接受了七八行,回头一看:它悄悄引入了一个我这个模块根本不该依赖的工具类,或者把异常吞掉改成了返回 null。编译能过,测试也可能碰巧绿,问题埋在更后面。
所以我给自己定了个小规矩:连续接受超过三行,就强制停一下,把这三行当别人的 PR 看一眼。 听起来矫情,但真的拦下过不少“顺手的错”。
整段生成:适合开工,不适合收尾
整段生成适合另一类事:我还没有落笔,或者落笔成本很高的时候。
比如:
-
从零搭一个小模块的骨架(包结构、接口、空实现)
-
把一段自然语言需求,先变成可运行的第一版
-
生成我不太熟的样板:某个库的标准用法、一次完整的配置示例
-
把已有代码翻译成另一种写法(比如同步改异步的第一稿)
这些场景里,对话框的优势是“你可以先把约束说全”:用什么框架、不能引入什么依赖、错误怎么返回、要不要线程安全。补全很难一次听完这么多话。
可整段生成的代价也很清楚:收回来的东西往往局部正确、整体需要你重新负责。变量命名跟仓库风格不一致、边界条件按它的想象写、测试只覆盖 happy path、注释写得很勤快但有的是错的。
我现在把整段生成定位成“草稿机”,不是“完工机”。生成之后,我一定会做三步:通读一遍、跑一下最关键路径、再决定是小改收编,还是拆开重写关键部分。
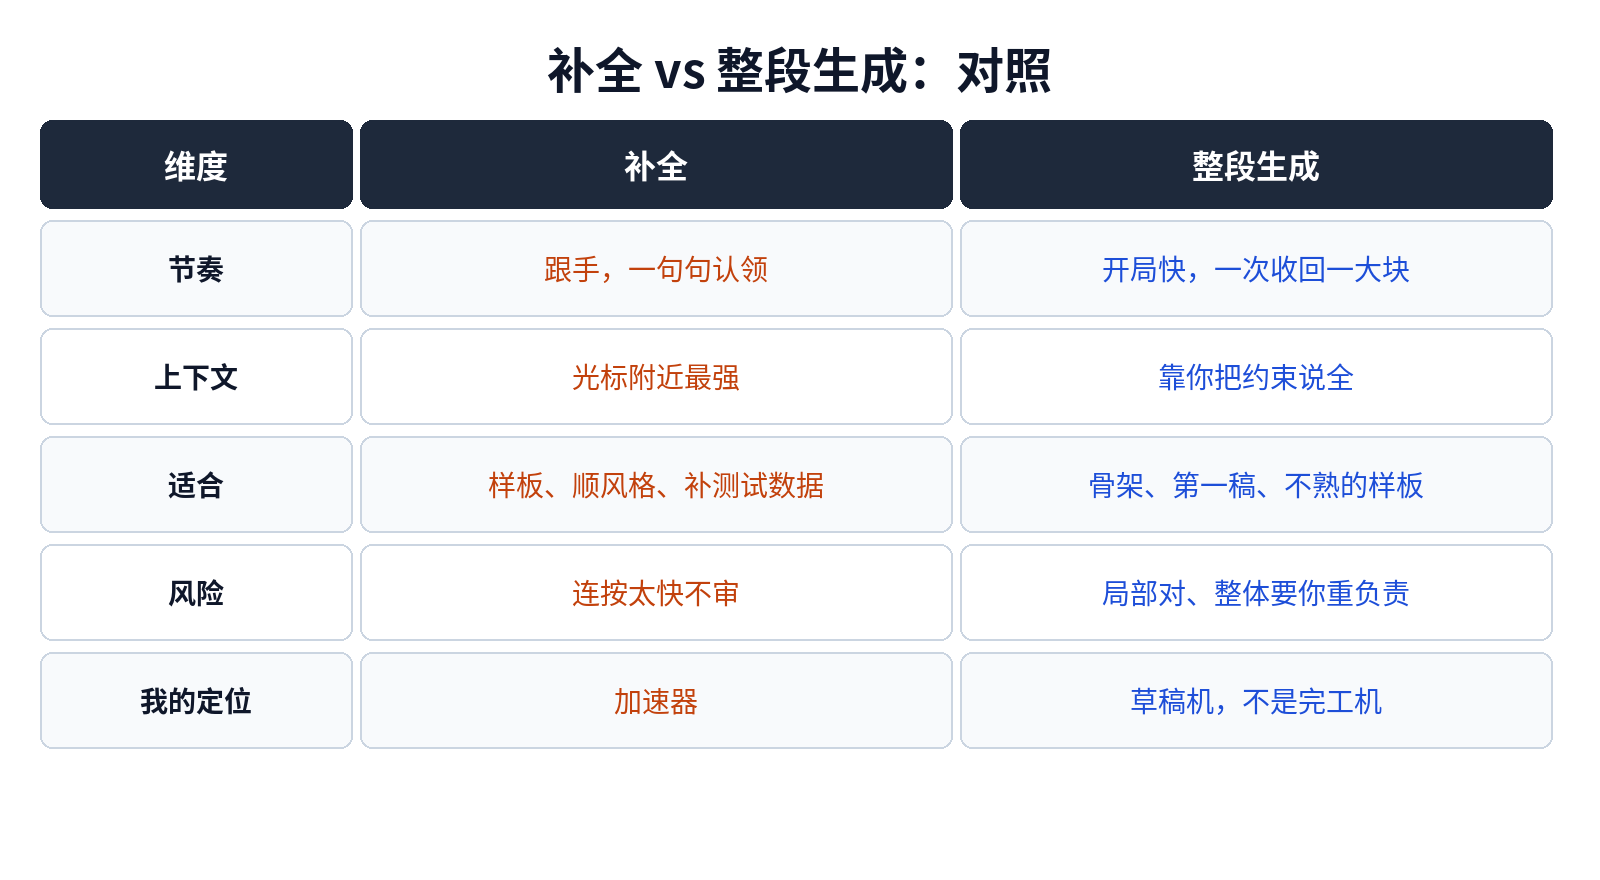
图:补全 vs 整段生成:对照表(原创示意图)
我怎么决定用哪一种
说白了就一句话:我是不是已经“在状态里”。
如果我已经打开了正确的文件,知道下一句大概长什么样,只是手慢或者懒得敲重复结构——用补全。
如果我还在门口徘徊:不知道文件该放哪、接口该怎么切、先写哪一层——先别补全,去对话框把骨架聊清楚,或者让它生成一版草稿再裁。
还有一个信号也很好用:我是否能用一句话说清“成功长什么样”。说得清,整段生成的约束就写得出来;说不清,生成十次也是在碰运气,不如先自己写两行、用补全往前拱,边写边想清楚。
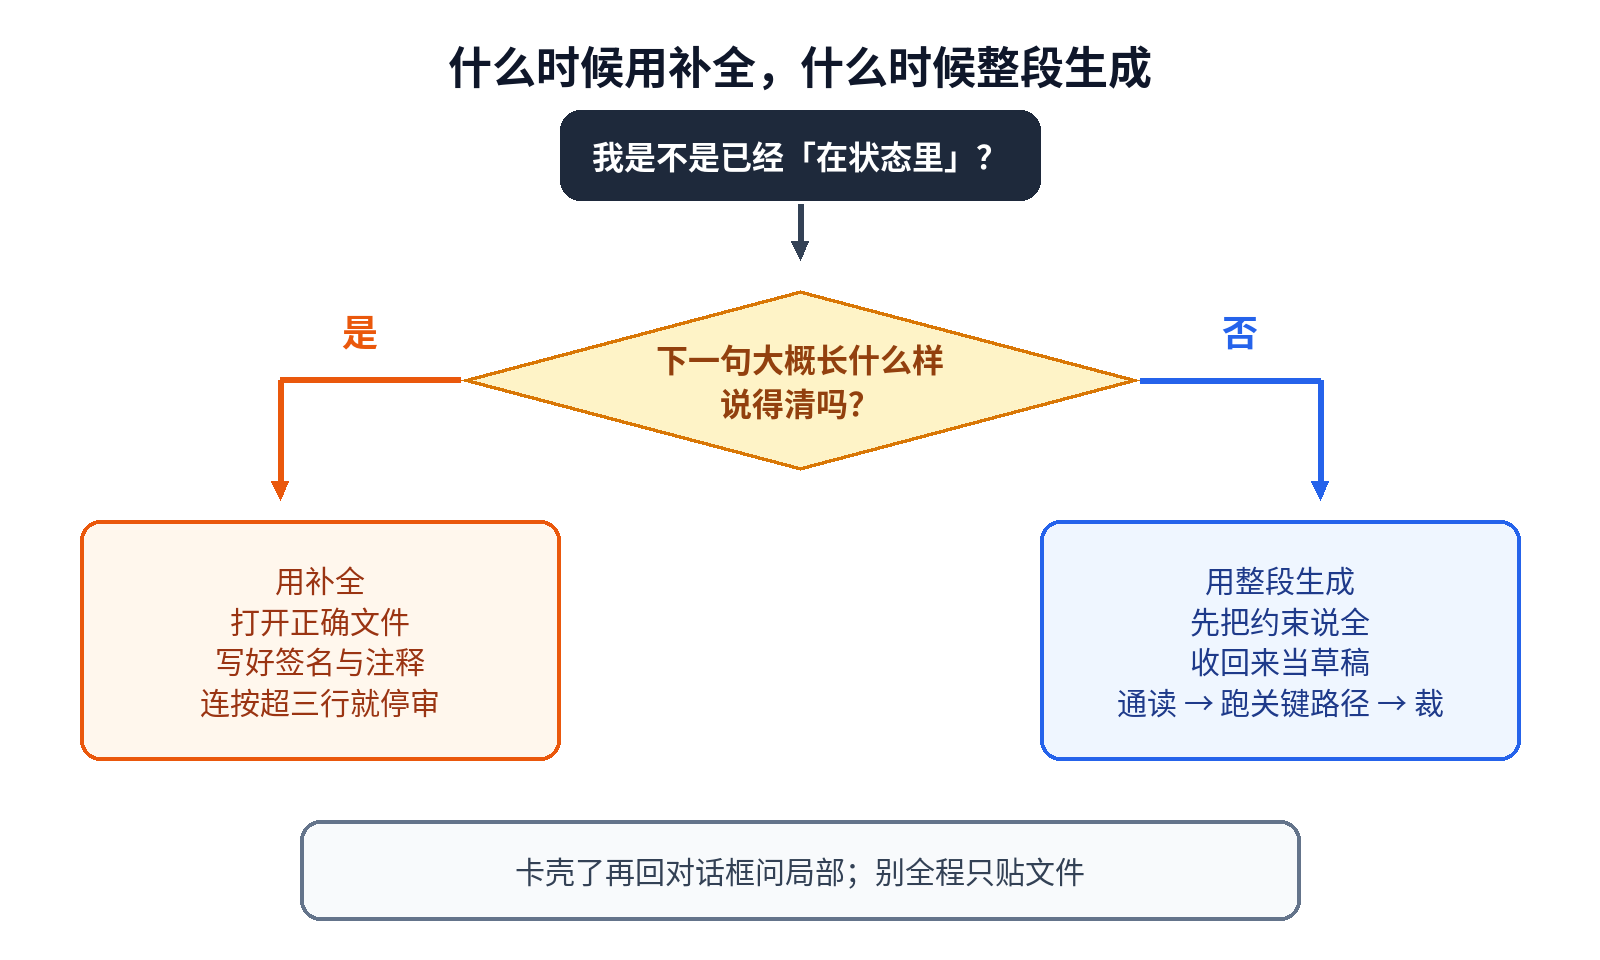
图:什么时候用补全,什么时候整段生成(原创示意图)
一个真实切换:同一功能的两种写法
有一次我要给一个已有的查询接口加“导出 CSV”。
第一反应是打开对话框:把 Controller、Service、现有查询条件贴进去,说“帮我加导出”。它很快给了一整套:新接口、流式写出、表头、甚至还顺手加了权限注解。看起来很全。
我试着接入,发现两处不对:一是权限注解用的不是我们项目的那一套;二是导出字段顺序和前端表格不一致,它按实体字段顺序排了。改这两处倒不难,但让我意识到:我其实已经有查询逻辑了,真正缺的是“写出”那一层,不需要它重做半个接口。
于是我换了个办法:自己新建一个方法,写好方法签名和两行注释(字段顺序、是否要 BOM),然后在方法体里用补全往下走。它顺着我的签名补循环、补转义、补 flush。中间我改了两次字段列表,它也能跟上。最后代码量比第一版少,风格也更贴仓库。
不是说整段生成不好,而是那一次我已经站在半山腰了,却让它从山脚重新爬。补全更适合“接着写”;整段更适合“从头起”。
混用比单选更常见
实际工作里,两者经常前后脚出现:
-
先用整段生成拿骨架(或者让它列步骤,我自己建文件)
-
填细节时切回补全,保持跟手
-
卡壳了(比如某个 API 不熟),再回到对话框问局部问题
-
最后用对话框做一次“找味道不对的地方”,但结论自己定
我不太喜欢一种极端:全程只在对话框里来回贴文件,编辑器变成贴板。那样上下文来回搬运很累,也容易版本错乱——你改了一处,忘了同步给它,它下一轮又基于旧代码改。
另一种极端也不好:全程只靠补全,遇到结构性问题硬刚。补全能让你写得很快,但很难帮你做“要不要拆类、要不要换抽象”这种决策。决策还是得抬起头来想,或者专门开一轮对话。
几个让补全更准的小习惯
这些是我自己觉得有用的,不一定普适:
-
先写意图再写实现。 方法名、参数名、一句注释先敲对,补全会稳很多。
-
别在烂文件里指望神补全。 又长又乱的类,补全也会被带偏。先整理到能读,再加速。
-
接受前看一眼右侧/下方的预览。 很多工具支持多行预览,养成扫一眼的习惯,成本很低。
-
类型信息尽量齐全。 弱类型或 any 飞舞的地方,补全更容易“瞎编一个差不多的”。
整段生成这边,我则更强调约束清单:禁止事项往往比允许事项更重要。比如“不要引入新依赖”“不要改现有函数签名”“错误返回要跟本模块其他接口一致”。约束写在前面,返工会少一截。
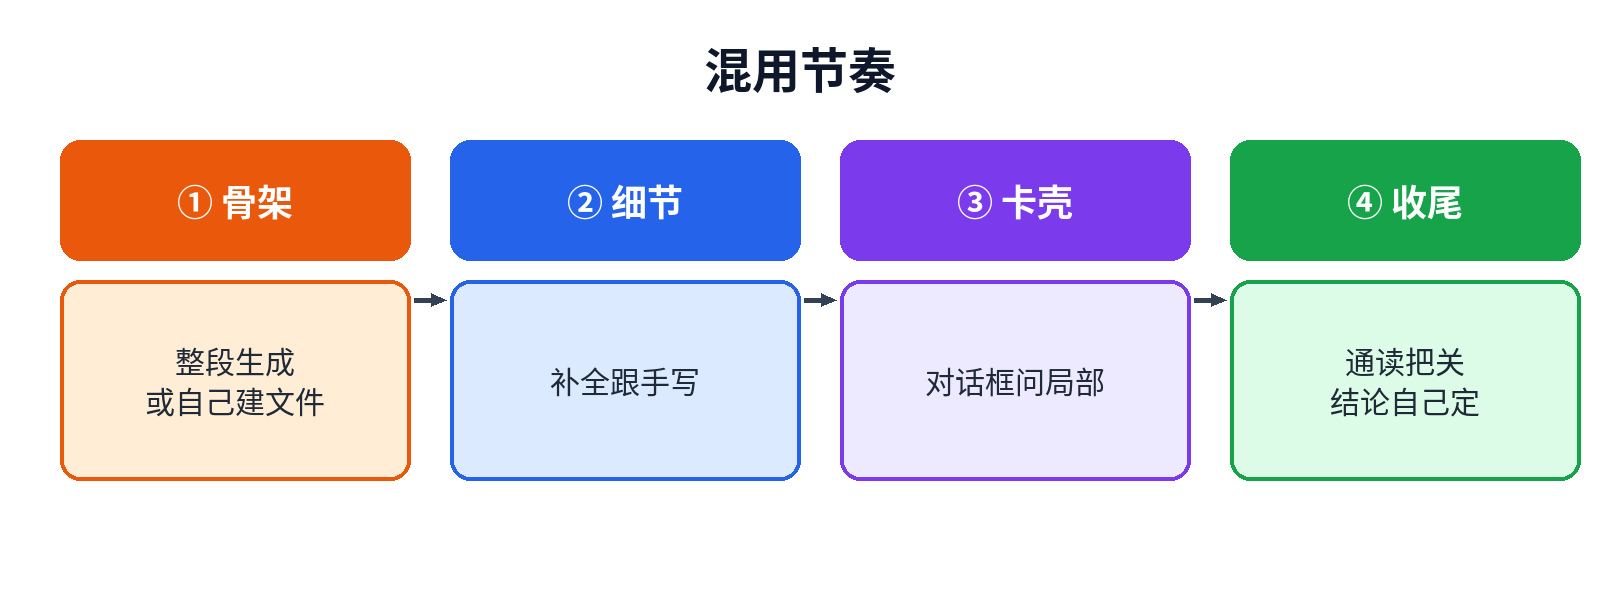
图:混用节奏:骨架用生成,细节用补全,卡壳再问(原创示意图)
团队里怎么对齐这件事
如果只是自己用,怎么选都还好。一旦团队里好几个人都在用 AI,补全和整段生成的差异会变成 code review 里的隐性成本。
我见过一种情况:有人习惯整段生成,PR 又大又整齐,局部读起来都对,但跟仓库里既有的错误处理、日志字段、事务边界对不上。审查的人要花额外时间问:“这是你手写的风格漂移,还是生成稿没收干净?”另一种情况是补全党:提交很碎、风格统一,但偶尔会有“连续 tab 出来的半截逻辑”,审查时反而更难发现,因为 diff 看起来很本地、很正常。
所以我后来在团队里只强调两句很软的约定,不搞硬性规定:
-
整段生成的代码,作者自己先标一下“哪些段落是生成后改过的、哪些几乎没动”,方便审查聚焦。
-
不论哪种方式,超过一定规模的逻辑变更,测试和关键路径说明不能省——生成不能替代说明。
这两句不完美,但能减少“看起来像人写的,其实是生成草稿没消化”的尴尬。工具改变的是手速,不该改变我们对变更的责任边界。
最后
补全和整段生成不是高低配置,是两种工作模式。一个跟手,一个开局;一个适合在状态里加速,一个适合在状态外探路。
我现在的默认策略很简单:能补全解决的,就别整段生成;整段生成出来的,就当草稿,别当定稿。 工具越强,越要自己把关——这句话说俗了,但真写起来,俗话往往最管用。
如果你最近觉得“AI 写得快,但我审查更累”,不妨观察一下自己是不是过度用了整段生成。把更多时间留在补全的跟手节奏里,累的感觉有时会轻一点:因为代码是你一句句认领下来的,而不是一次性砸到桌上的。
 2026-10-14鱼鱼