

以前一看到红字堆栈,我的第一反应几乎是:全选、复制、粘贴进 AI 对话框,然后等它告诉我怎么改。
说实话,这个习惯有一段时间挺好用。很多常见错误,它一眼就能看出来,比我自己翻文档快。可后来我发现,有一半以上“贴完还是修不好”的情况,并不是 AI 不行,而是我把一坨还没整理过的信息甩给了它。它只能在这坨信息上猜,猜错了也不奇怪。
现在我会强迫自己先做三件小事,再决定要不要问、怎么问。这三件事加起来通常不超过五分钟,但后面少绕很多弯路。
第一件:自己先扫一眼堆栈
不是真的要自己把根因找出来,而是先回答两个很朴素的问题:
这条报错,我看得懂“是什么”吗?发生的位置,离我刚改的代码近吗?
很多堆栈很长,真正有用的往往就那么几行:异常类型、消息正文、以及“第一次进入我自己代码”的那一帧。框架内部、依赖库内部的几十行,一开始可以先折叠起来不看。
我以前常犯的错,是把整段堆栈原封不动贴出去,指望 AI 从噪声里捞出重点。它有时确实能捞到,有时会盯着某一帧框架代码大做文章,给出一套和我业务完全无关的“修复建议”。我照着改,项目更乱。
所以现在的习惯是:先自己标出“我认为最关键的三行”,再决定贴什么。贴的时候我会主动说:“请优先看我标出来的这几行,其余堆栈仅作参考。”效果比“这是报错,帮我看看”好太多。
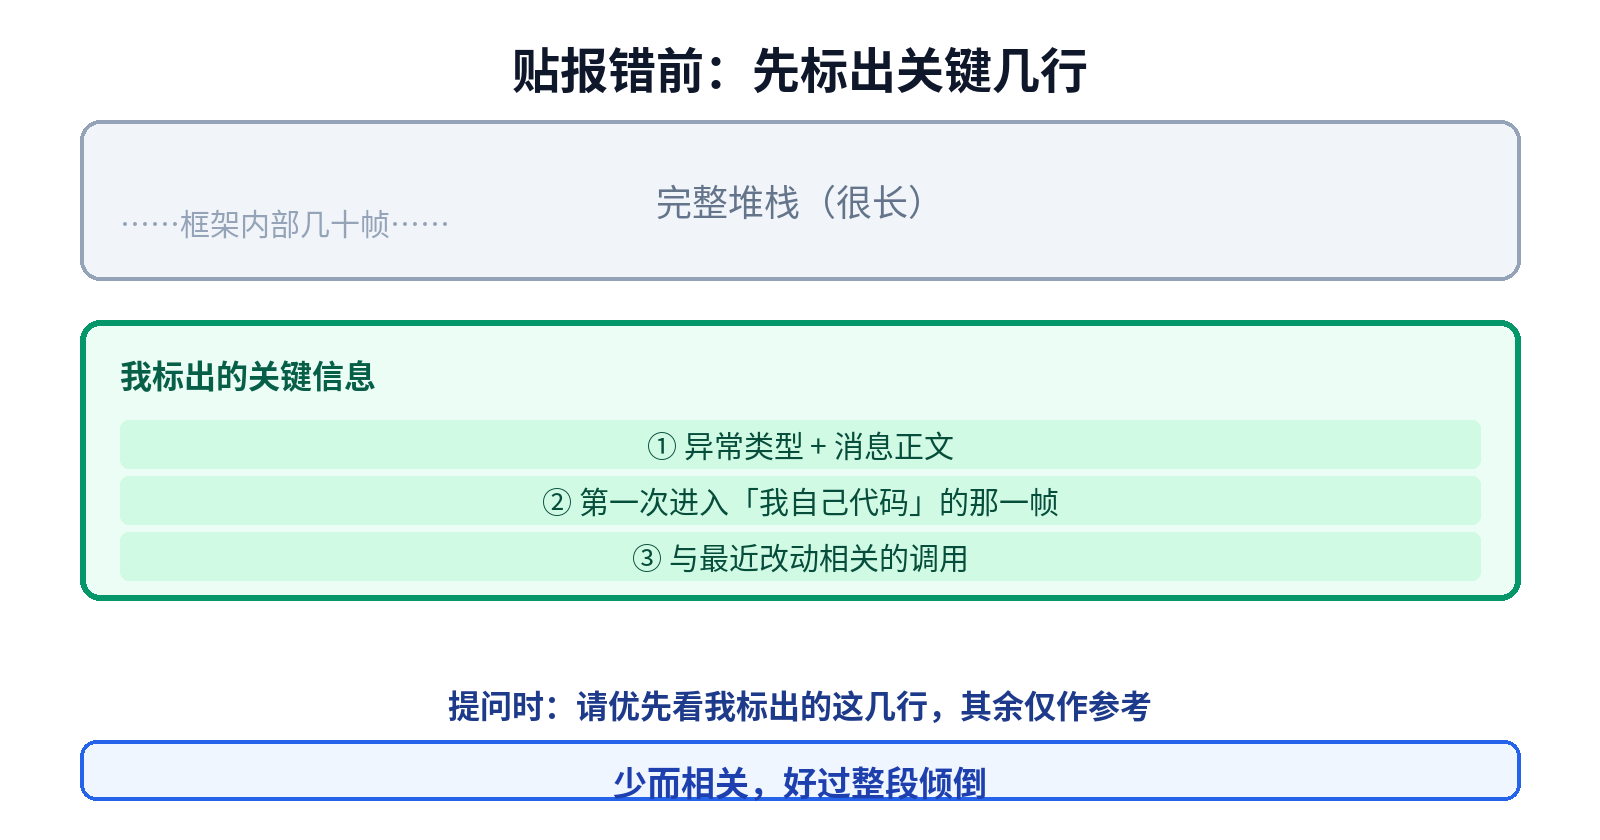
图:贴报错前先扫一眼:标出关键几行再问(原创示意图)
还有一类情况,扫一眼就能自己解决:拼写错误、少导了一个包、环境变量没设、端口被占用。这类问题去问 AI,不是不行,而是浪费一次对话的上下文,也浪费自己的注意力。能三十秒搞定的,就别开一场“诊断会”。
第二件:确认我能稳定复现
这条听起来像废话,但我自己确实踩过坑。
有一次测试环境偶发空指针,我把当时的日志贴给 AI。它分析得很认真,怀疑是并发下的时序问题,还建议加锁。我加了,问题好像少了,过两天又出现。后来才发现,是某次部署漏了配置,只影响部分实例——根因根本不是并发。
如果我当时先花两分钟确认:同一输入、同一环境,能不能稳定再来一次? 后面那一串“看起来很高级”的并发讨论,根本不会发生。
所以现在我问自己三句:
我能不能用同样的操作再触发一次?
是本地、测试,还是只有线上?
最近有没有改过相关代码、依赖或配置?
如果复现不稳定,我会先把“偶发”这两个字写进问题里,并补充出现频率、是否跟某个接口/用户有关。AI 对“偶发”和“必现”的推理路径差很多;你不说,它默认你给的是稳定场景。
复现的过程里,我还会顺手做一个小隔离:能不能写一个最小示例,或者至少把无关模块先绕开?最小复现不一定每次都做得出来,但哪怕缩小一半范围,贴出去的信息质量也会高一截。
第三件:把“上下文名片”写好再提问
这是我改动最大、也最值的一步。
以前我的提问经常是:“报错如下,怎么修?”后面贴一大段堆栈。现在我会在堆栈前面加一张很短的“名片”,大概包括:
语言 / 框架 / 关键依赖的版本(能写精确就写精确)
我刚做了什么(升级、改接口、重构、换环境……)
我已经排除过什么(比如“不是空配置,配置文件里确实有这个键”)
我希望它输出什么(只解释原因 / 给修改方案 / 给排查步骤)
最后这一条特别重要。你不说,它常常直接甩一段“完整修复代码”。可有时候我只想理解原因,自己改;有时候我要的是排查清单,不是上来就改生产相关逻辑。把期望说清楚,比堆更多日志更有效。
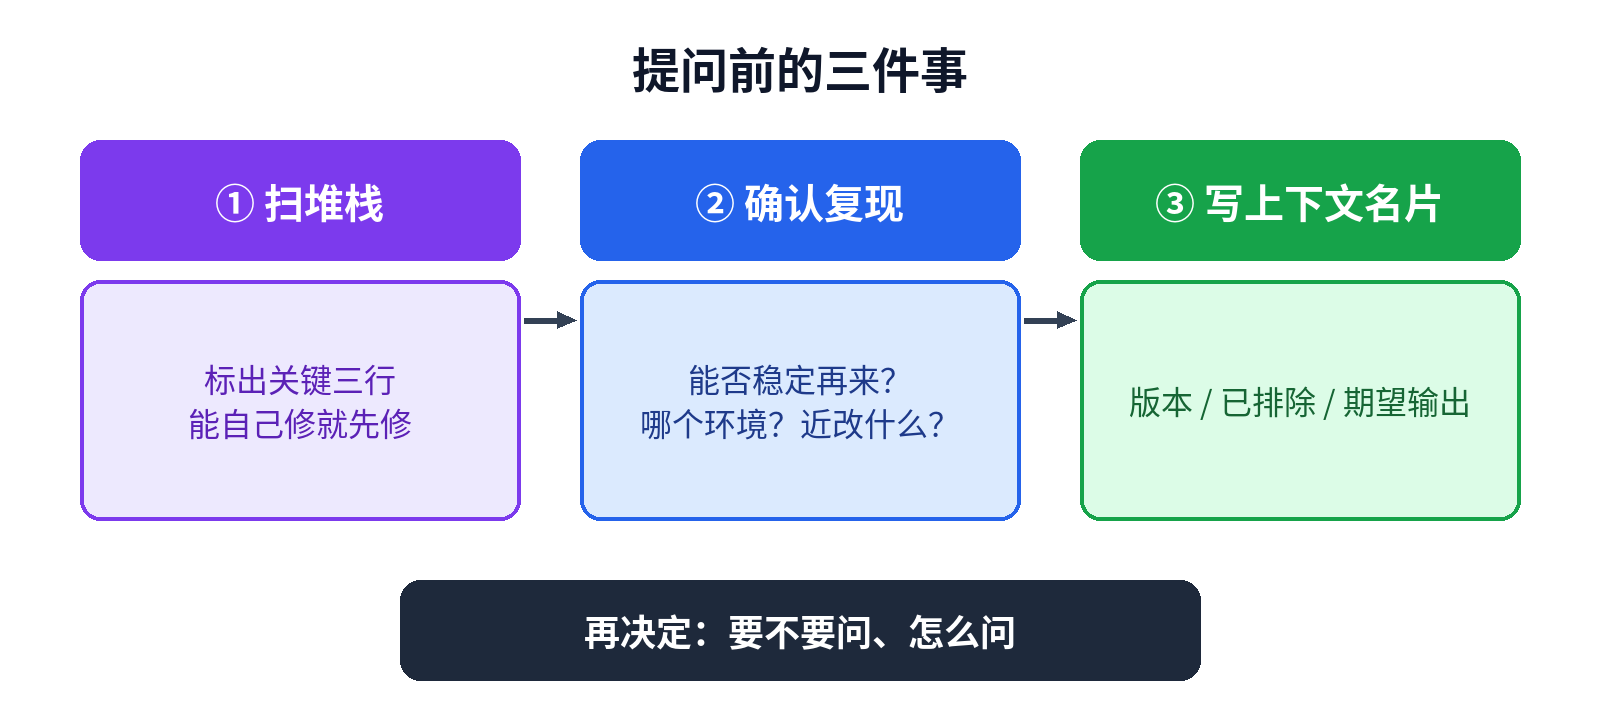
图:提问前的三件事:扫堆栈、确认复现、写清上下文(原创示意图)
我还发现一个反直觉的点:信息不是越多越好。把整个应用日志、整份配置文件、半个模块的源码一股脑贴进去,AI 的注意力会被稀释。我现在宁可少贴,但每条都相关;缺了它会问,我再补,比一次性倾倒强。
一个对比:同样的报错,两种贴法
有一次我在本地起服务,报了一个依赖注入相关的错误。两种贴法,结果差很多。
糊弄贴法: “启动报错了,帮我看看” + 完整堆栈。
它当时给的方向是“检查某某注解有没有漏写”,我顺着翻了半天,注解没问题。
整理后的贴法: 先写明框架版本、这是一次依赖升级之后出现的、我已经确认相关 Bean 的注解还在;然后只贴异常类型 + 消息 + 进入我代码的两帧;最后问:“更可能是版本不兼容,还是配置问题?请先给判断依据,再给下一步排查。”
第二次它很快把注意力放到了版本变更上,让我去对升级说明里的 breaking change。一对,果然是某个自动配置条件变了。
同一次报错,差别几乎全在“我有没有先做那三件事”。
什么时候可以“偷懒”直接贴
我也不是每次都走完整流程。下面这些情况,我会允许自己快一点:
报错信息本身极短、极明确(比如某个命令行工具直接告诉你缺哪个参数)
我刚改过的就那几行,堆栈也正好指到那里
这是我熟悉的老问题,只是想确认一下修法有没有更新
反过来,下面这些情况,我几乎强制自己走三步:
堆栈很长,而且大部分在框架内部
只在某个环境出现
最近改动很多,说不清是哪一次引入的
涉及数据、权限、并发——猜错代价大
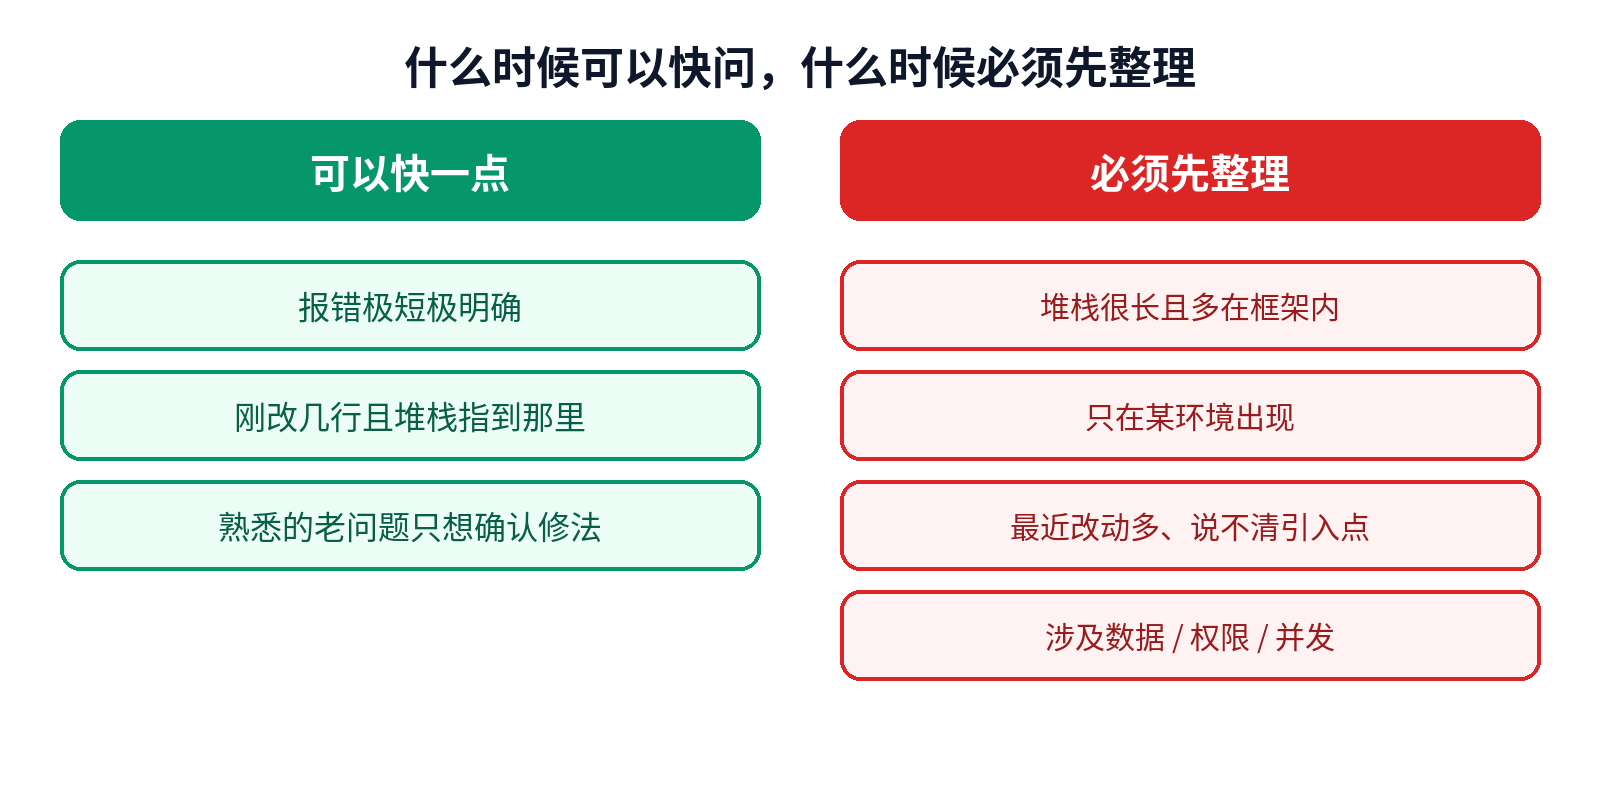
图:什么时候可以快问,什么时候必须先整理(原创示意图)
多问一句“你还需要什么信息”
养成整理习惯之后,我还会在问题末尾加一句:“如果信息不够,请先列出你还需要我补充什么,再开始给方案。”
这句话有两个好处。一是它会更老实地说“我需要看某某配置 / 某段代码”,而不是硬猜;二是逼我把排查变成对话,而不是一次性赌对。很多时候,真正修好问题的,是第二轮、第三轮补充之后,而不是第一轮那个看起来很完整的答案。
我怎么判断“已经够清楚了”
做完三件事,我还会快速过一遍自己的提问草稿,问自己:
一个完全不了解这个项目的人,只看我这段文字,能不能大致明白出了什么事?
我有没有把“现象”和“我的猜测”分开写?混在一起的时候,AI 很容易顺着我的猜测往下编。
有没有一句是情绪宣泄而不是信息?(比如“怎么又挂了”“上次也这样”)情绪可以有,但别占地方。
如果这三条里有两条过不去,我就再改两分钟。改完再发。这个习惯一开始有点拧巴,做多了就变成肌肉记忆了:不是追求完美提问,而是避免把半生不熟的问题丢出去,然后在错误的方向上越聊越远。
还有一点很现实:整理过的问题,即使最后没问 AI、自己也想明白了,那三分钟也值。因为整理的过程,本身就是在缩小问题空间。AI 加速的是搜索和联想,缩小空间这件事,还是得我先动手。
最后
把报错贴给 AI,本身没什么错。错的是把“粘贴”当成了思考的替代品。
我现在把那三件事当成一个很小的仪式:扫一眼、确认能复现、写清名片。仪式感谈不上,但节奏对了——先自己降低噪声,再让 AI 在干净的信号上帮我加速。 这样用下来,它更像一个靠谱的结对对象,而不是一个“我把锅甩给你”的垃圾桶。
如果你也经常觉得“AI 修 bug 不稳”,不妨先别急着换模型、换工具。试试在按下粘贴之前,给自己三分钟。这三分钟,往往比多问两轮更省时间。
 2026-10-14鱼鱼