
长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着

  created  by  鱼鱼 {{tag}}
创建于 2026年10月11日 09:42:09 最后修改于 2026年10月14日 18:32:11

我自己写的那个编程 Agent,最早只用来做一些小改动,十几轮对话就结束了,上下文从来不是问题。

后来我开始让它做跨很多文件的迁移,比如把一批旧接口的调用换成新接口。这种任务一跑就是几十轮:读文件、搜索、改代码、跑测试、看报错、再改。每一轮的工具输出都往上下文里堆,没多久就逼近了模型的上下文上限。

于是我做了第一版“压缩”:上下文超过某个阈值,就让模型把之前的历史总结成一段话,然后用这段总结替换掉原来的历史,继续往下跑。

听起来很合理,跑起来问题一大堆。这篇就讲讲我前后几次改动的过程,以及现在比较稳定的做法。都是在我自己这个 Agent 上摸索出来的经验,换个场景未必完全适用。

第一版压缩,丢了什么

第一版用的是自由发挥式的摘要,提示大概就是“请总结上面的对话,保留重要信息”。压缩之后,我观察到了几类很典型的问题。

忘了约束。 任务一开始我说过“不要修改对外暴露的公共接口”。压缩之后,这句话在摘要里变成了“用户希望进行接口迁移”,约束本身没了。后面它就动了一个公共接口的签名。

重复劳动。 摘要里写着“已经分析了相关文件”,但没写分析出了什么结论。于是压缩后它又把那几个文件重新读了一遍,白白浪费了一轮上下文。更糟的一次,是它把已经完成的一步又做了一遍。

细节被抹平。 有一次测试报错,原始信息里有具体的文件名、行号和断言内容,摘要里只剩一句“出现了一个类型相关的测试失败”。压缩后它只能去重跑测试,才能拿回这些信息。

把猜测写成了事实。 压缩前,它说过“这个问题可能是缓存没刷新导致的”,这只是一个待验证的假设。压缩之后,摘要里写的是“问题由缓存未刷新导致”。后面它就一直沿着这个方向走,走了好几轮才发现不对。

这几次之后我意识到:压缩不是“写一段好的摘要”,而是“替下一轮的自己决定它需要知道什么”。 这是两件不同的事。前者追求简洁通顺,后者追求的是:拿着这份东西,能不能无缝地接着干活。

先把上下文里的东西分分类

想清楚这一点后,我把上下文里的内容按“压缩时怎么处理”分成了四类。
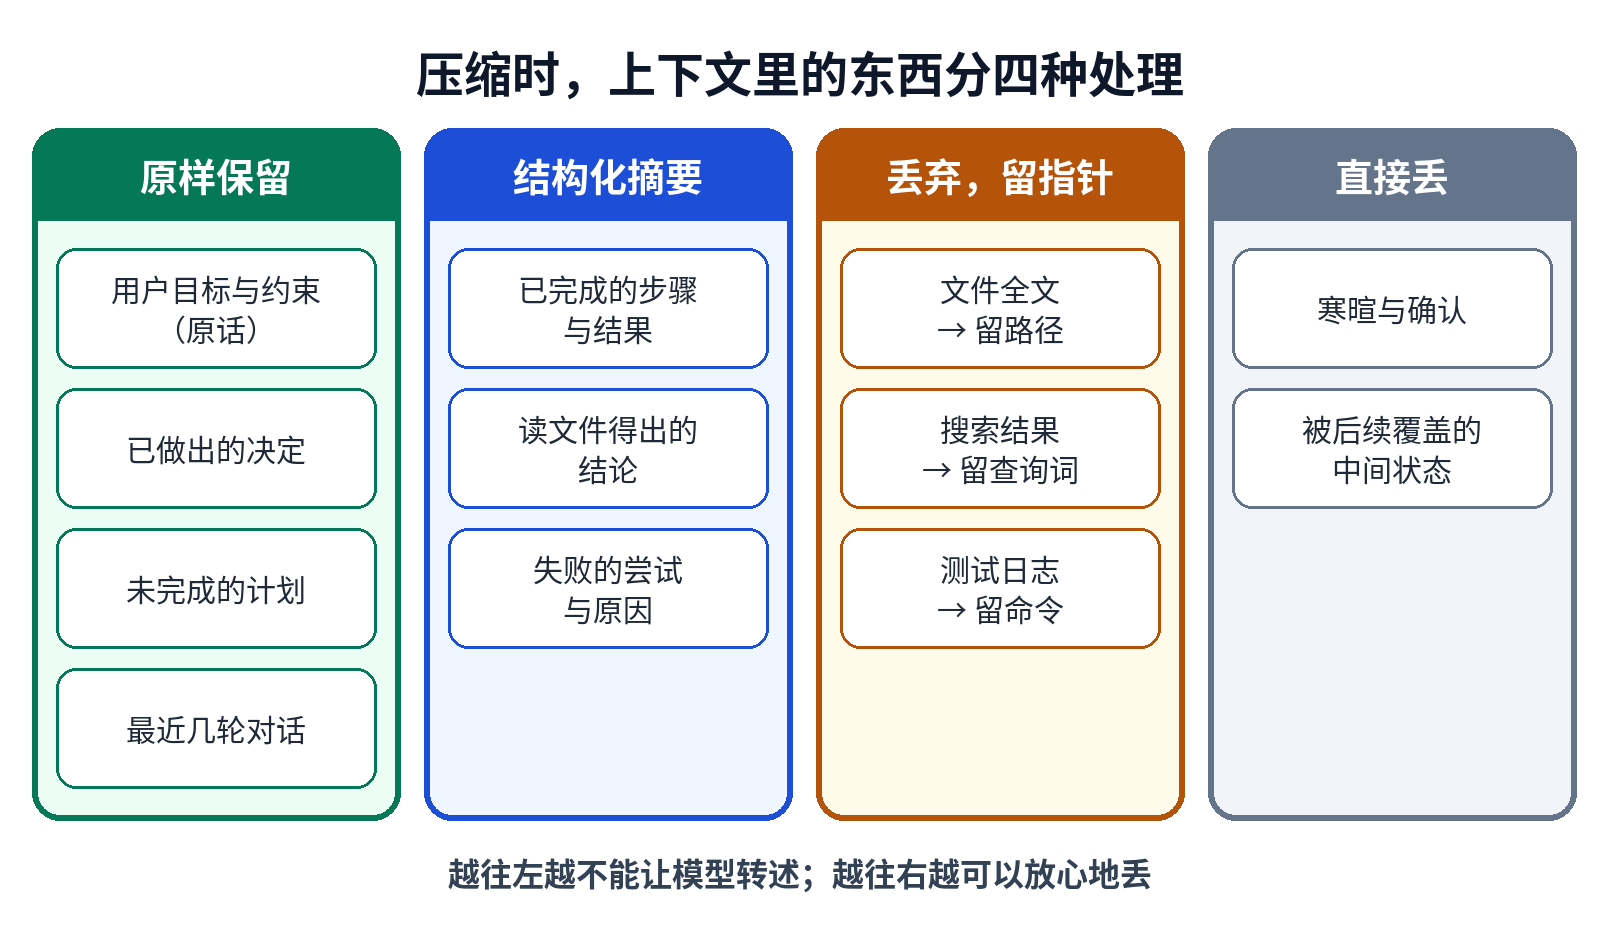
上下文内容的四种处理方式:原样保留、结构化摘要、丢弃但留指针、直接丢弃

图:上下文内容的四种处理方式:原样保留、结构化摘要、丢弃但留指针、直接丢弃(原创示意图)

第一类,必须原样保留。 用户最初的目标和所有明确的约束,用户的原话,不转述;已经做出的关键决定;当前还没完成的计划;最近几轮的完整对话。这些东西一旦被转述,就可能走样,而走样的代价很高。

第二类,可以结构化地摘要。 已经完成的步骤和结果、读过的文件得出的结论、失败过的尝试以及失败原因。这些需要保留“结论”,但不需要保留“过程”。

第三类,可以丢掉,但要留个指针。 大段的工具输出,比如文件全文、搜索结果、完整的测试日志。这些占的篇幅最大,而且大部分时候可以重新获取。丢掉它们,但要留下“怎么拿回来”的线索,比如文件路径、执行过的命令。

第四类,可以直接丢。 寒暄、重复的确认、已经被后续内容完全覆盖的中间状态。

分完类之后再看第一版的问题,原因就很清楚了:它把所有东西都扔进同一个摘要里,一视同仁地压缩,第一类的东西被转述走了样,第二类的结论被省略了,第三类又没留指针。

我现在的做法

第一步:先清旧的工具输出,再动对话

我后来发现,在我的场景里,上下文里大头其实是工具输出,而不是对话本身。所以现在压缩分两步走,第一步只做一件事:把比较早的工具输出替换成一行占位说明。

比如一个读文件的工具结果,原来是三百行代码,替换后变成:“已省略:读取了某个文件,共三百行,结论见摘要,需要时可重新读取。”工具调用本身的记录还在,只是结果被清掉了。

很多时候,光这一步就能腾出大量空间,根本不需要动后面的对话。而且这一步几乎不会丢失“理解”层面的信息,风险很小。

第二步:真要摘要,就用固定模板

如果清完工具输出还是不够,才进入第二步:生成摘要。但我不再让模型自由发挥,而是给它一个固定的模板,要求逐项填写:

## 目标(用户原话,不要改写)
## 约束(逐条列出,用户原话)
## 已做出的决定(及理由)
## 已完成的步骤(每步一句话 + 结果)
## 关键发现(标注:已验证 / 未验证的推测)
## 失败过的尝试(做了什么、为什么失败)
## 待办(按顺序)
## 未决问题

固定模板的好处是,它没办法“忘记”某一项,空着的项我一眼就能看出来。其中“已验证 / 未验证”这个标注,就是专门治“把猜测写成事实”的。

另外有一个细节:目标和约束这两项,我其实不让模型来写。 用户最初的消息我在程序里单独存了一份,压缩时直接原样塞回去,根本不经过模型的手。能不让模型转述的,就不让它转述。

第三步:让 Agent 自己记笔记

这是我觉得最有效的一个改动。我给 Agent 加了一个很简单的约定:在工作目录里维护一个进度笔记文件,每完成一个阶段就更新一下,内容和上面那个模板差不多。

这样一来,最可靠的状态就不在上下文里,而是在文件里。压缩之后,它重新读一下这个笔记,就知道自己做到哪了。比起压缩那一刻临时生成的摘要,这个笔记是在干活过程中一点点写下来的,信息更准,也更不容易遗漏。

而且这个笔记对我也有用:中途想看看它在干嘛,打开这个文件就知道了,不用去翻冗长的对话日志。

压缩后的上下文长什么样

把这几步串起来,现在的压缩流程大概是这样的:
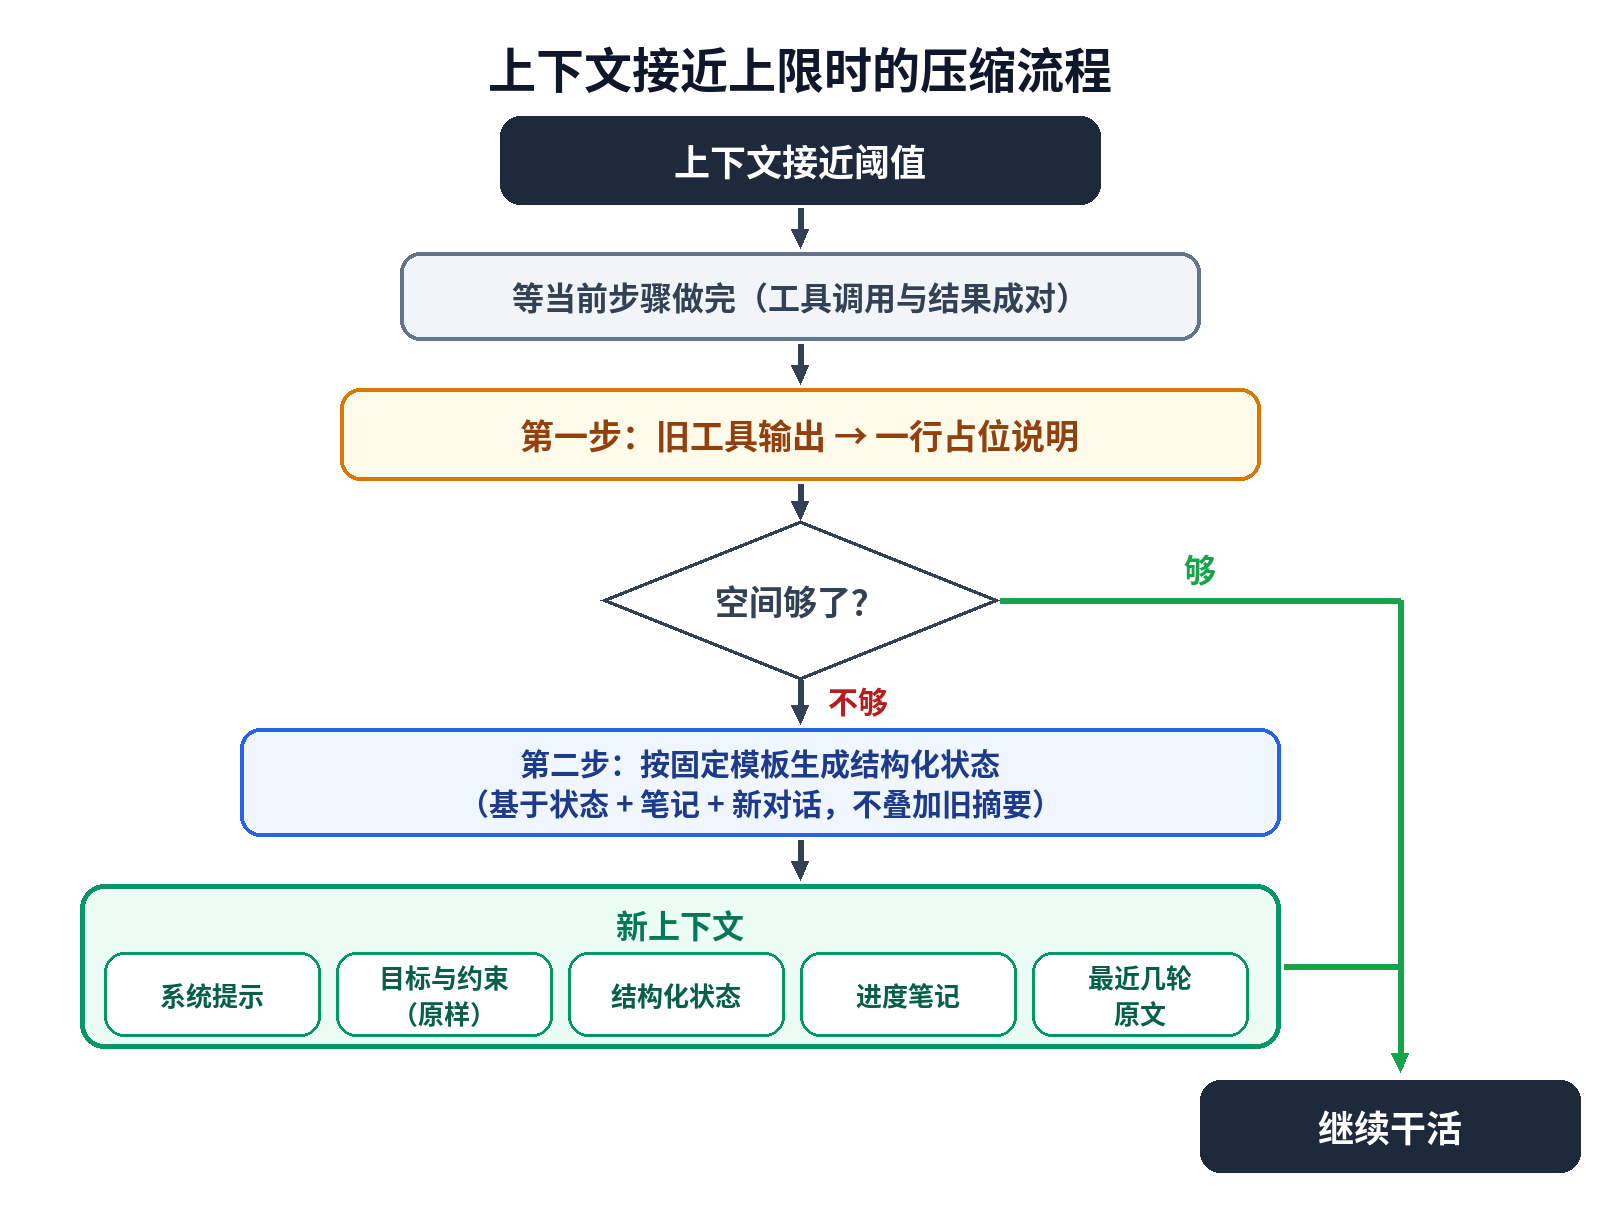
上下文接近上限时的压缩流程:先清工具输出,不够再在任务边界生成结构化状态

图:上下文接近上限时的压缩流程:先清工具输出,不够再在任务边界生成结构化状态(原创示意图)

压缩后的新上下文由几部分组成:系统提示、原样保留的用户目标和约束、结构化的状态摘要、进度笔记的内容,再加上最近几轮的完整对话。

几个后来才注意到的坑

摘要的摘要会漂移。 长任务里压缩可能发生好几次。如果每次都是在上一次的摘要基础上再总结,误差会一层层累积,几轮之后跟原始情况已经差得很远了。现在我每次压缩,都基于“结构化状态 + 进度笔记 + 新增的对话”重新生成,而不是在旧摘要上叠加。

压缩时机要选在任务边界。 我最早是到阈值就立刻压缩,有时候刚好卡在一次工具调用和它的结果中间。很多模型接口要求工具调用和工具结果成对出现,从中间截断,轻则请求报错,重则模型对“这次调用到底执行了没有”产生误解。现在我会等当前这一步做完,再压缩。

压缩会打碎前缀缓存。 压缩之后上下文的前半段变了,之前缓存的前缀就失效了,下一次请求要按全价重新算。所以压缩不宜太频繁。我的做法是阈值设得稍微高一点,真压的时候一次多腾出一些空间,而不是每次只压一点点、频繁地压。

别把“失败的尝试”当垃圾扔掉。 我一开始把失败的过程归到了“可以直接丢”那一类,结果压缩后它又去尝试了一遍同样走不通的路。现在失败的尝试单独作为一项保留,只保留“做了什么、为什么不行”,不保留过程。

怎么知道压缩做得好不好

最后说说我怎么检验压缩的质量。

一个很简单的办法是“探针提问”:在压缩前后,分别问它几个固定的问题,比如“用户给了哪些约束”“哪些文件已经改过”“下一步要做什么”“刚才那个测试失败的具体原因是什么”。压缩后的回答和压缩前对得上,说明关键信息保住了;对不上的那一项,就是模板或者保留规则需要补的地方。

另一个办法是在评估任务上做对比:同一组长任务,开不开压缩、用哪种压缩策略,分别跑一遍,比较完成率和中途“重复劳动”的次数。这个比较费时间,我只在大改压缩逻辑的时候做。

最后

回头看,我对上下文压缩的理解经历了一个转变:一开始把它当成一个“省空间”的技术问题,觉得摘要写得越短越好;后来才明白,它本质上是一个“交接”问题——就像你把手头的工作交接给一个完全没有参与过的同事,你得告诉他目标是什么、有哪些规矩、做到哪了、哪些路已经试过走不通、接下来该干嘛。

交接做得好,换个人也能接着干;交接做得不好,那个人只能从头摸索。对 Agent 来说,压缩之后的那个“它”,就是那个接手的同事。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着

长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着

我自己写的那个编程 Agent,最早只用来做一些小改动,十几轮对话就结束了,上下文从来不是问题。

后来我开始让它做跨很多文件的迁移,比如把一批旧接口的调用换成新接口。这种任务一跑就是几十轮:读文件、搜索、改代码、跑测试、看报错、再改。每一轮的工具输出都往上下文里堆,没多久就逼近了模型的上下文上限。

于是我做了第一版“压缩”:上下文超过某个阈值,就让模型把之前的历史总结成一段话,然后用这段总结替换掉原来的历史,继续往下跑。

听起来很合理,跑起来问题一大堆。这篇就讲讲我前后几次改动的过程,以及现在比较稳定的做法。都是在我自己这个 Agent 上摸索出来的经验,换个场景未必完全适用。

第一版压缩,丢了什么

第一版用的是自由发挥式的摘要,提示大概就是“请总结上面的对话,保留重要信息”。压缩之后,我观察到了几类很典型的问题。

忘了约束。 任务一开始我说过“不要修改对外暴露的公共接口”。压缩之后,这句话在摘要里变成了“用户希望进行接口迁移”,约束本身没了。后面它就动了一个公共接口的签名。

重复劳动。 摘要里写着“已经分析了相关文件”,但没写分析出了什么结论。于是压缩后它又把那几个文件重新读了一遍,白白浪费了一轮上下文。更糟的一次,是它把已经完成的一步又做了一遍。

细节被抹平。 有一次测试报错,原始信息里有具体的文件名、行号和断言内容,摘要里只剩一句“出现了一个类型相关的测试失败”。压缩后它只能去重跑测试,才能拿回这些信息。

把猜测写成了事实。 压缩前,它说过“这个问题可能是缓存没刷新导致的”,这只是一个待验证的假设。压缩之后,摘要里写的是“问题由缓存未刷新导致”。后面它就一直沿着这个方向走,走了好几轮才发现不对。

这几次之后我意识到:压缩不是“写一段好的摘要”,而是“替下一轮的自己决定它需要知道什么”。 这是两件不同的事。前者追求简洁通顺,后者追求的是:拿着这份东西,能不能无缝地接着干活。

先把上下文里的东西分分类

想清楚这一点后,我把上下文里的内容按“压缩时怎么处理”分成了四类。

上下文内容的四种处理方式:原样保留、结构化摘要、丢弃但留指针、直接丢弃

图:上下文内容的四种处理方式:原样保留、结构化摘要、丢弃但留指针、直接丢弃(原创示意图)

第一类,必须原样保留。 用户最初的目标和所有明确的约束,用户的原话,不转述;已经做出的关键决定;当前还没完成的计划;最近几轮的完整对话。这些东西一旦被转述,就可能走样,而走样的代价很高。

第二类,可以结构化地摘要。 已经完成的步骤和结果、读过的文件得出的结论、失败过的尝试以及失败原因。这些需要保留“结论”,但不需要保留“过程”。

第三类,可以丢掉,但要留个指针。 大段的工具输出,比如文件全文、搜索结果、完整的测试日志。这些占的篇幅最大,而且大部分时候可以重新获取。丢掉它们,但要留下“怎么拿回来”的线索,比如文件路径、执行过的命令。

第四类,可以直接丢。 寒暄、重复的确认、已经被后续内容完全覆盖的中间状态。

分完类之后再看第一版的问题,原因就很清楚了:它把所有东西都扔进同一个摘要里,一视同仁地压缩,第一类的东西被转述走了样,第二类的结论被省略了,第三类又没留指针。

我现在的做法

第一步:先清旧的工具输出,再动对话

我后来发现,在我的场景里,上下文里大头其实是工具输出,而不是对话本身。所以现在压缩分两步走,第一步只做一件事:把比较早的工具输出替换成一行占位说明。

比如一个读文件的工具结果,原来是三百行代码,替换后变成:“已省略:读取了某个文件,共三百行,结论见摘要,需要时可重新读取。”工具调用本身的记录还在,只是结果被清掉了。

很多时候,光这一步就能腾出大量空间,根本不需要动后面的对话。而且这一步几乎不会丢失“理解”层面的信息,风险很小。

第二步:真要摘要,就用固定模板

如果清完工具输出还是不够,才进入第二步:生成摘要。但我不再让模型自由发挥,而是给它一个固定的模板,要求逐项填写:

## 目标(用户原话,不要改写)
## 约束(逐条列出,用户原话)
## 已做出的决定(及理由)
## 已完成的步骤(每步一句话 + 结果)
## 关键发现(标注:已验证 / 未验证的推测)
## 失败过的尝试(做了什么、为什么失败)
## 待办(按顺序)
## 未决问题

固定模板的好处是,它没办法“忘记”某一项,空着的项我一眼就能看出来。其中“已验证 / 未验证”这个标注,就是专门治“把猜测写成事实”的。

另外有一个细节:目标和约束这两项,我其实不让模型来写。 用户最初的消息我在程序里单独存了一份,压缩时直接原样塞回去,根本不经过模型的手。能不让模型转述的,就不让它转述。

第三步:让 Agent 自己记笔记

这是我觉得最有效的一个改动。我给 Agent 加了一个很简单的约定:在工作目录里维护一个进度笔记文件,每完成一个阶段就更新一下,内容和上面那个模板差不多。

这样一来,最可靠的状态就不在上下文里,而是在文件里。压缩之后,它重新读一下这个笔记,就知道自己做到哪了。比起压缩那一刻临时生成的摘要,这个笔记是在干活过程中一点点写下来的,信息更准,也更不容易遗漏。

而且这个笔记对我也有用:中途想看看它在干嘛,打开这个文件就知道了,不用去翻冗长的对话日志。

压缩后的上下文长什么样

把这几步串起来,现在的压缩流程大概是这样的:

上下文接近上限时的压缩流程:先清工具输出,不够再在任务边界生成结构化状态

图:上下文接近上限时的压缩流程:先清工具输出,不够再在任务边界生成结构化状态(原创示意图)

压缩后的新上下文由几部分组成:系统提示、原样保留的用户目标和约束、结构化的状态摘要、进度笔记的内容,再加上最近几轮的完整对话。

几个后来才注意到的坑

摘要的摘要会漂移。 长任务里压缩可能发生好几次。如果每次都是在上一次的摘要基础上再总结,误差会一层层累积,几轮之后跟原始情况已经差得很远了。现在我每次压缩,都基于“结构化状态 + 进度笔记 + 新增的对话”重新生成,而不是在旧摘要上叠加。

压缩时机要选在任务边界。 我最早是到阈值就立刻压缩,有时候刚好卡在一次工具调用和它的结果中间。很多模型接口要求工具调用和工具结果成对出现,从中间截断,轻则请求报错,重则模型对“这次调用到底执行了没有”产生误解。现在我会等当前这一步做完,再压缩。

压缩会打碎前缀缓存。 压缩之后上下文的前半段变了,之前缓存的前缀就失效了,下一次请求要按全价重新算。所以压缩不宜太频繁。我的做法是阈值设得稍微高一点,真压的时候一次多腾出一些空间,而不是每次只压一点点、频繁地压。

别把“失败的尝试”当垃圾扔掉。 我一开始把失败的过程归到了“可以直接丢”那一类,结果压缩后它又去尝试了一遍同样走不通的路。现在失败的尝试单独作为一项保留,只保留“做了什么、为什么不行”,不保留过程。

怎么知道压缩做得好不好

最后说说我怎么检验压缩的质量。

一个很简单的办法是“探针提问”:在压缩前后,分别问它几个固定的问题,比如“用户给了哪些约束”“哪些文件已经改过”“下一步要做什么”“刚才那个测试失败的具体原因是什么”。压缩后的回答和压缩前对得上,说明关键信息保住了;对不上的那一项,就是模板或者保留规则需要补的地方。

另一个办法是在评估任务上做对比:同一组长任务,开不开压缩、用哪种压缩策略,分别跑一遍,比较完成率和中途“重复劳动”的次数。这个比较费时间,我只在大改压缩逻辑的时候做。

最后

回头看,我对上下文压缩的理解经历了一个转变:一开始把它当成一个“省空间”的技术问题,觉得摘要写得越短越好;后来才明白,它本质上是一个“交接”问题——就像你把手头的工作交接给一个完全没有参与过的同事,你得告诉他目标是什么、有哪些规矩、做到哪了、哪些路已经试过走不通、接下来该干嘛。

交接做得好,换个人也能接着干;交接做得不好,那个人只能从头摸索。对 Agent 来说,压缩之后的那个“它”,就是那个接手的同事。


长任务 Agent 的上下文压缩:摘要什么、丢什么、什么必须原样留着2026-10-14鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论