

先说一次让我印象很深的翻车。
我维护着一个内部用的小 Agent,帮同事查工单、查日志、整理排查结论。有段时间有人反馈它“太啰嗦”,每次回答都要铺垫好几段。我就去后台的配置里,在系统提示词末尾加了一句:“回答尽量简洁。”
改完自己试了两个问题,回答确实短了,挺满意,就没再管。
过了几天,陆续有同事说它“变笨了”:以前问它某个工单的状态,它会先调用查询工具,再基于查到的结果回答;现在它经常不查,直接根据对话里的只言片语给个结论。还有一个多步骤的排查任务,它以前会一步步来,现在倾向于一步跳到结论。
我一开始完全没往那句“尽量简洁”上想,在日志里找了半天别的原因。更尴尬的是,我想看看“几天前的提示词长什么样”,发现做不到——提示词存在配置后台,直接在线改,改完就覆盖了,没有历史。
最后是靠记忆一点点回想,才怀疑到那句话头上。删掉之后,它的行为基本恢复了。后来我想,它大概是把“简洁”理解成了“少做事”,连工具调用这种“过程”也一起省了。这只是我的推测,但改动和现象的对应关系是很明确的。
这次之后,我开始认真对待提示词的变更。下面是我现在的做法,不复杂,但每一条都是踩过坑才加上的。
第一条:提示词就是代码
最根本的一点:提示词要放进代码仓库,走和代码一样的流程。 改动要提交、要有人看、要能追溯,不能再在后台直接在线改了。
但这里有个容易忽略的地方:影响 Agent 行为的,远不止那段系统提示词。
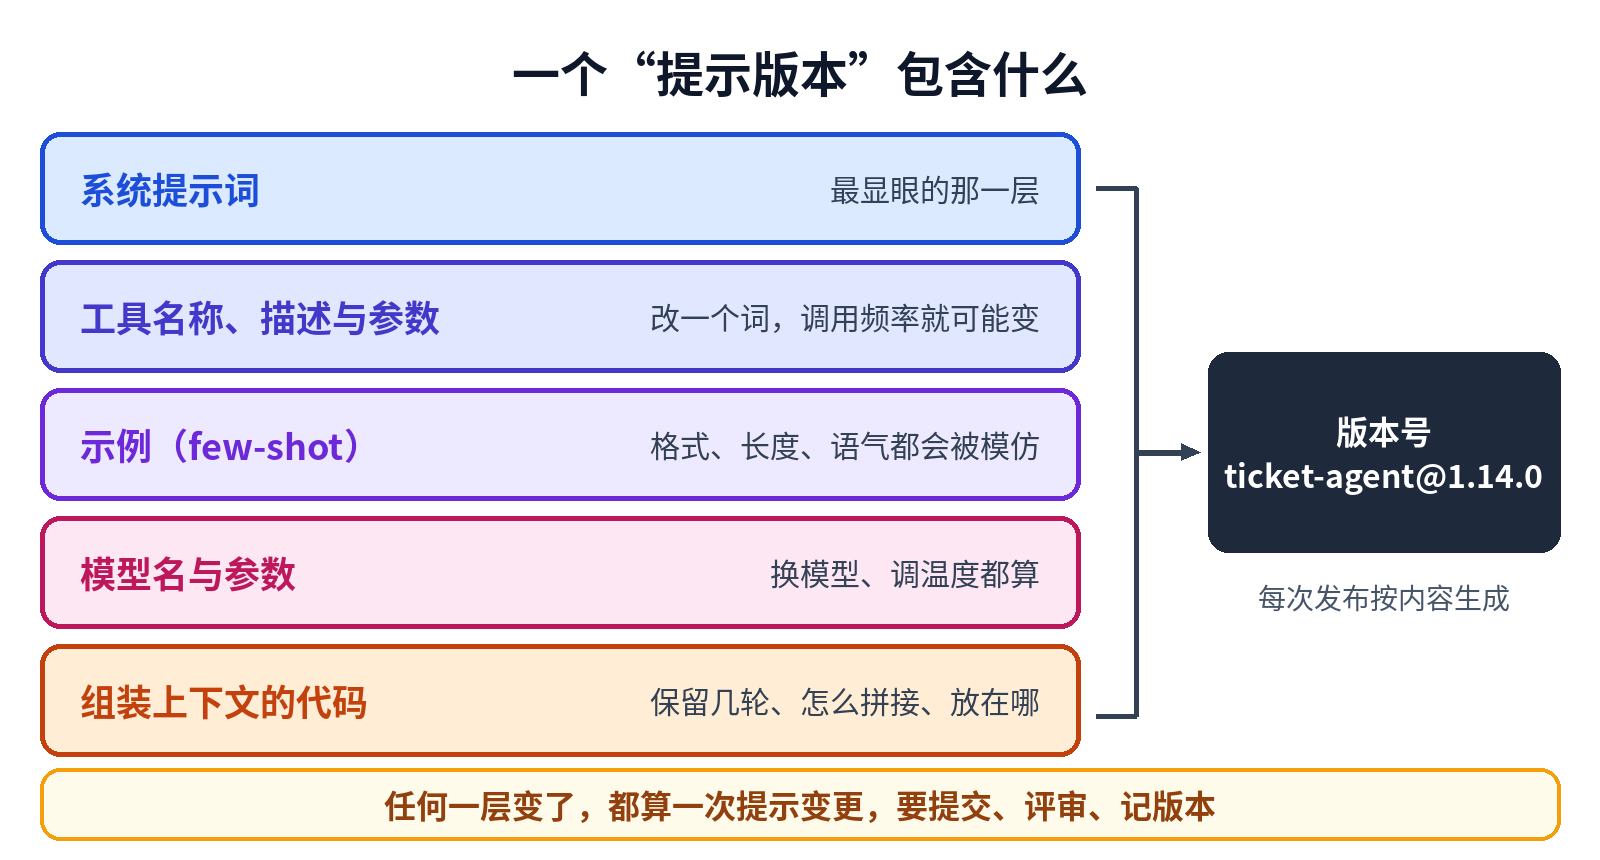
图:一个“提示版本”包含哪些东西:任何一层改动都会改变 Agent 的行为(原创示意图)
我现在把下面这些都算作“提示版本”的一部分:
系统提示词本身。
工具的名称、描述和参数说明。 模型选不选某个工具,很大程度上取决于工具描述怎么写。我遇到过改了工具描述里的一个词,它调用这个工具的频率就明显变了。
示例(few-shot)。 模型对示例的模仿能力很强,有时候强到过分。示例里的格式、长度、语气,都会被它学过去。
模型名称和参数。 同一份提示词,换一个模型、调一下温度,行为可能就不一样了。
组装上下文的代码。 比如历史消息保留几轮、检索结果放在哪里、按什么顺序拼接。这部分写在代码里,但它决定了模型最终看到的是什么。
这些东西任何一样变了,我都当成一次提示变更来对待。我的做法是把它们放在仓库里的同一个目录下,每次发布时根据这些内容生成一个版本号。
第二条:每次调用都记下版本号
光有版本还不够,得能把“某次具体的对话”和“它用的是哪个版本”对上。
我现在在每次调用模型的日志里,都会带上这个版本号,大概长这样:
{"trace_id": "t-20261011-0042", "prompt_version": "ticket-agent@1.14.0", "model": "<模型名>", "tool_calls": 3, "output_tokens": 412}
有了这个字段,再有人反馈“它最近变笨了”,我第一件事就是看:出问题的对话用的是哪个版本?这个版本和上一个版本比,改了什么?很多时候问题直接就定位到了。
第三条:一次只改一件事,写清楚为什么改
这条听起来像废话,但我真的吃过“一次改好几处”的亏:同时改了提示词里的两段话和一个工具描述,结果效果变差了,不知道是哪一处导致的,只能一处处回退去试。
现在我要求自己:一次提交只改一处意图。 提交信息里写清楚三件事:为什么改(解决什么问题)、改了什么、预期它的行为会怎么变。
“预期行为会怎么变”这一条特别有用。写下来之后,上线后我就有了对照:它的变化是不是我预期的那样?有没有出现预期之外的变化?那次“尽量简洁”如果当时写了预期,我大概会写“回答变短”,而不会写“少调用工具”,那后者一出现,我就知道是意外。
第四条:上线前跑一遍回归
改完提示词,我以前的验证方式是:自己随手问两三个问题,看着不错就上线。现在回头看,这种验证几乎没有意义,那次翻车就是这么来的。
现在我维护了一小组固定的任务,每次改提示词都拿新旧两个版本各跑一遍,对比结果。怎么搭这组任务,前段时间写过一篇讲评估集的文章,这里不展开。这里只说一点:除了看最终答案对不对,我更看重一些“行为指标”。
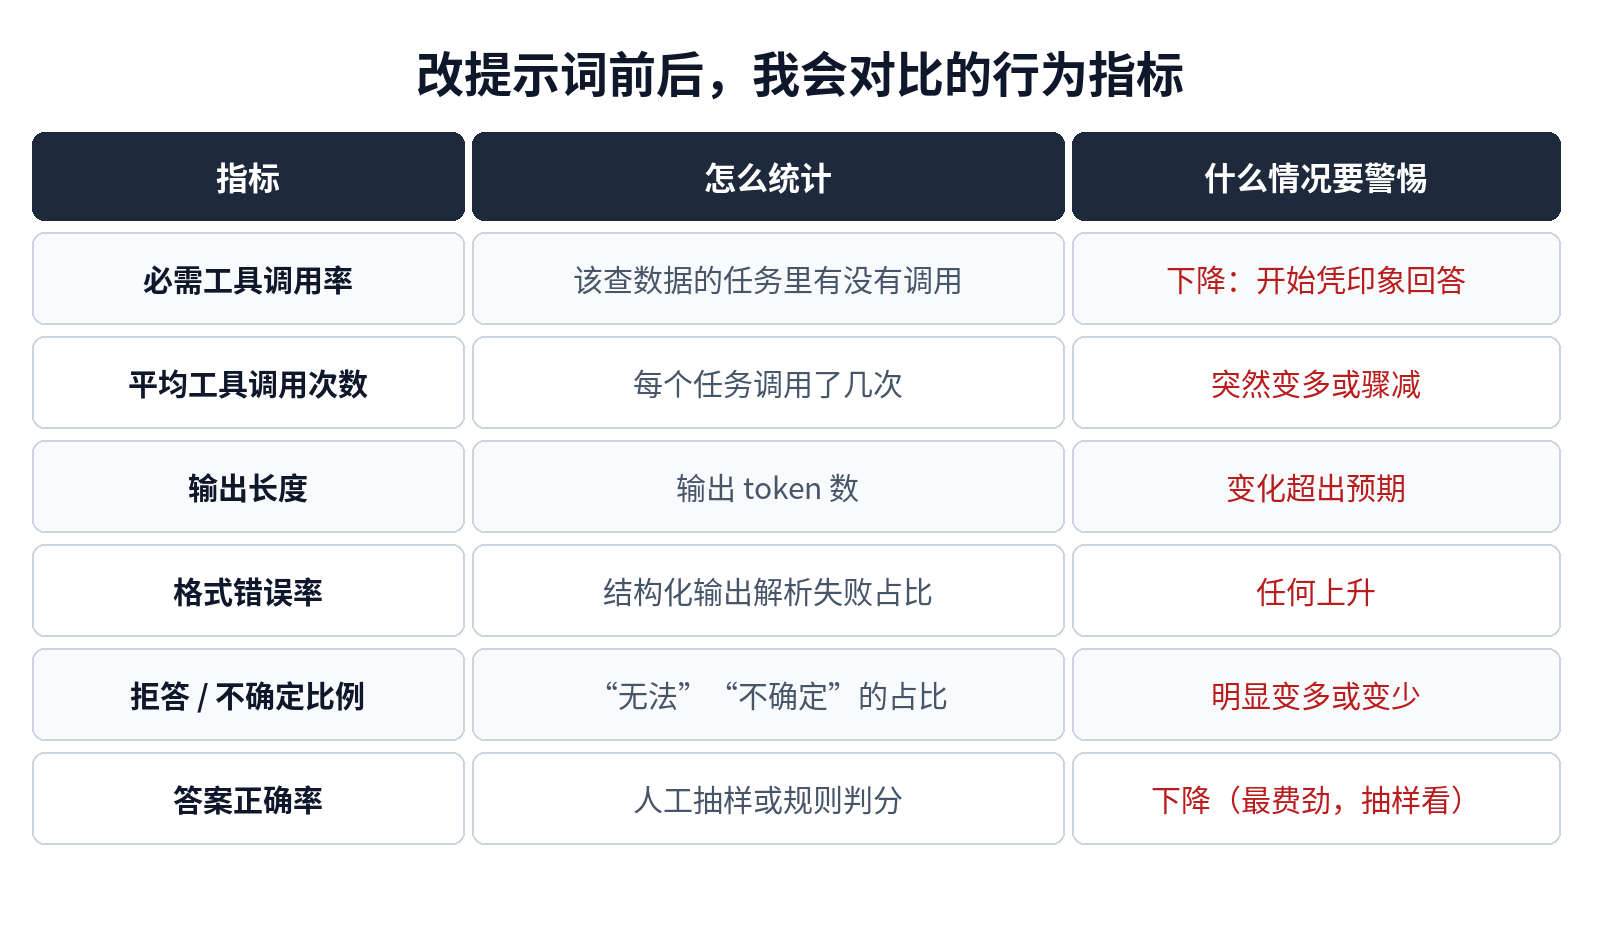
图:改提示词前后,我会对比的几项行为指标(原创示意图)
比如:
该调用的工具有没有调用。 这是那次翻车给我的教训,也是我现在最先看的。
平均工具调用次数。 突然变多或变少都值得注意。
输出长度。 变化幅度是否符合预期。
格式错误率。 需要结构化输出的地方,有没有开始出错。
拒答或“我不确定”的比例。 改完之后它是变得更谨慎了,还是更敢说了?
最终答案的对错往往需要人来判断,比较费劲;但这些行为指标可以自动统计,跑完一眼就能看出新版本有没有“变了个样”。
第五条:能灰度,能一键回滚
就算回归跑过了,我也不再一次性全量上线。我的做法是让配置里只存一个“当前使用哪个版本”的指针,而提示词的每个版本都完整地保留着。
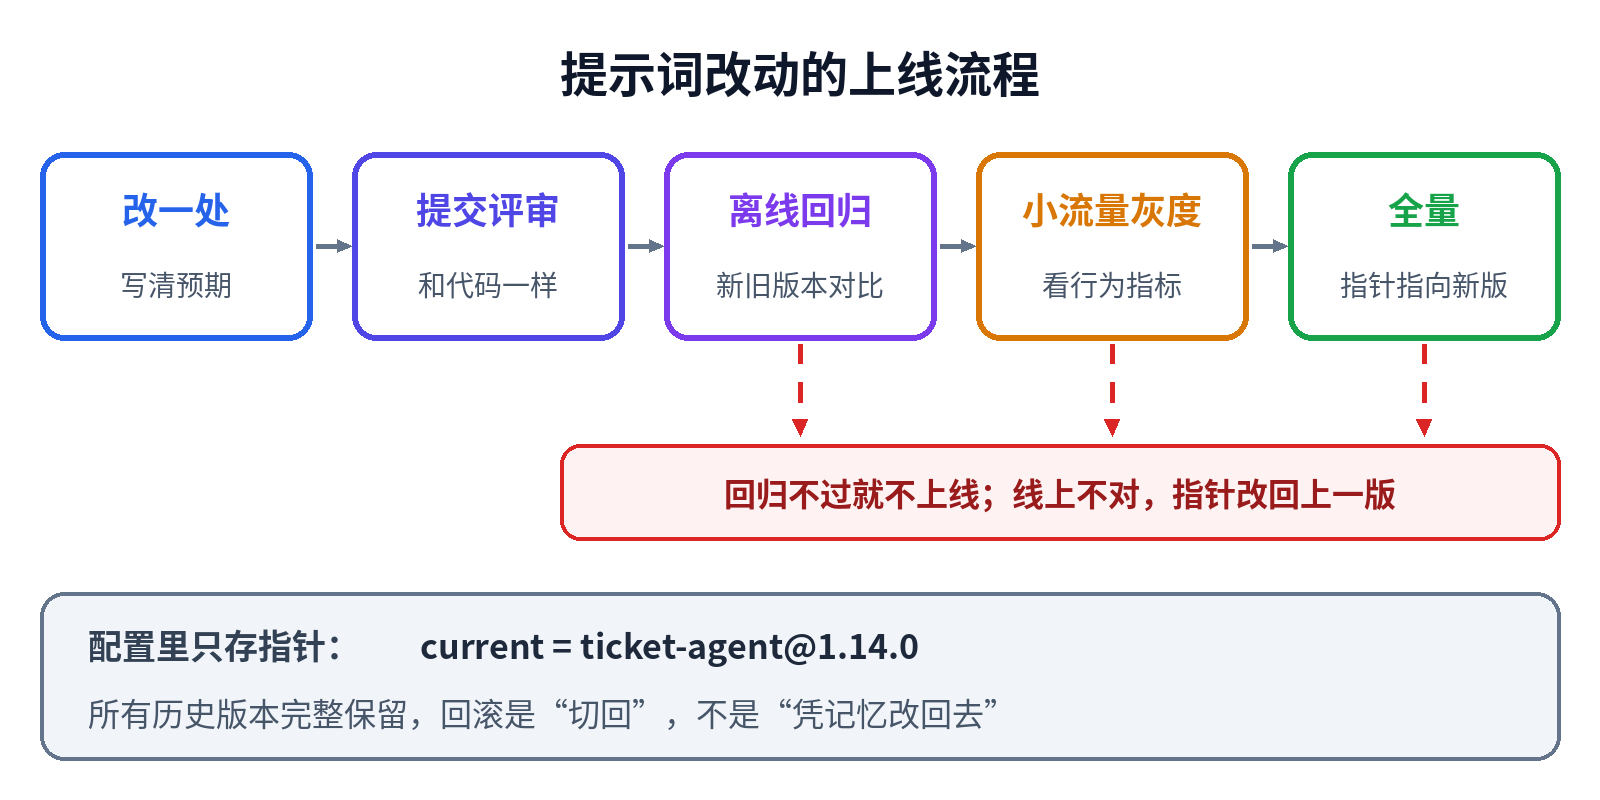
图:提示词改动从提交到全量上线的流程:任何一步不对都能退回上一个版本(原创示意图)
上线时先让一小部分请求用新版本,观察一段时间日志里的行为指标,没问题再逐步放大。出了问题,把指针改回上一个版本就行,几秒钟的事。这和以前“在后台把文字改回去”完全不一样:以前要靠记忆还原,还原得对不对都不知道;现在是确定地回到一个验证过的状态。
还有几个小坑
换模型,等于一次大版本的提示变更。 很多人觉得换个更新、更强的模型,效果只会更好。但同一份提示词在不同模型上的行为可能差别很大。新模型更“听话”的话,以前为了纠正老模型而写的那些强调语句,可能会被它过度执行。换模型之前,我会把它当成一次大改动,完整跑一遍回归。
“不要做某事”有时会适得其反。 我在提示词里写过“不要在回答中提到内部系统的名称”,结果它偶尔会说“出于规定,我不能提到某某系统”,反而把名字带出来了。这种情况用正面描述效果更好,比如直接告诉它对外应该怎么称呼。这只是我在自己的场景里观察到的,不一定普遍。
别往提示词里塞每次都会变的东西。 比如当前时间、请求编号。这类内容一方面会让每次请求的提示都不一样,影响前缀缓存的命中;另一方面,如果版本号是根据提示内容生成的,它也会跟着乱变。动态内容应该放在消息里,而不是写进提示模板。
最后
那次翻车之前,我一直把提示词当成“一段说明文字”,觉得随手改改没什么。后来才意识到,在 Agent 里,提示词其实是程序的一部分,而且是没有编译器帮你检查的那部分。 一句话的改动,可能让整个 Agent 的行为模式都变掉,而且不会有任何报错。
正因为没有编译器,才更需要版本、日志、回归和回滚这些工程手段来兜底。这些做法本身一点都不新鲜,就是我们平时管代码的那一套。只是在提示词这件事上,我花了一次翻车才想明白要把它们用上。
 2026-10-14鱼鱼