

我们组有个内部服务,一直跑在 Spring Boot 2 上。2.x 早就停止开源免费维护了,安全扫描隔三岔五报一堆依赖漏洞,升级这件事拖了很久,终于排到了我头上。
这次我决定全程拉着 AI 一起干。前后大概用了一周多(中间还穿插着别的需求),最后顺利上线。回头看,AI 确实帮我扛了大部分体力活,但也有几个坑是它挖的,或者至少是它没提醒我的。这篇把过程和教训记下来,给同样准备升级的同学参考。
先声明:下面说的都是我们这个项目的情况,每个项目的依赖和历史包袱不一样,具体以 Spring 官方的迁移指南为准。
先把路线定下来,别一步到位
一开始我问 AI:“把这个项目从 Spring Boot 2 升到 3,需要改什么?”它给了一份清单,大方向没错:Java 版本要 17 以上、javax 包要换成 jakarta、Spring Security 的配置写法变了,等等。
但如果照着这份清单一口气全改,那就是一个巨大的 diff,出了问题根本不知道是哪一步引起的。所以我最后定的路线是拆成几段走,每一段都能单独编译、单独跑测试:
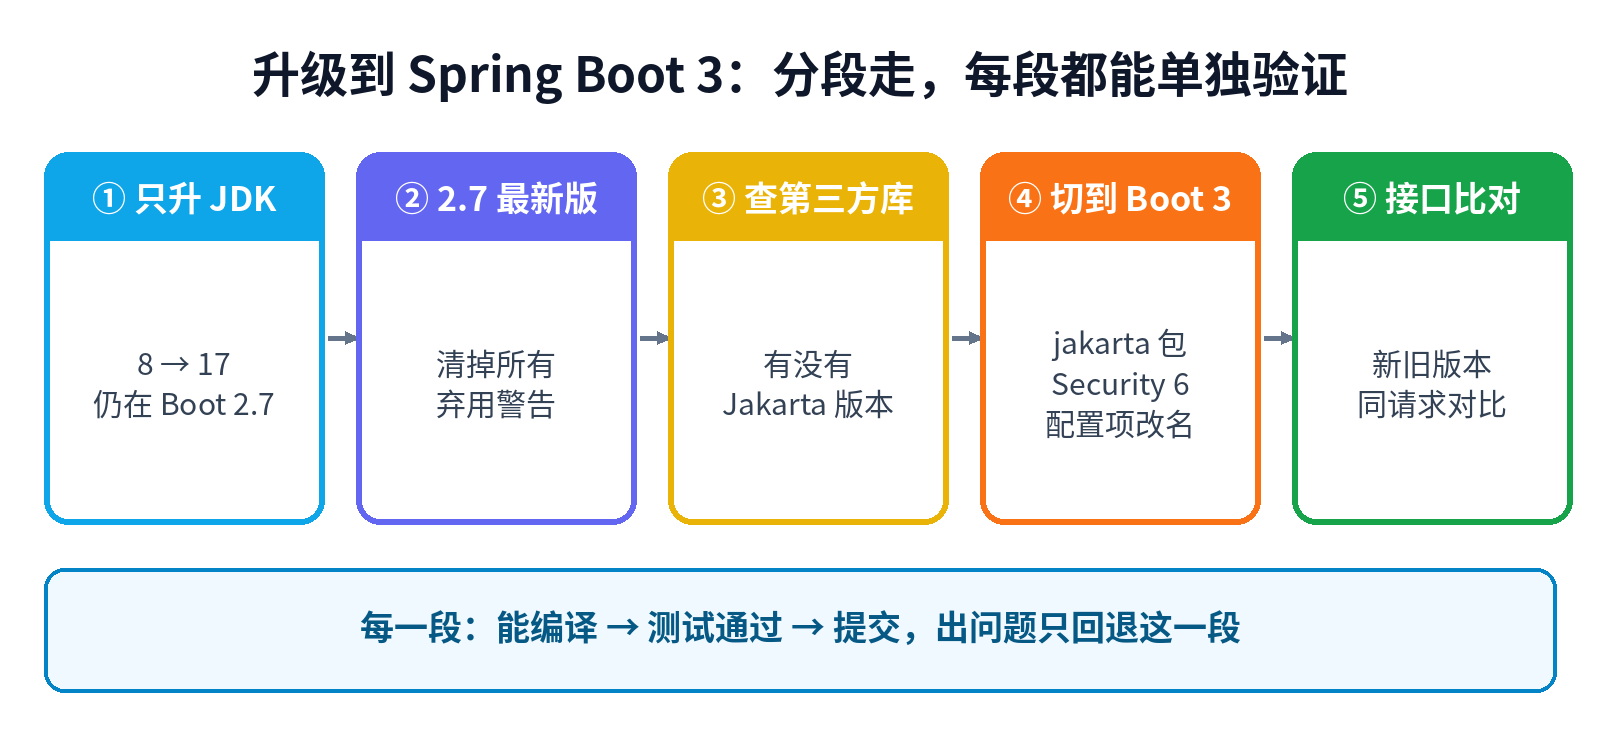
图:升级到 Spring Boot 3 的分段路线:每一段都能单独编译和测试(原创示意图)
第一段,只升 JDK。 我们原来跑在 Java 8 上。Spring Boot 2.7 本身就能跑在 Java 17 上,所以先在 2.7 上把 JDK 升到 17,解决掉那些和框架无关的问题,比如某些老工具对新 JDK 的兼容性。
第二段,升到 2.7 的最新小版本,清理掉所有弃用警告。 这也是官方迁移指南推荐的做法。很多在 3.0 里被删掉的东西,在 2.7 里已经标了弃用,先在老版本里把它们换掉,压力会小很多。
第三段,排查第三方依赖。 逐个确认我们用到的第三方库有没有支持 Jakarta 的版本。这一步很枯燥,但很重要,后面会说为什么。
第四段,才真正切到 Boot 3。
这个路线不是 AI 给我的,是我自己定的。AI 给的清单是“要改哪些东西”,但“按什么顺序、分几步改”,它没有主动提。我觉得这是用 AI 做大改动时最容易忽略的一点:它擅长回答“做什么”,但“怎么拆”往往得你自己来。
AI 真正帮上忙的地方
先说好的部分,这部分确实让我省了大量时间。
一是找全受影响的地方。 我让它帮我列出项目里所有用到 javax 包的文件、所有自定义的安全配置类、所有用到某些已弃用 API 的地方。它结合搜索结果给我分好类,我照着清单一个个处理,不容易漏。
二是批量的机械修改。 import 替换、注解替换、一些固定模式的写法调整,它做得又快又准。
三是翻译老配置。 我们的 Spring Security 配置是继承 WebSecurityConfigurerAdapter 写的,这个类在 Spring Security 6 里已经被删掉了,要改成注册一个 SecurityFilterChain 的 Bean。我把老配置贴给它,它很快翻译成了新写法,大致是这样:
@Bean
SecurityFilterChain filterChain(HttpSecurity http) throws Exception {
    http.authorizeHttpRequests(auth -> auth
            .requestMatchers("/actuator/health", "/public/**").permitAll()
            .anyRequest().authenticated())
        .httpBasic(Customizer.withDefaults());
    return http.build();
}
四是解释报错。 升级过程中编译错误和启动报错一波接一波,把报错贴给它,它基本都能说清楚原因。这种场景下它比我自己翻文档快得多。
它挖的,或者没提醒我的坑
坑一:旧写法和新写法混着来
AI 学过的代码里,Spring Security 5 时代的写法远比 6 的多。所以它时不时会“串台”:上一段代码还是新的 SecurityFilterChain,下一段又冒出 antMatchers——这个方法在 6.0 里已经被删了,要换成 requestMatchers。还有一次,我问一个小问题,它的回答里又建议我“继承 WebSecurityConfigurerAdapter”。
好在这类问题基本都是编译期就能暴露的,不算危险,但很烦。后来我在每次提问时都加上一句“项目是 Spring Boot 3、Spring Security 6,不要用已经删除的 API”,情况好了很多。
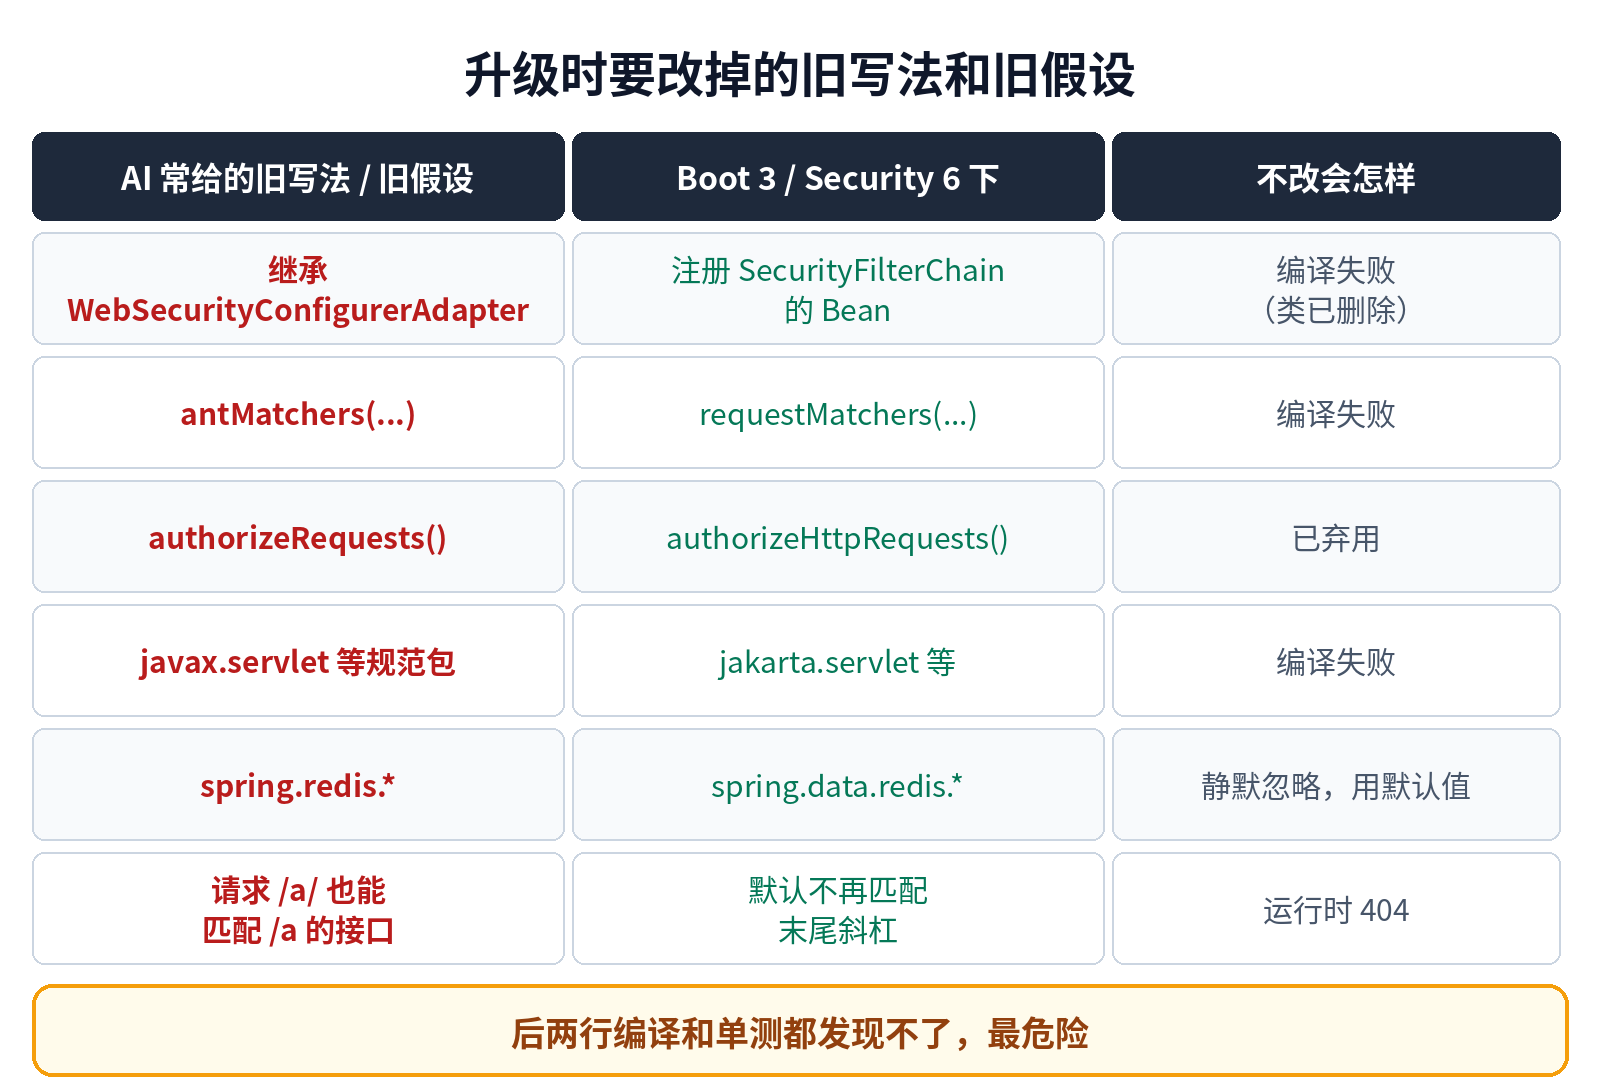
图:AI 常给出的旧写法与 Spring Boot 3 下对应的新写法(原创示意图)
坑二:一把梭的 javax 替换
它给了我一个批量替换的脚本,把所有 javax. 开头的 import 换成 jakarta.。我差点就直接跑了。
问题是,不是所有 javax 包都要换。 只有原来属于 Java EE 规范的那部分,比如 servlet、persistence、validation 这些,才迁到了 jakarta 命名空间。而 javax.sql、javax.crypto 这类是 JDK 自带的,一个字都不能动。最隐蔽的是 javax.transaction:里面的 Transactional 注解要换,但 javax.transaction.xa 是 JDK 自带的,要留着。
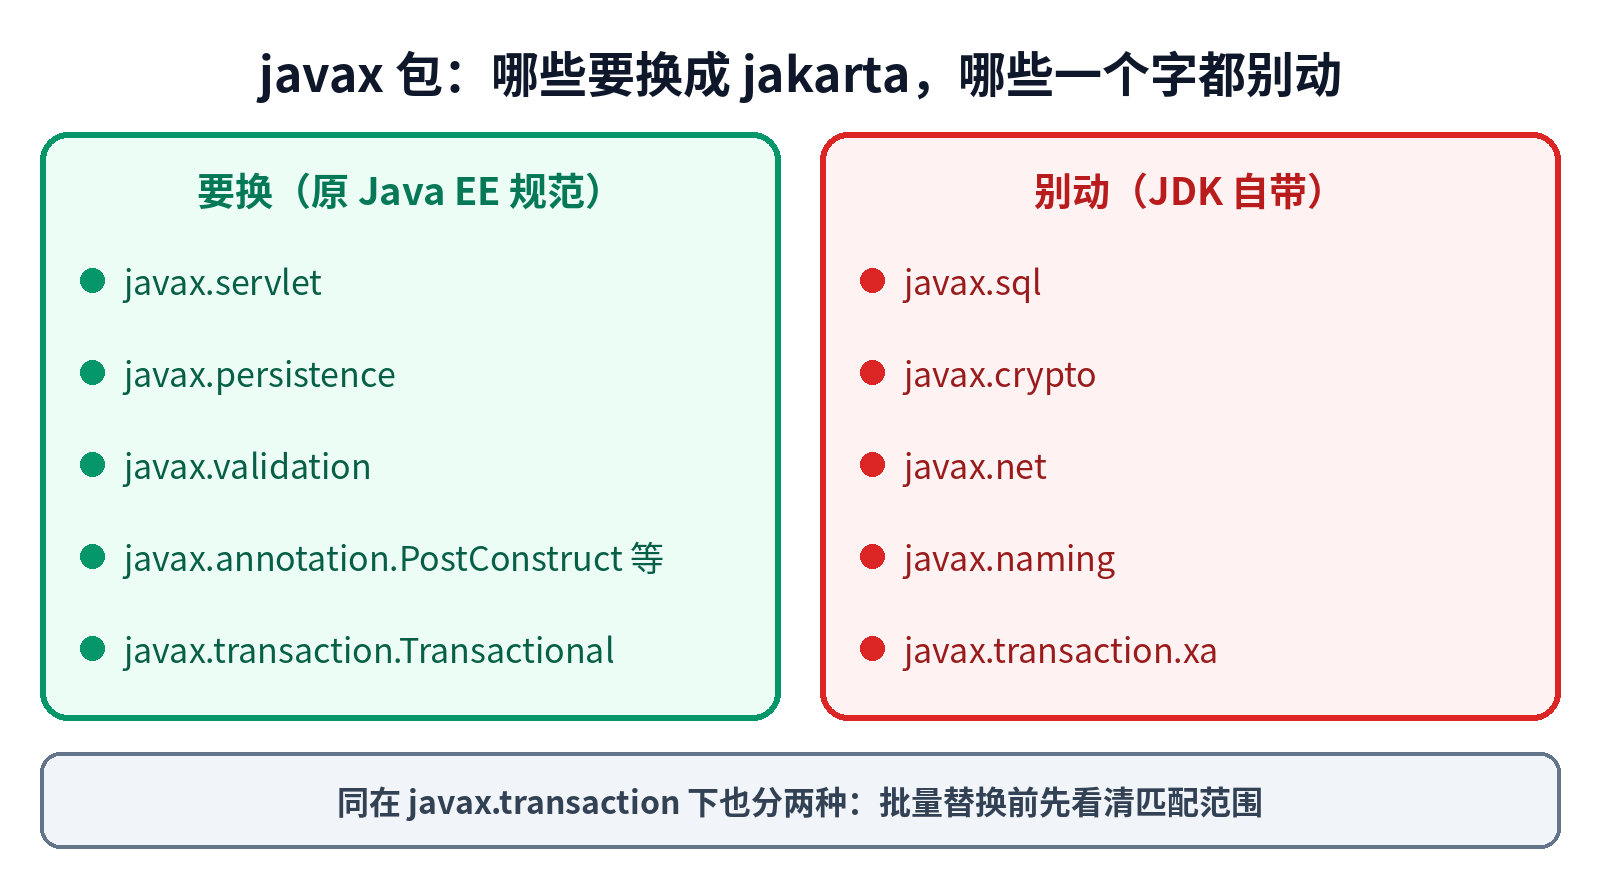
图:javax 包里哪些要换成 jakarta、哪些是 JDK 自带不能动(原创示意图)
这个坑也会在编译时暴露,代价不大。但它让我意识到:AI 给的批量操作,执行前一定要先看一眼它的匹配范围。
坑三:配置项改名,程序不报错
这个就危险多了。Boot 3 里有一批配置项改了名字,比如 Redis 相关的配置前缀从 spring.redis 变成了 spring.data.redis。我让 AI 帮我检查配置文件时,它没提这一点,给我的示例里用的还是旧前缀。
旧的配置键不会报错,只是被默默忽略,然后用默认值。在本地开发环境里,默认值刚好能连上本机的 Redis,一切正常;到了测试环境,才发现连不上。
后来我知道了官方提供的 spring-boot-properties-migrator:在依赖里临时加上它,启动时会把改了名的配置项都报出来。早知道这个,能少走不少弯路。这件事给我的教训是:AI 不提,不等于没有,官方的迁移工具和迁移指南要自己去看。
坑四:
这是整个升级里最隐蔽的一个,AI 从头到尾没提过。
Spring Framework 6 默认不再做末尾斜杠匹配。以前 /api/orders/ 能匹配到 /api/orders 的接口,升级后直接 404。我们有个老调用方,请求地址恰好带了末尾斜杠。编译不报错,单元测试也测不到,最后是在测试环境做接口回归时发现的。
修法有好几种,我们选的是让调用方改地址,同时在网关层观察了一段时间有没有别的漏网之鱼。
坑五:给老库“打补丁”
有一个很老的第三方库,内部依赖了 javax.servlet,没有 Jakarta 的版本。AI 给我的建议是:把 javax.servlet-api 作为依赖加回来,让它能编译通过。
这确实能编译通过,但 Boot 3 内嵌的jakarta.servlet,那个库里实现的 javax.servlet.Filter 在运行时根本不会被当成过滤器。这种问题,编译期完全看不出来。最后我们是把那个库换掉了。这也是为什么前面要专门留一段时间排查第三方依赖。
怎么确认没改坏
前面几个坑里,最危险的都是“编译通过、单测通过、上了环境才出问题”的那种。所以切到 Boot 3 之后,我专门花了一天做接口层面的比对。
做法很土:从测试环境的访问日志里挑出一批有代表性的请求,覆盖主要接口和几种常见参数组合。然后让老版本和新版本的服务各部署一份,把同样的请求分别打过去,比较两边的状态码和响应体。比对脚本是 AI 帮我写的,这种一次性的小工具它写得又快又好,我只需要告诉它哪些字段(比如时间戳、请求编号)每次都会变,比对时要忽略。
第一轮比对就抓出了末尾斜杠那个问题。另外还有几处差异,我逐个看过,都是我们这次顺手做的、预期之内的改动。没有这一步,我心里其实是没底的。
这件事也让我想明白一点:AI 让“改代码”变便宜了,但“确认改对了”这件事并没有自动变便宜。升级这种活,验证的工夫最好提前算进排期里,而不是等改完了再临时想办法。
回头看,我会怎么用 AI 做这类升级
总结下来,大概是这几条:
路线自己定,体力活交给它。 分几段、每段做什么、怎么验证,这个要自己想清楚。具体每一段里的修改,可以放心让 AI 多干。
把官方迁移指南喂给它,而不是让它凭记忆。 后来我把官方迁移指南里相关的章节直接贴进对话,让它对照着检查我的代码,准确率明显比它凭记忆回答高。
编译期能暴露的坑不可怕,可怕的是运行时才暴露的。 配置项改名、末尾斜杠、老库的过滤器,这些都是编译通过、单元测试通过、上了环境才出问题的。针对这类坑,接口级的回归测试和测试环境的验证省不掉。
每次提问都带上版本信息。 这一条看起来很傻,但真的有用。
有人可能会问,既然 AI 会挖坑,为什么不用 OpenRewrite 这类专门的迁移工具?其实我们也看了,它有现成的 Spring Boot 3 迁移规则,做机械替换比 AI 更确定。如果项目更大,我会优先用它做第一轮,再让 AI 处理剩下那些需要“理解”的部分。这次项目不大,就没折腾。
这次升级让我对 AI 的定位更清楚了:它是一个干活很快、但对“版本”这件事天然不敏感的帮手。它的知识是很多版本混在一起学出来的,你不划清边界,它就会在新旧之间来回横跳。划清了,它就是一个特别好用的升级搭子。
 2026-10-14鱼鱼