
让 AI 写 SQL 和迁移脚本:语法没错,坑全在数据里

  created  by  鱼鱼 {{tag}}
创建于 2026年10月10日 14:51:50 最后修改于 2026年10月10日 14:51:50

在我日常用 AI 写的各种代码里,SQL 大概是“看起来最省心”的一类。语法它几乎不会写错,连窗口函数、递归 CTE 都信手拈来。让它写个报表查询,或者写个加字段的迁移脚本,几秒钟就好,读一遍也挑不出毛病。

但正是这种“挑不出毛病”,让我吃过好几次亏。SQL 的坑很少出在语法上,而是出在语义、数据量和线上环境上——这三样东西,恰恰是 AI 在对话框里看不到的。这篇就把我踩过、或者差点踩到的坑整理一下,最后再说说我现在的做法。

先交代背景:我平时主要接触 MySQL,也维护过一些 PostgreSQL 的项目。下面说到具体行为时,我尽量注明是哪个数据库;不同版本之间行为可能有差异,以你用的版本的官方文档为准。

坑一:方言串台

这个最低级,但出现频率真不低。在 MySQL 项目里,它偶尔会写出 ILIKE、:: 类型转换这些 PostgreSQL 的写法;反过来在 PostgreSQL 项目里,它会写 LIMIT 10, 20 这种 MySQL 才认的分页,或者用反引号包字段名。

这种错误好在一跑就报错,不至于酿成事故。解决办法也简单:在提示里写清楚数据库种类和大版本。我现在的模板第一行就是“数据库:MySQL 8.0”或者“PostgreSQL 15”。版本也要写,因为有些语法和优化器行为是跨版本变化的。

坑二:NULL 的三值逻辑

这类坑最阴险,因为它不报错,只是悄悄返回错误的结果。

最经典的一个:用 NOT IN 加子查询。如果子查询的结果里有一个 NULL,整个 NOT IN 条件对任何行都不会为真,结果直接变成空集。我第一次碰到这个,是让 AI 写“找出没有下过单的用户”,它写的是:

SELECT id FROM users
WHERE id NOT IN (SELECT user_id FROM orders);

测试库里一切正常,因为测试数据的 user_id 都有值。到了真实数据里,orders 表恰好有几条历史脏数据的 user_id 是 NULL,于是这条查询返回了零行。更稳的写法是用 NOT EXISTS:

SELECT u.id FROM users u
WHERE NOT EXISTS (SELECT 1 FROM orders o WHERE o.user_id = u.id);

类似的还有:status <> 'CLOSED' 不会选出 status 为 NULL 的行;COUNT(col) 不计 NULL,而 COUNT(*) 计。这些规则 AI 其实都“知道”,你单独问它,它能讲得头头是道。问题是它写查询时,并不知道你的数据里到底有没有 NULL。所以我现在会在提示里附上表结构,并主动说明哪些列可能为空、历史数据干不干净。
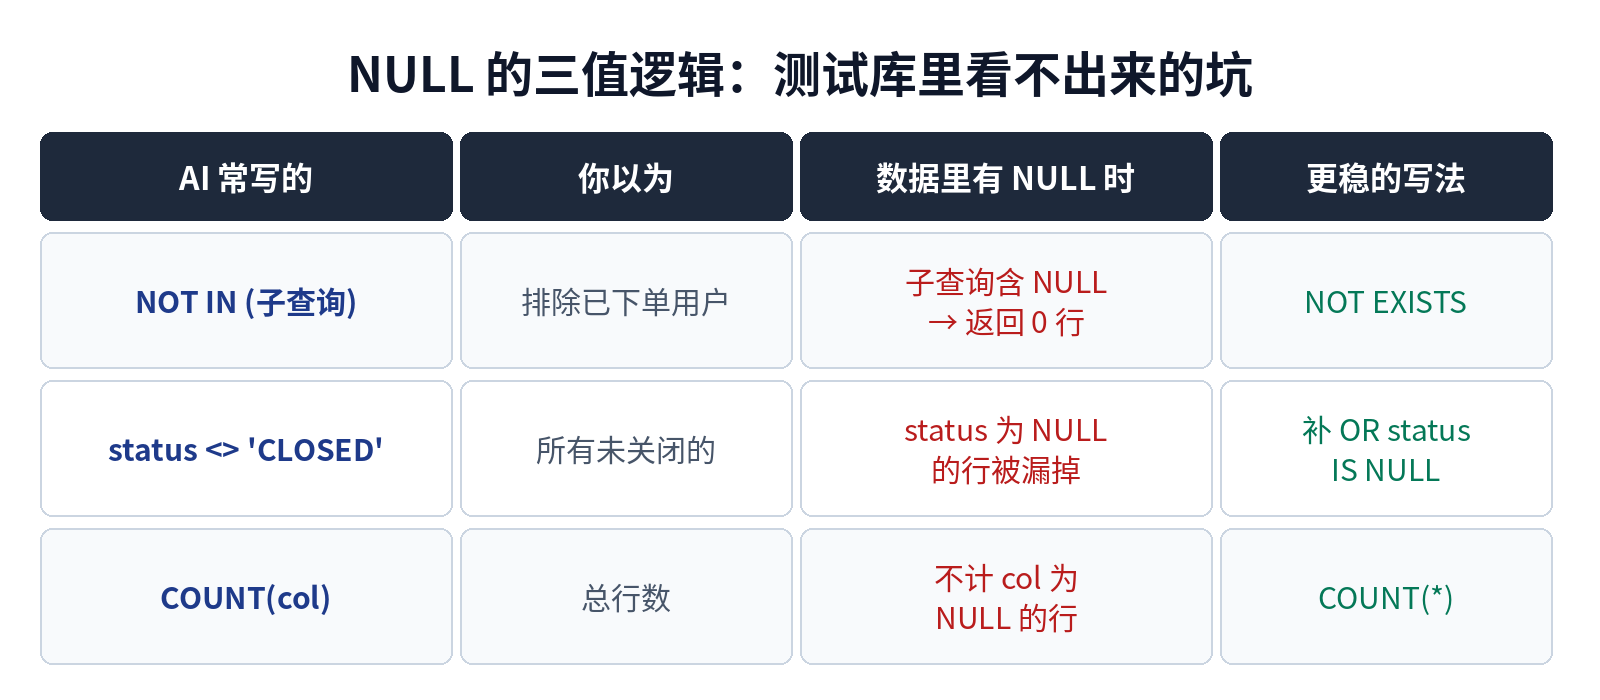
NULL 三值逻辑的三个常见陷阱与更稳的写法

图:NULL 三值逻辑的三个常见陷阱与更稳的写法(原创示意图)

坑三:在测试库秒出,到线上就慢

AI 写的查询,在本地几百条数据的测试库里永远是秒出。真正的问题只会在数据量上来之后才暴露。我见过最多的两种情况:

一是在索引列上套函数。 比如查某一天的订单,它会写 WHERE DATE(created_at) = '2026-10-01'。逻辑完全正确,但在 MySQL 里,对索引列套函数通常会让这个列上的普通索引用不上(除非你专门建了函数索引)。改成范围条件就好了:created_at >= '2026-10-01' AND created_at < '2026-10-02'。

二是隐式类型转换。 某个手机号字段是 VARCHAR,它在条件里写成了数字,没加引号。MySQL 不会报错,会默默做类型转换,但这样也可能导致索引失效,变成全表扫描。

这两类问题,只看 SQL 文本很难发现,必须看执行计划。所以我养成了一个习惯:AI 写的任何要上线的查询,我都会在有真实数据量级的环境里跑一遍 EXPLAIN。有时候也会让 AI 先写一段“预期的执行计划”,然后我拿真实的 EXPLAIN 结果去对照。如果两者对不上,往往就说明它对索引的判断错了。

坑四:迁移脚本里的锁

如果说查询写错了只是慢或者结果不对,那迁移脚本写错了,就可能直接让线上服务卡住。

让 AI 写一个加字段、改类型的迁移脚本,它给的 SQL 本身通常是对的,但它几乎不会主动提醒你:这条语句在一张大表上执行会发生什么。

  • 在 MySQL 8.0 里,加列等部分操作可以用 INSTANT 或 INPLACE 算法,对业务影响较小;但改列类型这类操作通常需要复制整张表,大表上可能跑很久。另外,即使是在线 DDL,也需要短暂拿到 元数据锁。如果这时候恰好有一个长事务没提交,DDL 会排队等锁,而它后面的普通查询又会排在 DDL 后面——这就是很多人遇到过的“改个字段整个表卡住”。
  • 在 PostgreSQL 里,较新的版本加一个带常量默认值的列不需要重写表,很快;但给已有的列加 NOT NULL 约束,需要扫描全表验证,期间会持有很强的锁。建索引如果不想长时间阻塞写入,要用 CREATE INDEX CONCURRENTLY,而它不能在事务块里执行——不少迁移工具默认会把每个脚本包进事务,需要单独配置。

还有一点:MySQL 的 DDL 会隐式提交,没法回滚。一个迁移脚本里如果先改表结构、再更新数据,执行到一半失败,你就会停在一个“改了一半”的状态。

坑五:数据回填一把梭

加完新字段,往往要把历史数据回填进去。AI 最常给的写法是一条大 UPDATE:

UPDATE orders SET region_code = (...) WHERE region_code IS NULL;

在小表上没问题。但在一张很大的表上,这就是一个巨大的事务:持锁时间长、产生大量日志、主从延迟飙升。我现在会要求它改成分批、按主键范围推进、可重复执行的方式:

-- 每次处理一段主键范围,由脚本循环推进 :start
UPDATE orders SET region_code = (...)
WHERE id >= :start AND id < :start + 1000
  AND region_code IS NULL;

“可重复执行”这一点很关键:脚本中途被打断,重新跑一遍不会出错,也不会重复处理。条件里的 region_code IS NULL 就是起这个作用的。

坑六:回滚脚本只是个摆设

很多迁移框架鼓励你写对应的回滚脚本,AI 也会很贴心地附上。但我仔细看过几次它写的回滚:加列的回滚就是删列,改类型的回滚就是改回去。

问题是,删列会把这段时间写进去的数据一起删掉;改回去的类型,可能装不下新写进去的值。这样的回滚,真到需要的时候反而会造成二次事故。我的看法是:在生产环境里,与其依赖回滚脚本,不如让每一步变更本身都是可以安全停下的。

我现在的做法

踩过这些坑之后,我现在让 AI 写 SQL 时,会固定附上一组信息:数据库和版本、相关表的建表语句(包括索引)、大致的数据量级、哪些列可能为空、这条 SQL 的执行场景(线上接口、后台任务还是一次性脚本)。

信息给全了,AI 的表现会好很多,它甚至会主动提醒你“这张表数据量大,建议分批”。
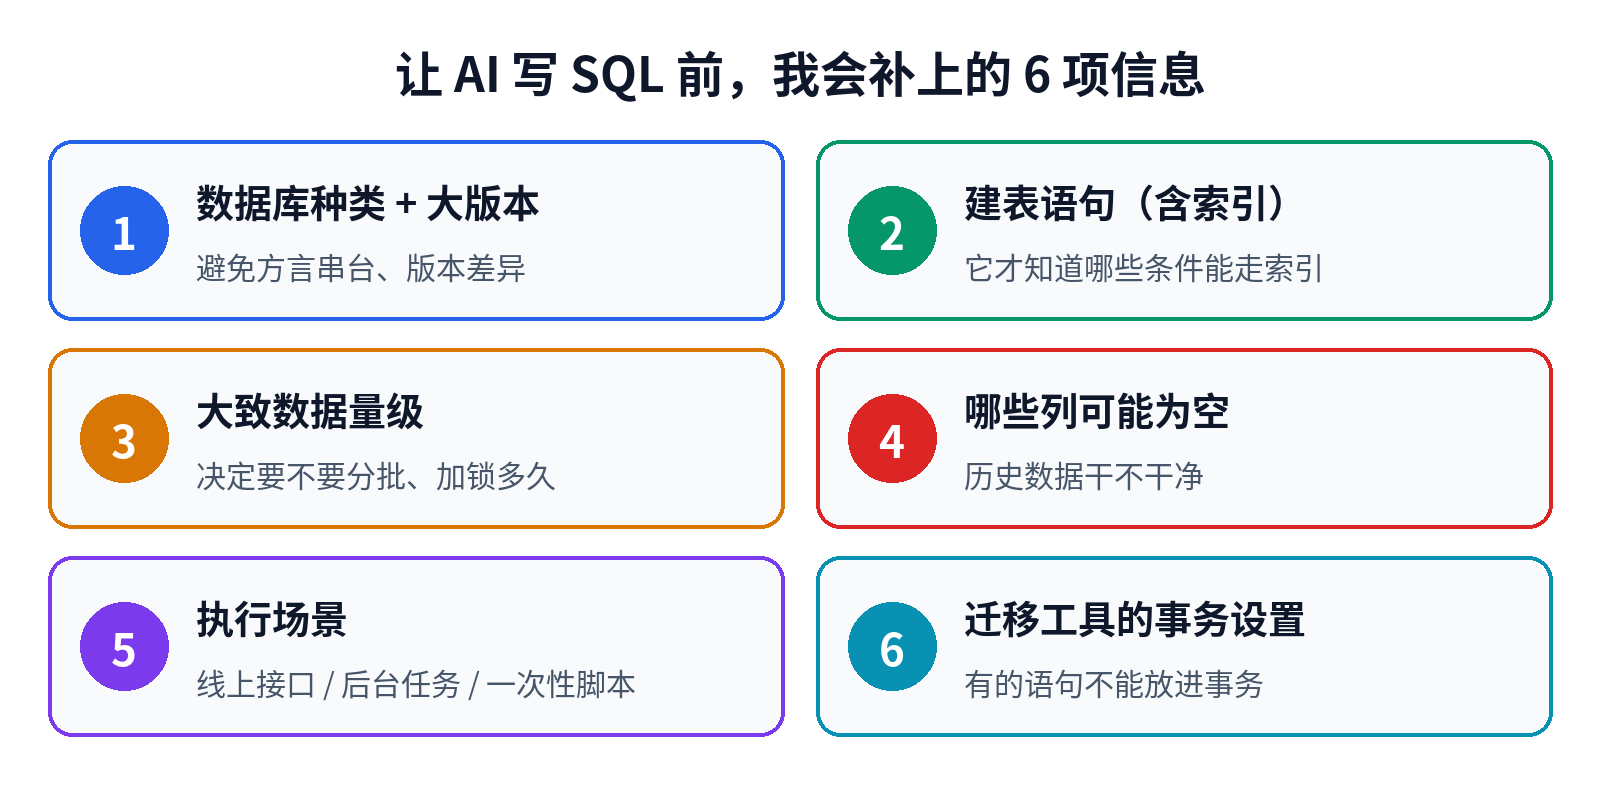
让 AI 写 SQL 前要补上的 6 项信息

图:让 AI 写 SQL 前要补上的 6 项信息(原创示意图)

对于涉及表结构的变更,我现在基本都按“先扩展、再收缩”的思路拆成几步:先加新字段(兼容旧代码)、代码改成同时写新旧字段、分批回填历史数据、把读切到新字段、观察一段时间没问题后,最后再删掉旧字段。每一步都能单独上线,也都能停在原地不往下走。这样即使中间某一步出了问题,影响也是可控的。

我会让 AI 帮我把一个大的变更拆成这样的步骤,并写出每一步的脚本。它拆得通常不错,但每一步在大表上的锁和耗时,我还是会自己在一个有真实数据量级的副本上验证一遍。
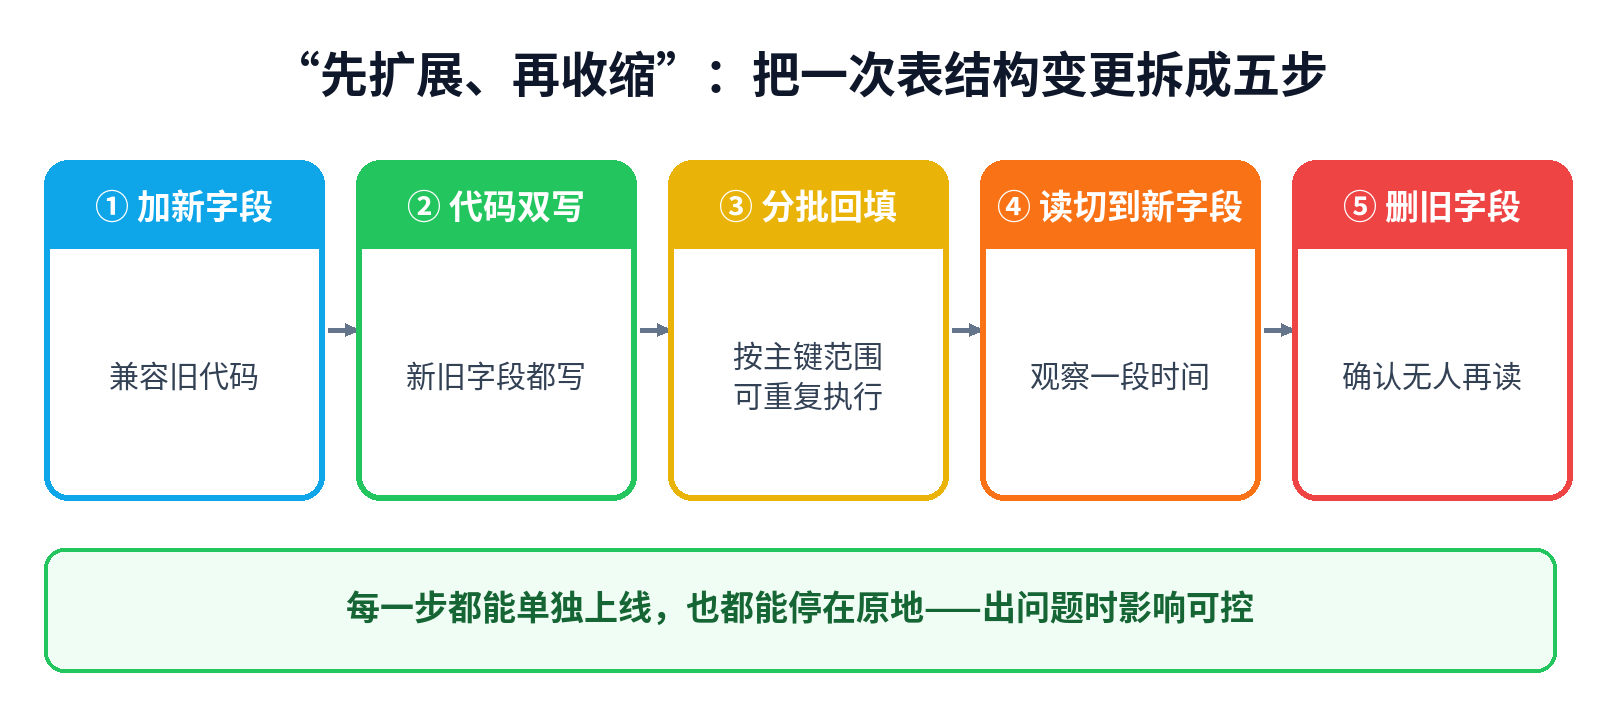
先扩展再收缩:表结构变更拆成五步

图:先扩展再收缩:表结构变更拆成五步(原创示意图)

最后

说到底,AI 写 SQL 的问题不在于它“不会写”,而在于它看不到你的数据。语法、函数、写法这些,它比大多数人都熟;但数据里有多少 NULL、表有多大、线上有没有长事务、迁移工具是不是默认开了事务,这些只有你知道。

所以我的原则就一句话:SQL 可以让它写,数据和环境必须你来补。 把这些信息补进提示里,再加上一次真实环境里的 EXPLAIN 和一次大表演练,大部分坑都能在上线前被拦住。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

让 AI 写 SQL 和迁移脚本:语法没错,坑全在数据里

让 AI 写 SQL 和迁移脚本:语法没错,坑全在数据里

在我日常用 AI 写的各种代码里,SQL 大概是“看起来最省心”的一类。语法它几乎不会写错,连窗口函数、递归 CTE 都信手拈来。让它写个报表查询,或者写个加字段的迁移脚本,几秒钟就好,读一遍也挑不出毛病。

但正是这种“挑不出毛病”,让我吃过好几次亏。SQL 的坑很少出在语法上,而是出在语义、数据量和线上环境上——这三样东西,恰恰是 AI 在对话框里看不到的。这篇就把我踩过、或者差点踩到的坑整理一下,最后再说说我现在的做法。

先交代背景:我平时主要接触 MySQL,也维护过一些 PostgreSQL 的项目。下面说到具体行为时,我尽量注明是哪个数据库;不同版本之间行为可能有差异,以你用的版本的官方文档为准。

坑一:方言串台

这个最低级,但出现频率真不低。在 MySQL 项目里,它偶尔会写出 ILIKE、:: 类型转换这些 PostgreSQL 的写法;反过来在 PostgreSQL 项目里,它会写 LIMIT 10, 20 这种 MySQL 才认的分页,或者用反引号包字段名。

这种错误好在一跑就报错,不至于酿成事故。解决办法也简单:在提示里写清楚数据库种类和大版本。我现在的模板第一行就是“数据库:MySQL 8.0”或者“PostgreSQL 15”。版本也要写,因为有些语法和优化器行为是跨版本变化的。

坑二:NULL 的三值逻辑

这类坑最阴险,因为它不报错,只是悄悄返回错误的结果。

最经典的一个:用 NOT IN 加子查询。如果子查询的结果里有一个 NULL,整个 NOT IN 条件对任何行都不会为真,结果直接变成空集。我第一次碰到这个,是让 AI 写“找出没有下过单的用户”,它写的是:

SELECT id FROM users
WHERE id NOT IN (SELECT user_id FROM orders);

测试库里一切正常,因为测试数据的 user_id 都有值。到了真实数据里,orders 表恰好有几条历史脏数据的 user_id 是 NULL,于是这条查询返回了零行。更稳的写法是用 NOT EXISTS:

SELECT u.id FROM users u
WHERE NOT EXISTS (SELECT 1 FROM orders o WHERE o.user_id = u.id);

类似的还有:status <> 'CLOSED' 不会选出 status 为 NULL 的行;COUNT(col) 不计 NULL,而 COUNT(*) 计。这些规则 AI 其实都“知道”,你单独问它,它能讲得头头是道。问题是它写查询时,并不知道你的数据里到底有没有 NULL。所以我现在会在提示里附上表结构,并主动说明哪些列可能为空、历史数据干不干净。

NULL 三值逻辑的三个常见陷阱与更稳的写法

图:NULL 三值逻辑的三个常见陷阱与更稳的写法(原创示意图)

坑三:在测试库秒出,到线上就慢

AI 写的查询,在本地几百条数据的测试库里永远是秒出。真正的问题只会在数据量上来之后才暴露。我见过最多的两种情况:

一是在索引列上套函数。 比如查某一天的订单,它会写 WHERE DATE(created_at) = '2026-10-01'。逻辑完全正确,但在 MySQL 里,对索引列套函数通常会让这个列上的普通索引用不上(除非你专门建了函数索引)。改成范围条件就好了:created_at >= '2026-10-01' AND created_at < '2026-10-02'。

二是隐式类型转换。 某个手机号字段是 VARCHAR,它在条件里写成了数字,没加引号。MySQL 不会报错,会默默做类型转换,但这样也可能导致索引失效,变成全表扫描。

这两类问题,只看 SQL 文本很难发现,必须看执行计划。所以我养成了一个习惯:AI 写的任何要上线的查询,我都会在有真实数据量级的环境里跑一遍 EXPLAIN。有时候也会让 AI 先写一段“预期的执行计划”,然后我拿真实的 EXPLAIN 结果去对照。如果两者对不上,往往就说明它对索引的判断错了。

坑四:迁移脚本里的锁

如果说查询写错了只是慢或者结果不对,那迁移脚本写错了,就可能直接让线上服务卡住。

让 AI 写一个加字段、改类型的迁移脚本,它给的 SQL 本身通常是对的,但它几乎不会主动提醒你:这条语句在一张大表上执行会发生什么。

还有一点:MySQL 的 DDL 会隐式提交,没法回滚。一个迁移脚本里如果先改表结构、再更新数据,执行到一半失败,你就会停在一个“改了一半”的状态。

坑五:数据回填一把梭

加完新字段,往往要把历史数据回填进去。AI 最常给的写法是一条大 UPDATE:

UPDATE orders SET region_code = (...) WHERE region_code IS NULL;

在小表上没问题。但在一张很大的表上,这就是一个巨大的事务:持锁时间长、产生大量日志、主从延迟飙升。我现在会要求它改成分批、按主键范围推进、可重复执行的方式:

-- 每次处理一段主键范围,由脚本循环推进 :start
UPDATE orders SET region_code = (...)
WHERE id >= :start AND id < :start + 1000
  AND region_code IS NULL;

“可重复执行”这一点很关键:脚本中途被打断,重新跑一遍不会出错,也不会重复处理。条件里的 region_code IS NULL 就是起这个作用的。

坑六:回滚脚本只是个摆设

很多迁移框架鼓励你写对应的回滚脚本,AI 也会很贴心地附上。但我仔细看过几次它写的回滚:加列的回滚就是删列,改类型的回滚就是改回去。

问题是,删列会把这段时间写进去的数据一起删掉;改回去的类型,可能装不下新写进去的值。这样的回滚,真到需要的时候反而会造成二次事故。我的看法是:在生产环境里,与其依赖回滚脚本,不如让每一步变更本身都是可以安全停下的。

我现在的做法

踩过这些坑之后,我现在让 AI 写 SQL 时,会固定附上一组信息:数据库和版本、相关表的建表语句(包括索引)、大致的数据量级、哪些列可能为空、这条 SQL 的执行场景(线上接口、后台任务还是一次性脚本)。

信息给全了,AI 的表现会好很多,它甚至会主动提醒你“这张表数据量大,建议分批”。

让 AI 写 SQL 前要补上的 6 项信息

图:让 AI 写 SQL 前要补上的 6 项信息(原创示意图)

对于涉及表结构的变更,我现在基本都按“先扩展、再收缩”的思路拆成几步:先加新字段(兼容旧代码)、代码改成同时写新旧字段、分批回填历史数据、把读切到新字段、观察一段时间没问题后,最后再删掉旧字段。每一步都能单独上线,也都能停在原地不往下走。这样即使中间某一步出了问题,影响也是可控的。

我会让 AI 帮我把一个大的变更拆成这样的步骤,并写出每一步的脚本。它拆得通常不错,但每一步在大表上的锁和耗时,我还是会自己在一个有真实数据量级的副本上验证一遍。

先扩展再收缩:表结构变更拆成五步

图:先扩展再收缩:表结构变更拆成五步(原创示意图)

最后

说到底,AI 写 SQL 的问题不在于它“不会写”,而在于它看不到你的数据。语法、函数、写法这些,它比大多数人都熟;但数据里有多少 NULL、表有多大、线上有没有长事务、迁移工具是不是默认开了事务,这些只有你知道。

所以我的原则就一句话:SQL 可以让它写,数据和环境必须你来补。 把这些信息补进提示里,再加上一次真实环境里的 EXPLAIN 和一次大表演练,大部分坑都能在上线前被拦住。


让 AI 写 SQL 和迁移脚本:语法没错,坑全在数据里2026-10-10鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论