接手陌生代码库的第一周,我让 AI 当向导

  created  by  鱼鱼 {{tag}}
创建于 2026年10月10日 14:49:28 最后修改于 2026年10月10日 14:49:28

前阵子我接手了一个老服务。说它老,不是说技术栈有多古早,而是它经历过好几拨人:最早写它的人早就转岗了,中间有人加过功能,也有人做过“临时方案”,README 停留在两年前的某次重构之前。给我的熟悉时间大概是一周,之后就要开始接需求。

以前遇到这种情况,我的套路是从启动类开始一路点进去,点到头晕,再去翻提交记录,看看谁改得最多,厚着脸皮去问。这次我换了个方式:让 AI 陪我读。一周下来,感受挺复杂的——它确实让我快了不少,但也有几次差点把我带进沟里。这篇就记一下我是怎么用的,哪些地方好用,哪些地方我后来学乖了。

第一天:别问“这项目是干嘛的”

我犯的第一个错,就是一上来问它:“帮我介绍一下这个项目的整体架构。”

它回答得非常漂亮,分层、模块、职责,一条一条,跟教科书似的。问题是,我回头一对照,里面有一半是 README 的复述,另一半是根据包名“合理推测”出来的。比如有个叫 cache 的包,它说“负责缓存热点数据”;我点开一看,里面其实是一个本地的配置快照,和缓存热点数据关系不大。名字骗了它,也差点骗了我。

后来我想明白了:泛泛的问题,只能得到泛泛的回答,而且你根本没法判断它哪里说对了、哪里在编。于是第一天下午我就改了提问方式,只问能被核对的问题:

  • 一个外部请求从哪里进来?给我具体的类名和方法名。
  • 配置是从哪些地方读的?列出文件路径。
  • 这个服务依赖了哪些外部系统?在代码里是怎么调用的?

而且我会加一句硬要求:每个结论都要带文件路径,最好带行号;不确定的地方直接说不确定。 加了这句之后,它的回答明显“收”了,会出现“这里我没有找到明确的调用方,可能是通过反射或配置加载的”这种话。说实话,看到它承认不知道,我反而更放心。
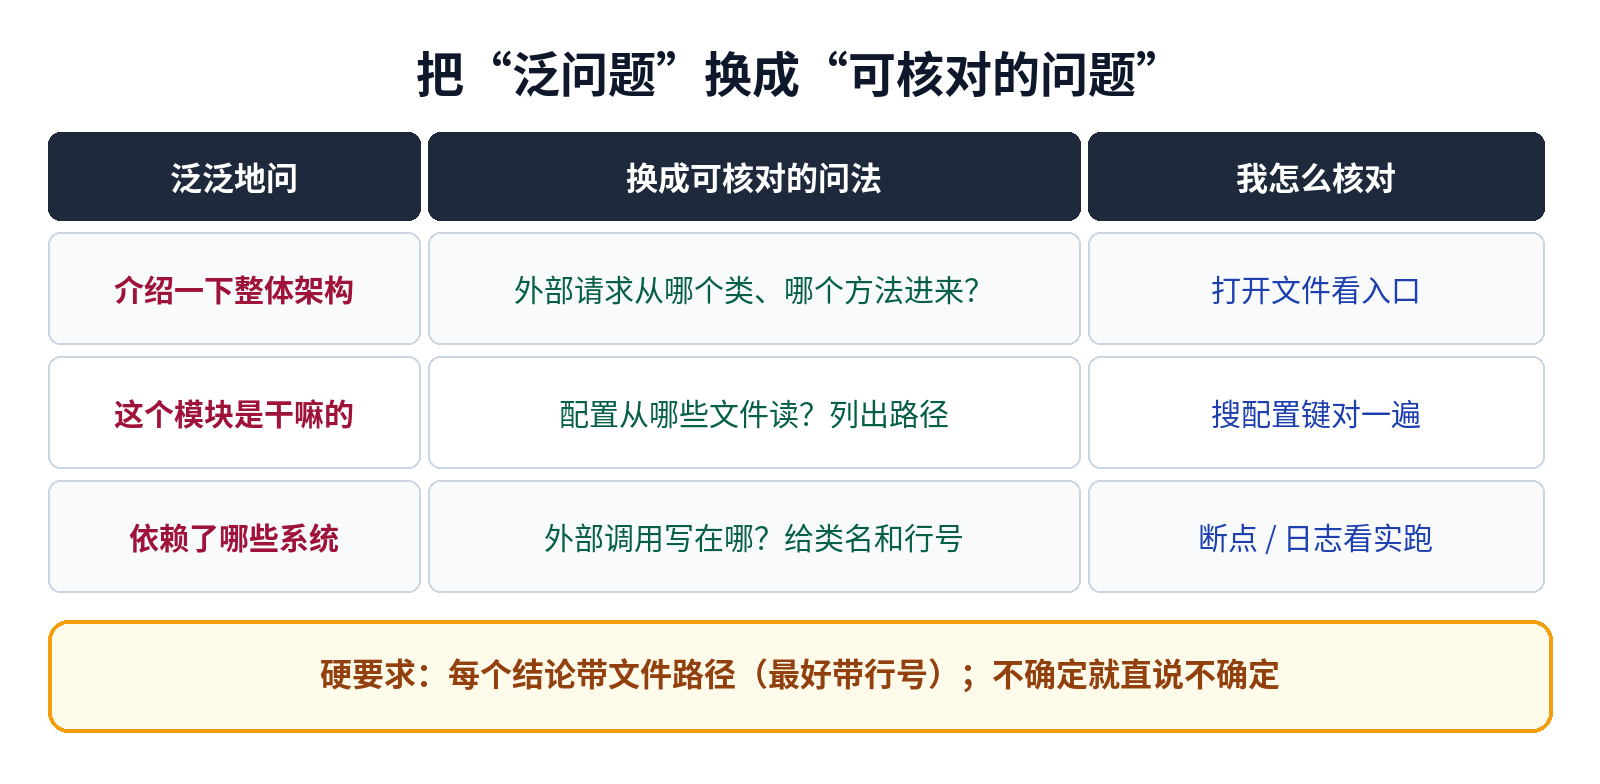
把泛泛的问题换成可核对的问题:问法与核对方式对照表

图:把泛泛的问题换成可核对的问题:问法与核对方式对照表(原创示意图)

第二、三天:跟着一条真实请求走

光看静态结构其实记不住。我挑了一条业务里最核心、也是之后最可能要改的链路,用最笨的办法:本地起服务,打一个真实请求,在关键位置打断点,同时让 AI 解释每一跳在干嘛。

这时候 AI 的价值体现得特别明显。以前我卡在一段看不懂的代码上,要么硬啃,要么搁置;现在可以直接把那段贴给它,问“这段在处理什么边界情况”。它对那种写得很绕的条件判断、老式的工具方法、一些我不熟悉的框架用法,解释得又快又准。有个地方用了我很少见的注解组合,我自己查文档可能要十几分钟,它几句话就说清楚了,我再去文档里确认一下就行。

但是断点会告诉你真相。有一次它很笃定地说某个方法“会调用订单服务查询状态”,我在断点里一路跟下去,发现这个分支在当前配置下根本不会走到——真正执行的是另一个实现类,靠配置开关决定装配哪一个。它看到的是代码里“写了什么”,而断点告诉我的是“实际跑了什么”。这两者在老项目里差别可能非常大。

所以我给自己定了一条规矩:AI 的解释当作假说,断点和日志当作证据。 关键链路上的每一个结论,至少要用一次运行时的证据确认。

它最容易看漏的地方

一周下来,我发现 AI 读代码出错,大多数不是“看不懂”,而是“看不见”。它擅长沿着显式的方法调用往下读,但老项目里大量逻辑是不在调用链上的。我自己记了一份清单,后来每次问问题都会顺带提醒它看这些地方:

  • 按条件装配的多个实现:同一个接口好几个实现,靠配置或环境决定用哪个;
  • 切面和拦截器:日志、鉴权、事务、重试,可能都藏在切面里,读业务方法根本看不出来;
  • 事件监听和消息消费:发一个事件,另一处默默处理;或者某个消费者订阅了消息,它本身就是一个“入口”;
  • 定时任务:有些数据是定时任务半夜改的,你在请求链路里永远找不到;
  • 配置驱动的行为:开关、灰度规则、数据库里的配置表。

这些东西的共同点是:入口不在你正在看的那条线上。 我后来会专门问它一句:“除了显式调用,还有哪些地方可能修改这张表或者这个字段?请把切面、监听器、消息消费者、定时任务都搜一遍。”这句话加上之后,它找出了两个我完全没想到的写入点,其中一个是定时任务。
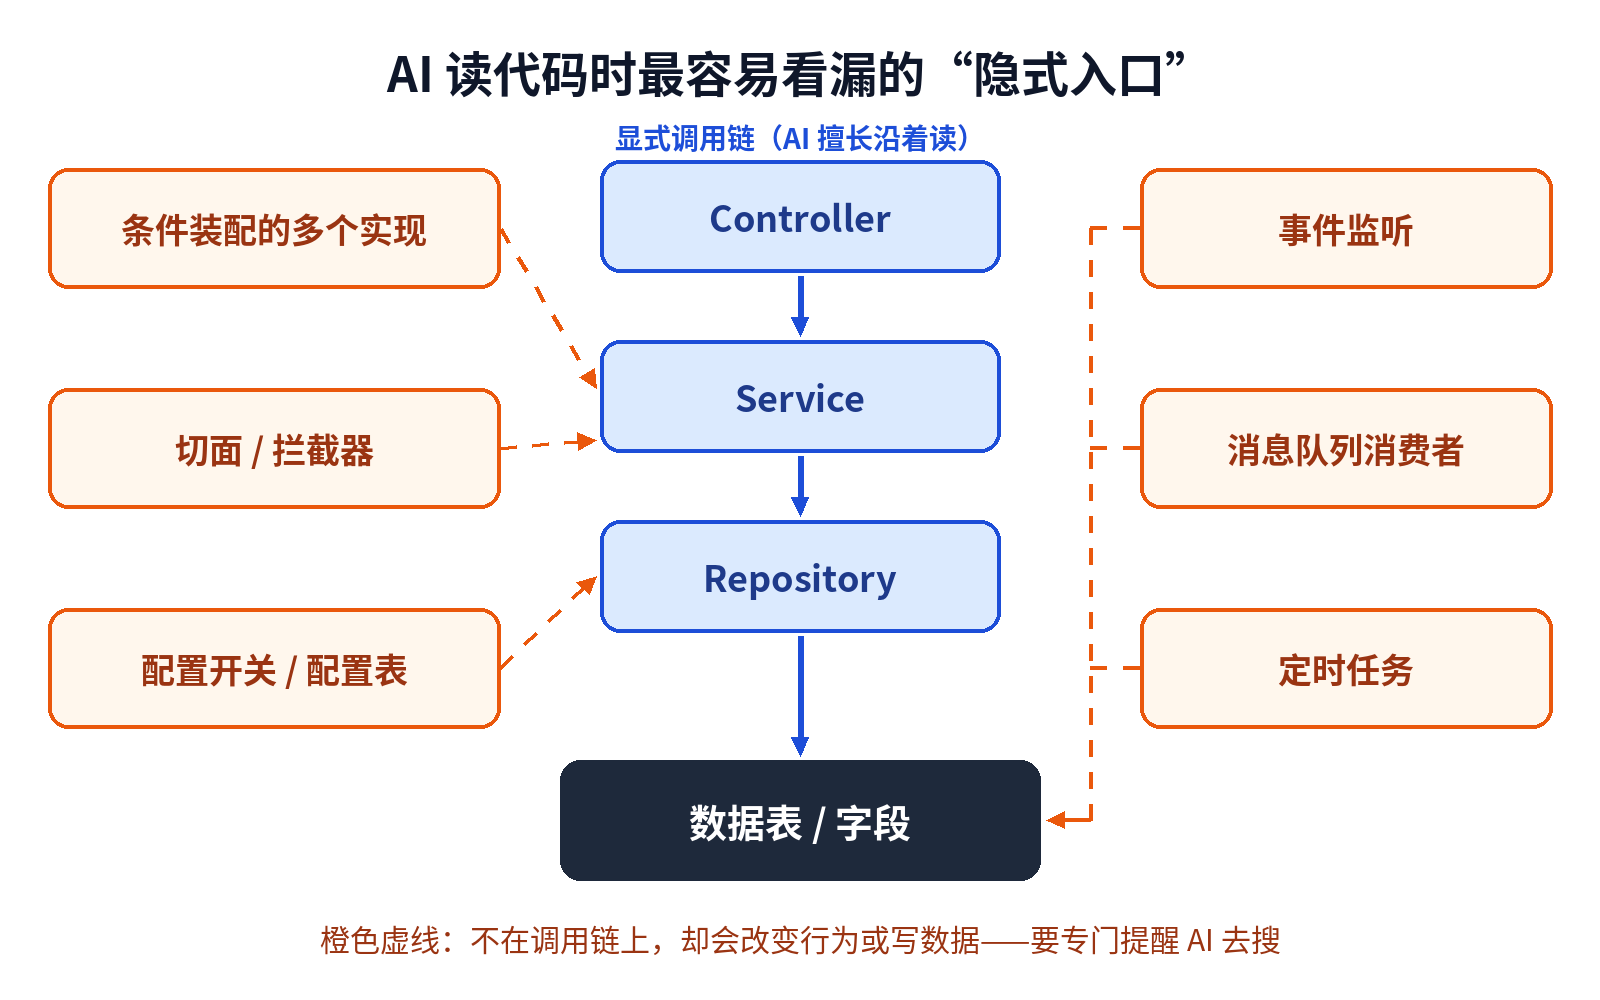
AI 读代码时容易看漏的隐式入口:条件装配、切面、配置、事件、消息、定时任务

图:AI 读代码时容易看漏的隐式入口:条件装配、切面、配置、事件、消息、定时任务(原创示意图)

第四、五天:把读懂的东西写下来

前三天我脑子里塞了很多东西,但到了第四天发现,昨天搞明白的事今天就模糊了。于是我开始做一件事:每天结束前,让 AI 根据当天的对话帮我起草一份模块笔记,然后我自己改。

这里有个小技巧,我觉得特别有用:我让它把笔记写成“我以为 / 实际上”的格式。比如“我以为 cache 包是缓存,实际上是配置快照”“我以为下单会同步查库存,实际上是异步消息”。这种格式记录的恰好是最容易踩坑的认知偏差,下一个接手的人看到会非常省事。

起草这件事 AI 做得很好,但改稿必须我来。它写的笔记有个通病:会把我们讨论中“可能”“好像”的地方,悄悄写成肯定句。如果不改,这份笔记就会把未经证实的推测,包装成看起来很权威的文档。我改稿时主要就做两件事:删掉没验证过的结论,或者明确标上“未确认”。

第五天,领导让我先改一个小需求。我发现自己确实能下手了——知道改哪里、会影响哪里、哪个定时任务要一起看。这一点上,我觉得比起以前单打独斗,至少省了一两天的摸索时间(这是我个人的感受,没法精确对比)。
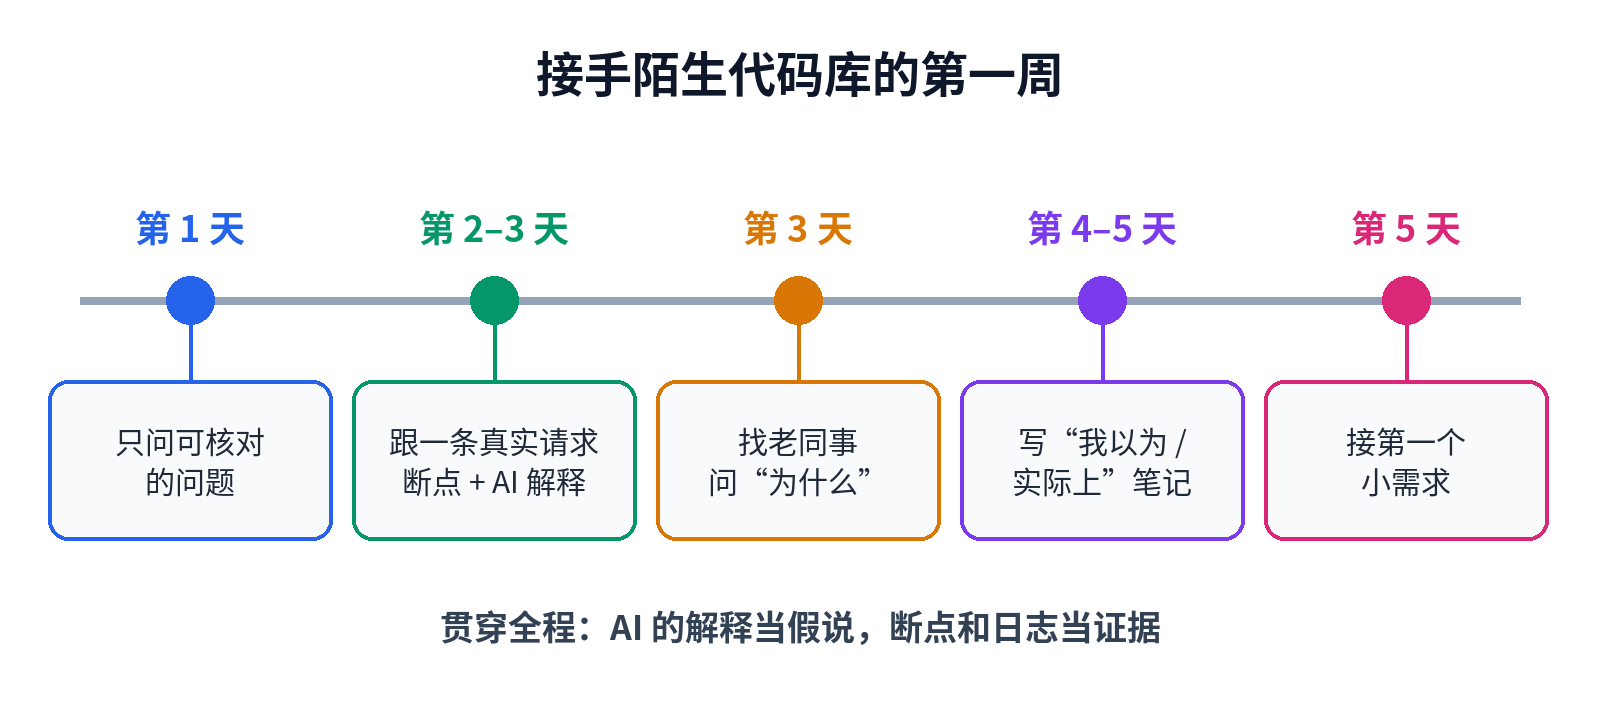
接手陌生代码库第一周的时间线

图:接手陌生代码库第一周的时间线(原创示意图)

几个取舍,说说我的真实想法

第一,“听懂了”的感觉是会骗人的。 AI 的解释太顺了,读完总有一种“我懂了”的满足感。但听懂解释和能改代码是两回事。我检验自己是否真懂的方法很土:合上对话窗口,自己在纸上画一遍这条链路;或者故意改一行,预测哪个测试会挂,再跑一下看看预测对不对。

第二,不要把它当成唯一的信息来源。 提交记录、旧的需求文档、跟老同事聊十分钟,这些信息 AI 都拿不到,却往往是最关键的“为什么”。代码只能告诉你“是什么”,很多奇怪的写法背后是一次事故、一个客户的特殊要求,这些只有人知道。我第三天去找了之前维护过的同事,他提醒我那块逻辑有外部客户在依赖,别轻易动——就这一句提醒,顶我读半天代码。

第三,注意你给它看了什么。 老项目里难免有配置文件写着连接串甚至密钥。贴代码之前,我会先看一眼有没有敏感信息,公司对这类工具也有自己的规定,这个得先问清楚,不能图省事。

最后

如果要我用一句话总结这一周:AI 很适合帮你画地图,但路得你自己走一遍。 它能把一张陌生的地图快速勾出轮廓,告诉你哪里可能是主干道;但哪条路是断的、哪里有暗沟,只能靠你自己的断点、日志和那几位老同事。

下次再接手陌生项目,我大概还会这么干,只是会从第一天起就只问可验证的问题,而不是等到被那个叫 cache 的包坑一次才学乖。

封面底图:Orbis typus uniuersalis iuxta hydrographorum traditionem,Norman B. Leventhal Map Center at the BPL,Flickr,CC BY 2.0;已裁切、压暗并叠加文字。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

接手陌生代码库的第一周,我让 AI 当向导

接手陌生代码库的第一周,我让 AI 当向导

前阵子我接手了一个老服务。说它老,不是说技术栈有多古早,而是它经历过好几拨人:最早写它的人早就转岗了,中间有人加过功能,也有人做过“临时方案”,README 停留在两年前的某次重构之前。给我的熟悉时间大概是一周,之后就要开始接需求。

以前遇到这种情况,我的套路是从启动类开始一路点进去,点到头晕,再去翻提交记录,看看谁改得最多,厚着脸皮去问。这次我换了个方式:让 AI 陪我读。一周下来,感受挺复杂的——它确实让我快了不少,但也有几次差点把我带进沟里。这篇就记一下我是怎么用的,哪些地方好用,哪些地方我后来学乖了。

第一天:别问“这项目是干嘛的”

我犯的第一个错,就是一上来问它:“帮我介绍一下这个项目的整体架构。”

它回答得非常漂亮,分层、模块、职责,一条一条,跟教科书似的。问题是,我回头一对照,里面有一半是 README 的复述,另一半是根据包名“合理推测”出来的。比如有个叫 cache 的包,它说“负责缓存热点数据”;我点开一看,里面其实是一个本地的配置快照,和缓存热点数据关系不大。名字骗了它,也差点骗了我。

后来我想明白了:泛泛的问题,只能得到泛泛的回答,而且你根本没法判断它哪里说对了、哪里在编。于是第一天下午我就改了提问方式,只问能被核对的问题:

而且我会加一句硬要求:每个结论都要带文件路径,最好带行号;不确定的地方直接说不确定。 加了这句之后,它的回答明显“收”了,会出现“这里我没有找到明确的调用方,可能是通过反射或配置加载的”这种话。说实话,看到它承认不知道,我反而更放心。

把泛泛的问题换成可核对的问题:问法与核对方式对照表

图:把泛泛的问题换成可核对的问题:问法与核对方式对照表(原创示意图)

第二、三天:跟着一条真实请求走

光看静态结构其实记不住。我挑了一条业务里最核心、也是之后最可能要改的链路,用最笨的办法:本地起服务,打一个真实请求,在关键位置打断点,同时让 AI 解释每一跳在干嘛。

这时候 AI 的价值体现得特别明显。以前我卡在一段看不懂的代码上,要么硬啃,要么搁置;现在可以直接把那段贴给它,问“这段在处理什么边界情况”。它对那种写得很绕的条件判断、老式的工具方法、一些我不熟悉的框架用法,解释得又快又准。有个地方用了我很少见的注解组合,我自己查文档可能要十几分钟,它几句话就说清楚了,我再去文档里确认一下就行。

但是断点会告诉你真相。有一次它很笃定地说某个方法“会调用订单服务查询状态”,我在断点里一路跟下去,发现这个分支在当前配置下根本不会走到——真正执行的是另一个实现类,靠配置开关决定装配哪一个。它看到的是代码里“写了什么”,而断点告诉我的是“实际跑了什么”。这两者在老项目里差别可能非常大。

所以我给自己定了一条规矩:AI 的解释当作假说,断点和日志当作证据。 关键链路上的每一个结论,至少要用一次运行时的证据确认。

它最容易看漏的地方

一周下来,我发现 AI 读代码出错,大多数不是“看不懂”,而是“看不见”。它擅长沿着显式的方法调用往下读,但老项目里大量逻辑是不在调用链上的。我自己记了一份清单,后来每次问问题都会顺带提醒它看这些地方:

这些东西的共同点是:入口不在你正在看的那条线上。 我后来会专门问它一句:“除了显式调用,还有哪些地方可能修改这张表或者这个字段?请把切面、监听器、消息消费者、定时任务都搜一遍。”这句话加上之后,它找出了两个我完全没想到的写入点,其中一个是定时任务。

AI 读代码时容易看漏的隐式入口:条件装配、切面、配置、事件、消息、定时任务

图:AI 读代码时容易看漏的隐式入口:条件装配、切面、配置、事件、消息、定时任务(原创示意图)

第四、五天:把读懂的东西写下来

前三天我脑子里塞了很多东西,但到了第四天发现,昨天搞明白的事今天就模糊了。于是我开始做一件事:每天结束前,让 AI 根据当天的对话帮我起草一份模块笔记,然后我自己改。

这里有个小技巧,我觉得特别有用:我让它把笔记写成“我以为 / 实际上”的格式。比如“我以为 cache 包是缓存,实际上是配置快照”“我以为下单会同步查库存,实际上是异步消息”。这种格式记录的恰好是最容易踩坑的认知偏差,下一个接手的人看到会非常省事。

起草这件事 AI 做得很好,但改稿必须我来。它写的笔记有个通病:会把我们讨论中“可能”“好像”的地方,悄悄写成肯定句。如果不改,这份笔记就会把未经证实的推测,包装成看起来很权威的文档。我改稿时主要就做两件事:删掉没验证过的结论,或者明确标上“未确认”。

第五天,领导让我先改一个小需求。我发现自己确实能下手了——知道改哪里、会影响哪里、哪个定时任务要一起看。这一点上,我觉得比起以前单打独斗,至少省了一两天的摸索时间(这是我个人的感受,没法精确对比)。

接手陌生代码库第一周的时间线

图:接手陌生代码库第一周的时间线(原创示意图)

几个取舍,说说我的真实想法

第一,“听懂了”的感觉是会骗人的。 AI 的解释太顺了,读完总有一种“我懂了”的满足感。但听懂解释和能改代码是两回事。我检验自己是否真懂的方法很土:合上对话窗口,自己在纸上画一遍这条链路;或者故意改一行,预测哪个测试会挂,再跑一下看看预测对不对。

第二,不要把它当成唯一的信息来源。 提交记录、旧的需求文档、跟老同事聊十分钟,这些信息 AI 都拿不到,却往往是最关键的“为什么”。代码只能告诉你“是什么”,很多奇怪的写法背后是一次事故、一个客户的特殊要求,这些只有人知道。我第三天去找了之前维护过的同事,他提醒我那块逻辑有外部客户在依赖,别轻易动——就这一句提醒,顶我读半天代码。

第三,注意你给它看了什么。 老项目里难免有配置文件写着连接串甚至密钥。贴代码之前,我会先看一眼有没有敏感信息,公司对这类工具也有自己的规定,这个得先问清楚,不能图省事。

最后

如果要我用一句话总结这一周:AI 很适合帮你画地图,但路得你自己走一遍。 它能把一张陌生的地图快速勾出轮廓,告诉你哪里可能是主干道;但哪条路是断的、哪里有暗沟,只能靠你自己的断点、日志和那几位老同事。

下次再接手陌生项目,我大概还会这么干,只是会从第一天起就只问可验证的问题,而不是等到被那个叫 cache 的包坑一次才学乖。

封面底图:Orbis typus uniuersalis iuxta hydrographorum traditionem,Norman B. Leventhal Map Center at the BPL,Flickr,CC BY 2.0;已裁切、压暗并叠加文字。


接手陌生代码库的第一周,我让 AI 当向导2026-10-10鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论