RAG 在 Coding Agent 里:什么时候有用,什么时候添乱

  created  by  鱼鱼 {{tag}}
创建于 2026年10月10日 14:45:17 最后修改于 2026年10月10日 14:45:17

一提到让 Agent “懂我们的代码库”,很多人的第一反应是上 RAG:把仓库切块、嵌入、丢进向量库,提问时先检索再生成。听起来理所当然,我自己也做过。用下来的感受是:RAG 在 coding agent 里不是默认答案,而是一种有代价的缓存与索引策略。 用对了能省上下文、提高命中;用错了会检索到似是而非的片段,把模型带进沟里。

这篇文章想尽量说人话:哪些场景我愿意上 RAG,哪些场景我宁愿用“直接读文件 / 搜符号 / 开测试”的工具,以及怎么判断它在添乱。
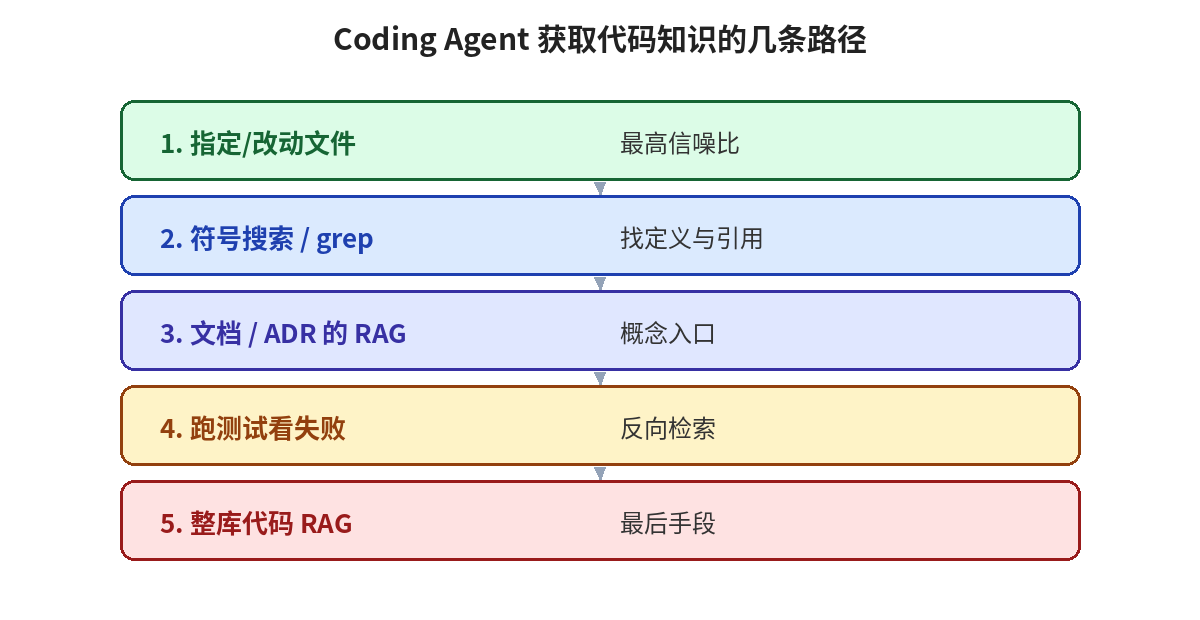
Coding Agent 获取代码知识的几条路径优先级

图片来源:原创示意图

先把问题说清楚:Coding Agent 缺的是什么

Coding Agent 跟“企业内部知识问答”不一样。它通常已经有这些能力:

  • 列出目录、按路径读文件;
  • grep / 语义搜索符号;
  • 跑测试、看报错;
  • 在多轮里维护一段工作记忆(当前任务、已改文件)。

它缺的往往不是“百科”,而是:在正确的时刻拿到正确的那一小段代码,并且知道这段代码是否仍然有效。
向量检索擅长“语义相近”,不擅长“这个符号现在的定义在哪、这个接口会不会在下一行被覆盖”。

所以我把 RAG 当成补充通道,而不是主通道。

什么时候 RAG 真的有用

1. 大仓库里的“概念入口”

比如新人(或 Agent)问:“我们系统里的结算是怎么跑的?”
这不是一个精确符号问题,而是概念问题。仓库里可能有设计文档、ADR、若干 Service 入口。RAG 对这类“从自然语言概念跳到相关文件集合”很合适,能提供一张地图。

注意:地图之后,仍然要让 Agent 打开文件精读,而不是只凭检索片段改代码。

2. 文档、运行手册、历史事故复盘

Markdown、RFC、postmortem,天然适合切块检索。它们更新频率相对低,结构和人类提问方式接近。把“如何本地启动支付模块”“上次双十一超时怎么处理的”交给 RAG,往往比塞进系统提示词更干净。

3. 跨语言/跨模块的“别名世界”

业务里同一个东西可能叫 Customer、Buyer、uid、user_id。符号搜索对别名不友好时,语义检索有时能搭桥。但要把结果当线索,不当真理。

4. 提示词里塞不下的稳定规范

编码规范、安全基线、API 错误码表——内容稳、需要偶尔引用。RAG 或“按需加载的规则文件”都行,不一定非要向量库;有时目录约定 + 主动读取更简单。

什么时候 RAG 很容易添乱

1. 精确改bug、精确改函数

根因在 FooService#bar 第 128 行。这时最需要的是:打开该文件、看调用方、跑相关测试。向量检索可能带回三个“也叫 bar”的历史副本、一篇过时 wiki、一段相似但位于旧分支逻辑的代码。模型一旦被相似片段带偏,会改错地方还振振有词。

2. 代码刚被改过,索引还是旧的

这是 coding agent 场景的硬伤。Agent 自己刚重构完,RAG 还指着十分钟前的块。如果没有“写后失效 / 提交后重建”的纪律,检索结果就是过期新闻。我见过 Agent 一边改代码一边检索到旧实现,然后把旧逻辑又写回去——像和时间打架。

3. 切块切碎了跨文件的不变量

权限检查在过滤器里,业务决策在 Service 里,审计在 AOP 里。切成 500 token 的块后,任何一块都“看起来合理”,拼起来却丢了约束。模型会基于局部合理的片段做局部合理的修改,整体失序——这和“AI 编程的混沌风险”是同一类病。

4. 把检索当成唯一上下文来源

有的实现很激进:每一步都先 RAG,再让模型看检索结果,甚至不给“读文件”工具。这等于把 Agent 变成了“开卷考试但只准看书的目录”。短期 demo 好看,长期在真实仓库里会脆。
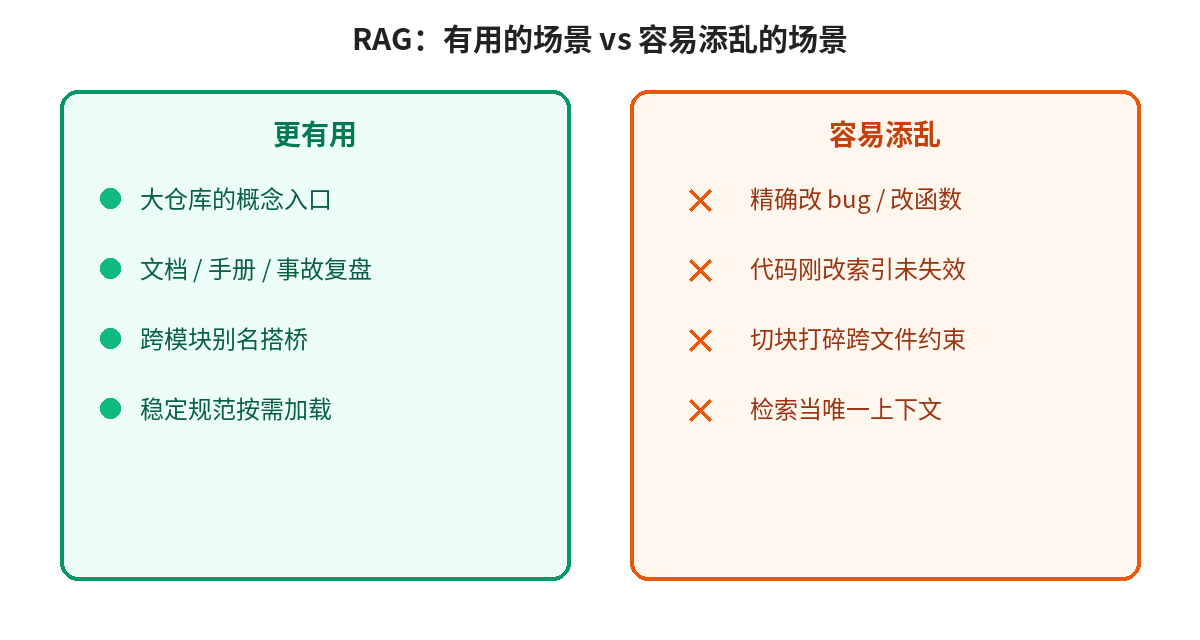
RAG 有用与添乱场景对照图

图片来源:原创示意图

我更常用的替代/组合策略

按优先级,我自己的 coding agent 大概是这样取上下文的:

  1. 任务相关文件由人指定或由上一步改动列表确定(最高信噪比)。
  2. 符号搜索 / 精确 grep(找定义、找引用)。
  3. 必要时再语义检索文档和 ADR。
  4. 跑测试与类型检查,用失败信息当“反向检索”。
  5. 最后才扩大到“整库问答式 RAG”。

一句话:能精确就精确,不能精确再语义;语义结果必须能被文件读取验证。

如果一定要上代码 RAG,我会加几条硬规则:

  • 检索结果必须带来源路径和行号;
  • Agent 改代码前必须 open 原文件,不能只凭块内容编辑;
  • 对当前 git 工作区改动过的文件,检索结果降权或直接禁用,改为读磁盘;
  • 索引版本与 commit 绑定,切换分支要能感知。

“检索质量”怎么快速自测

不用上很重的评估框架,先做几道小题:

  • 问一个你知道答案在 A.java 的问题,看 Top3 是否包含它;
  • 改一个函数签名后立刻问相关问题,看是否还返回旧签名;
  • 问一个需要跨 3 个文件才能答对的问题,看模型是否会去读那 3 个文件,而不是只根据块瞎编;
  • 故意检索一个已删除的概念,看系统会不会坦然说“找不到”,还是编造。

如果这几项挂得多,先别急着调 embedding 模型,先检查切块、失效策略和工具权限。

成本和复杂度,也是“添乱”的一种

RAG 不是免费的:切块管道、嵌入费用、向量库运维、权限过滤(别把私有模块检索进不该看的会话)、以及“为什么答错了”的可解释性成本。对小中型仓库,有时 目录约定 + 强搜索工具 + 短任务提示 就够了。

我现在的经验法则很土:

  • 仓库 < 某个你能用搜索翻熟的规模,优先工具;
  • 文档多、概念入口多、人员流动大,再加文档 RAG;
  • 代码 RAG 只在“搜索不够用”的痛点被反复证明后才上。

(具体规模阈值因语言和单体/多仓而异,我这里不报一个假装精确的数字。)

和 Agent 记忆的边界

有人把 RAG 当成长期记忆。我会拆开:

  • 仓库真相:以磁盘与版本控制为准;
  • 会话记忆:当前任务、用户偏好、已确认的决策;
  • 检索索引:可丢弃的加速结构。

三者混为一谈时,最常见的事故是:索引里的过时“记忆”覆盖了仓库真相。保持边界,能少很多玄学。

一个我关掉代码 RAG 的夜晚

有次做一个中等规模的 Java 单体改造,Agent 反复把一个已删除的 LegacyBillingClient 检索回来,坚决要“复用现成客户端”。我先调了 top-k、又调了切块大小,整晚都在和幽灵打架。后来我做了件很不优雅但有效的事:对 **/*.java 禁用向量检索,只保留文档 RAG,代码一律走路径与符号工具。

第二天改造顺了。不是 RAG 技术不行,是它在那个任务上的信噪比已经为负。能关掉,也是一种设计能力。

权限与 多租户:检索也要过安检

如果仓库或文档存在权限边界(内部 HR 文档、客户私有配置、未开源模块),RAG 必须在检索层做过滤,而不是指望模型“自己别看”。一次越权检索,比一次答错更严重。coding agent 连着开发者权限时尤其危险——它可能检索到你个人有权、但不应进入当前任务上下文的材料。

小结

RAG 很有用,但不是 coding agent 的身份证。它擅长把自然语言桥到文档和概念入口;在精确修改、高频变更、跨文件不变量这些事上,它经常添乱。

我愿意用它,也愿意关掉它。判断标准只有一个:它有没有让 Agent 更快地读到正确的文件,并且在文件被改脏之后还知道自己可能错了。 做不到这两点,再漂亮的向量库也只是噪声发生器。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

RAG 在 Coding Agent 里:什么时候有用,什么时候添乱

RAG 在 Coding Agent 里:什么时候有用,什么时候添乱

一提到让 Agent “懂我们的代码库”,很多人的第一反应是上 RAG:把仓库切块、嵌入、丢进向量库,提问时先检索再生成。听起来理所当然,我自己也做过。用下来的感受是:RAG 在 coding agent 里不是默认答案,而是一种有代价的缓存与索引策略。 用对了能省上下文、提高命中;用错了会检索到似是而非的片段,把模型带进沟里。

这篇文章想尽量说人话:哪些场景我愿意上 RAG,哪些场景我宁愿用“直接读文件 / 搜符号 / 开测试”的工具,以及怎么判断它在添乱。

Coding Agent 获取代码知识的几条路径优先级

图片来源:原创示意图

先把问题说清楚:Coding Agent 缺的是什么

Coding Agent 跟“企业内部知识问答”不一样。它通常已经有这些能力:

它缺的往往不是“百科”,而是:在正确的时刻拿到正确的那一小段代码,并且知道这段代码是否仍然有效。
向量检索擅长“语义相近”,不擅长“这个符号现在的定义在哪、这个接口会不会在下一行被覆盖”。

所以我把 RAG 当成补充通道,而不是主通道。

什么时候 RAG 真的有用

1. 大仓库里的“概念入口”

比如新人(或 Agent)问:“我们系统里的结算是怎么跑的?”
这不是一个精确符号问题,而是概念问题。仓库里可能有设计文档、ADR、若干 Service 入口。RAG 对这类“从自然语言概念跳到相关文件集合”很合适,能提供一张地图。

注意:地图之后,仍然要让 Agent 打开文件精读,而不是只凭检索片段改代码。

2. 文档、运行手册、历史事故复盘

Markdown、RFC、postmortem,天然适合切块检索。它们更新频率相对低,结构和人类提问方式接近。把“如何本地启动支付模块”“上次双十一超时怎么处理的”交给 RAG,往往比塞进系统提示词更干净。

3. 跨语言/跨模块的“别名世界”

业务里同一个东西可能叫 Customer、Buyer、uid、user_id。符号搜索对别名不友好时,语义检索有时能搭桥。但要把结果当线索,不当真理。

4. 提示词里塞不下的稳定规范

编码规范、安全基线、API 错误码表——内容稳、需要偶尔引用。RAG 或“按需加载的规则文件”都行,不一定非要向量库;有时目录约定 + 主动读取更简单。

什么时候 RAG 很容易添乱

1. 精确改bug、精确改函数

根因在 FooService#bar 第 128 行。这时最需要的是:打开该文件、看调用方、跑相关测试。向量检索可能带回三个“也叫 bar”的历史副本、一篇过时 wiki、一段相似但位于旧分支逻辑的代码。模型一旦被相似片段带偏,会改错地方还振振有词。

2. 代码刚被改过,索引还是旧的

这是 coding agent 场景的硬伤。Agent 自己刚重构完,RAG 还指着十分钟前的块。如果没有“写后失效 / 提交后重建”的纪律,检索结果就是过期新闻。我见过 Agent 一边改代码一边检索到旧实现,然后把旧逻辑又写回去——像和时间打架。

3. 切块切碎了跨文件的不变量

权限检查在过滤器里,业务决策在 Service 里,审计在 AOP 里。切成 500 token 的块后,任何一块都“看起来合理”,拼起来却丢了约束。模型会基于局部合理的片段做局部合理的修改,整体失序——这和“AI 编程的混沌风险”是同一类病。

4. 把检索当成唯一上下文来源

有的实现很激进:每一步都先 RAG,再让模型看检索结果,甚至不给“读文件”工具。这等于把 Agent 变成了“开卷考试但只准看书的目录”。短期 demo 好看,长期在真实仓库里会脆。

RAG 有用与添乱场景对照图

图片来源:原创示意图

我更常用的替代/组合策略

按优先级,我自己的 coding agent 大概是这样取上下文的:

  1. 任务相关文件由人指定或由上一步改动列表确定(最高信噪比)。
  2. 符号搜索 / 精确 grep(找定义、找引用)。
  3. 必要时再语义检索文档和 ADR。
  4. 跑测试与类型检查,用失败信息当“反向检索”。
  5. 最后才扩大到“整库问答式 RAG”。

一句话:能精确就精确,不能精确再语义;语义结果必须能被文件读取验证。

如果一定要上代码 RAG,我会加几条硬规则:

“检索质量”怎么快速自测

不用上很重的评估框架,先做几道小题:

如果这几项挂得多,先别急着调 embedding 模型,先检查切块、失效策略和工具权限。

成本和复杂度,也是“添乱”的一种

RAG 不是免费的:切块管道、嵌入费用、向量库运维、权限过滤(别把私有模块检索进不该看的会话)、以及“为什么答错了”的可解释性成本。对小中型仓库,有时 目录约定 + 强搜索工具 + 短任务提示 就够了。

我现在的经验法则很土:

(具体规模阈值因语言和单体/多仓而异,我这里不报一个假装精确的数字。)

和 Agent 记忆的边界

有人把 RAG 当成长期记忆。我会拆开:

三者混为一谈时,最常见的事故是:索引里的过时“记忆”覆盖了仓库真相。保持边界,能少很多玄学。

一个我关掉代码 RAG 的夜晚

有次做一个中等规模的 Java 单体改造,Agent 反复把一个已删除的 LegacyBillingClient 检索回来,坚决要“复用现成客户端”。我先调了 top-k、又调了切块大小,整晚都在和幽灵打架。后来我做了件很不优雅但有效的事:对 **/*.java 禁用向量检索,只保留文档 RAG,代码一律走路径与符号工具。

第二天改造顺了。不是 RAG 技术不行,是它在那个任务上的信噪比已经为负。能关掉,也是一种设计能力。

权限与 多租户:检索也要过安检

如果仓库或文档存在权限边界(内部 HR 文档、客户私有配置、未开源模块),RAG 必须在检索层做过滤,而不是指望模型“自己别看”。一次越权检索,比一次答错更严重。coding agent 连着开发者权限时尤其危险——它可能检索到你个人有权、但不应进入当前任务上下文的材料。

小结

RAG 很有用,但不是 coding agent 的身份证。它擅长把自然语言桥到文档和概念入口;在精确修改、高频变更、跨文件不变量这些事上,它经常添乱。

我愿意用它,也愿意关掉它。判断标准只有一个:它有没有让 Agent 更快地读到正确的文件,并且在文件被改脏之后还知道自己可能错了。 做不到这两点,再漂亮的向量库也只是噪声发生器。


RAG 在 Coding Agent 里:什么时候有用,什么时候添乱2026-10-10鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论