
做 Agent 久了会发现:模型“聪不聪明”常常不是瓶颈,工具好不好用才是。同一个模型,换一套清晰的工具契约,成功率能差一截;换一套含糊的,它就会在重试里空转,或者把半成功当成成功继续往下跑。
我踩过的坑大多长这样:工具返回一句 "failed",模型不知道是参数错了、权限不够,还是下游超时;于是它换个说法再调一次,参数其实没变。或者工具抛了未捕获异常,框架把它变成空字符串,模型以为“没结果”就去编造。
这篇文章只谈两件事:参数怎么设计,以及错误怎么返回,让工具对模型可观测、对系统可重试。
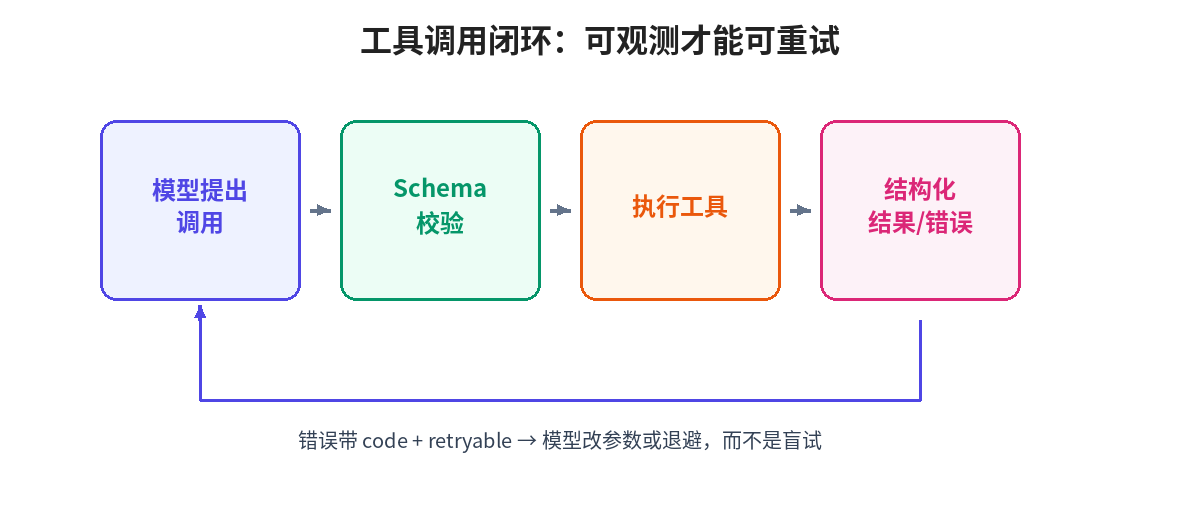
图片来源:原创示意图
参数:先让“非法输入”进不来
1. 用明确类型和枚举,少用自由文本
能用枚举就别用字符串。比如 priority: "high"|"normal"|"low",不要 priority: string 然后在文档里写“建议传 high”。模型很会发明 "urgent"、"最高"、"P0"。
日期时间也一样:约定 ISO-8601(并写明时区),比 “传个时间” 靠谱得多。金额用整数分,而不是浮点字符串。
2. 必填与选填要诚实
我见过把三个字段都标成可选,结果模型每次只填其中一个,工具内部再猜。短期好像灵活,长期全是分支地狱。原则是:
- 完成一次有效调用的最小集合标必填;
- 真正可选的才可选,并写默认值行为;
- 互斥参数用 oneOf / 明确文档说明,而不是三个都可选再在代码里 if-else。
3. 给字段写“给模型看的”描述,不是给人类看的注释
user_id: 用户 ID 不够。更好的是:
user_id: 业务用户的稳定 ID,形如u_xxx。不要传手机号或昵称。若调用方只有订单号,请先调用find_user_by_order。
这种描述会显著减少“拿错标识符”的调用。多花 30 秒写描述,少花 30 分钟看错误日志。
4. 限制副作用范围
写操作的工具,参数里最好有显式的确认或预览模式,例如 dry_run: boolean。第一次让模型 dry_run=true 看计划,再真正执行。不是所有场景都需要,但涉及删除、转账、广播时,我几乎总会加。
返回值:成功和失败都要结构化
我对工具返回的最低要求是:永远返回机器可读的结构,不要有时 JSON、有时纯文本、有时抛异常到框架外。
一个我常用的形状(示意,不是标准):
{
  "ok": false,
  "error": {
    "code": "RATE_LIMITED",
    "retryable": true,
    "message": "上游限流,建议 2s 后重试",
    "details": {"retry_after_ms": 2000}
  },
  "request_id": "req_..."
}
成功时:
{
  "ok": true,
  "data": { "...": "..." },
  "request_id": "req_..."
}
几个关键点:
ok布尔值:让模型先看这一个字段,再决定往下读。error.code稳定枚举:给程序和评估用,不要每次换措辞。retryable:直接告诉模型/框架能不能重试,避免它猜。message给人看,也给模型看:简短、可执行(“缺了字段 X”“状态不允许”)。request_id:排查时能把一次工具调用钉死。
错误分类:比“失败”两个字重要一万倍
我会把错误粗分成几类,并在文档和枚举里固定下来:
| 类型 | 例子 | retryable | 模型该怎么做 |
|---|---|---|---|
| 参数错误 | 缺字段、枚举非法 | false | 改参数,不要原样重试 |
| 权限/鉴权 | token 过期、无权限 | false(除非刷新令牌是另一工具) | 换工具或上报人工 |
| 状态冲突 | 订单已取消还要发货 | false | 改计划或询问用户 |
| 限流/超时 | 429、上游超时 | true | 退避重试 |
| 下游 5xx | 依赖故障 | true(有上限) | 退避,或降级路径 |
| 部分成功 | 批量里成功 3 失败 2 | false(需特殊处理) | 读 details,不要整批重放 |
部分成功最容易被忽略。如果工具可能部分成功,必须在契约里写清楚,并返回足够信息让上层做幂等补偿。绝不能只回一句 failed,否则模型一重试就可能重复下单。
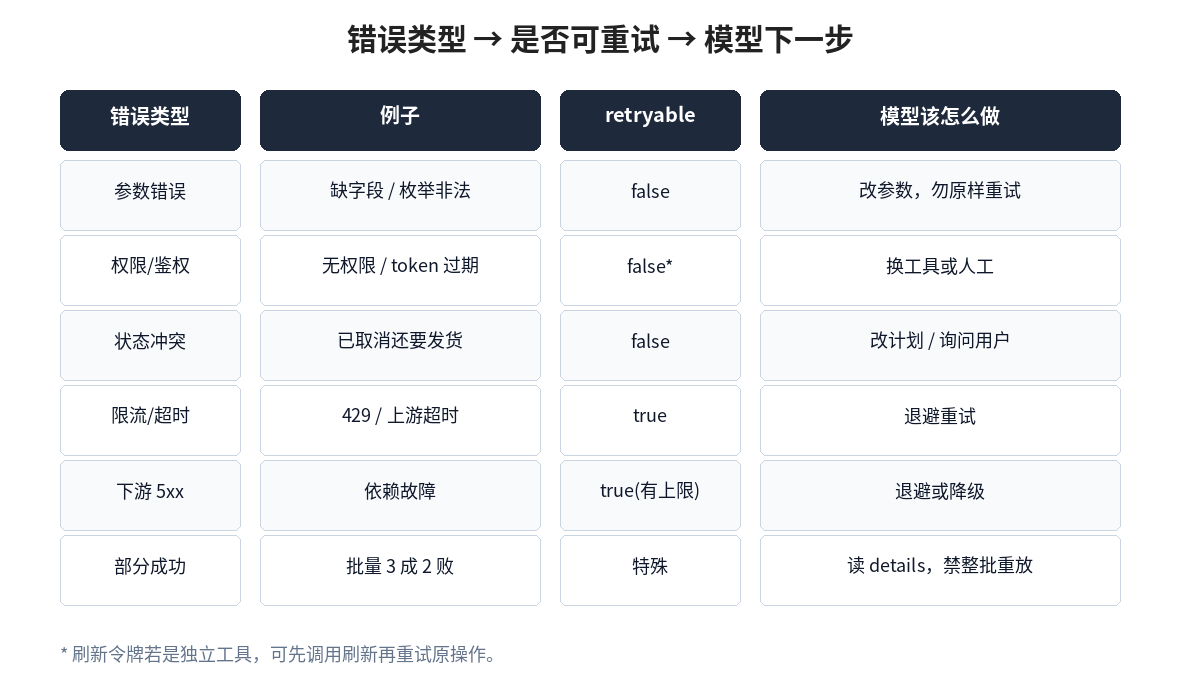
图片来源:原创示意图
可重试:工具侧和 Agent 侧要分工
工具侧:
- 对明确
retryable=true的错误,提供retry_after_ms或建议退避; - 写操作必须幂等(幂等键由调用方传入,或工具根据业务键去重);
- 超时要有上限,避免模型一边重试一边堆积。
Agent / 框架侧:
- 尊重
retryable,不要对参数错误死磕三次; - 重试时带上同一幂等键;
- 超过次数就升级:换策略、换工具、或人工。
我见过框架对所有失败统一重试 3 次,结果把“缺字段”也重试三遍——纯粹浪费 token,还把日志打爆。
参数校验失败,也要返回得漂亮
很多实现会在进模型前做 JSON Schema 校验,失败了直接抛给框架。更好的做法是:把校验错误变成一次“工具结果”,结构与运行时错误一致,code=INVALID_ARGUMENT,details 里列出字段级错误。
这样模型能在同一套协议下学习“怎么改参数”,而不是看到一坨堆栈或空响应。
示意:
{
  "ok": false,
  "error": {
    "code": "INVALID_ARGUMENT",
    "retryable": false,
    "message": "参数不合法",
    "details": {
      "fields": [
        {"path": "priority", "issue": "必须是 high|normal|low,收到 urgent"}
      ]
    }
  }
}
文档、示例、反例,三位一体
工具描述里我尽量固定三段:
- 什么时候用 / 什么时候别用;
- 一个成功调用的完整示例;
- 两个常见失败示例(参数错误 + 状态冲突)。
反例特别有用。模型很会模仿文档里的形状;你把失败示例写清楚,它更少发明奇异参数。
和可观测性的关系
约定不只是给模型看的,也是给人和系统看的:
- 每次调用打点:
tool_name、ok、error.code、耗时、request_id; - 评估时按
error.code聚合,而不是按自由文本; - 线上告警盯
retryable=true的比例突然升高(依赖故障),以及INVALID_ARGUMENT突然升高(提示词/文档漂移)。
没有稳定错误码,你的 Agent 评估集会很难做——这正好接到更深的话题:评估与回归。但那是后话。此刻只要记住:工具契约是 Agent 系统的 API,值得像对公开 API 一样认真。
一张我自己用的检查清单
发新工具前问自己:
- 非法参数能在 schema 层拦住吗?
- 成功/失败是同一套结构吗?
- 错误有稳定
code和retryable吗? - 写操作有幂等键吗?
- 部分成功有没有被定义?
- 描述里有没有“别用的时候”和失败示例?
- 日志里能否用
request_id串起一次调用?
全部是“是”,才算能给模型用。否则它不是工具,是陷阱。
一个反面教材:返回 HTML 错误页
有一次下游网关故障,工具把 502 的 HTML 页面原样塞进了 data。模型居然开始“解读”那段 HTML,还总结出“服务器正在维护,建议稍后再试”——然后它真的稍后再试了二十多次。
修复很简单:HTTP 非 2xx 一律进入 ok=false 分支;body 只保留截断后的文本进 details.raw_excerpt(比如前 200 字符),并映射到 UPSTREAM_ERROR。模型不再阅读 HTML,框架按 retryable=true 做有限退避。
教训:不要让模型当 HTML 解析器,也不要把传输层失败伪装成业务数据。
版本与兼容
工具参数会演进。我倾向于:
- 加可选字段:可以,文档写清默认行为;
- 改枚举含义:不行,宁可加新枚举值;
- 删除字段:先标记废弃一轮,评估集里盯旧字段使用率。
Agent 的提示词和工具 schema 经常不同步。发版时把 schema 版本号打进返回值或日志,能少抓很多头发。
和提示词工程的分工
有人把所有约束写进系统提示词:“如果工具失败,请判断是否重试……”——能用,但不稳。模型对长提示词的遵守是概率性的;对结构化字段 retryable 的遵守,可以落成代码。
我的分工是:
- 提示词:何时调用哪个工具、业务偏好、语气;
- 工具契约:参数形状、错误码、是否可重试、幂等;
- 框架策略:退避、次数上限、人工升级。
能下沉到契约和框架的,就不要只写在提示词里。提示词适合表达“软偏好”,不适合当唯一的安全网。
小结
模型会犯错,工具不能火上浇油。把参数说死、把错误说清、把能否重试说明白,Agent 才会像个能协作的系统,而不是一个会打电话但听不懂忙音的人。这些约定看起来像“无聊的后端活”,但在 Agent 项目里,它们往往比换一个更贵的模型更值钱。
 2026-10-10鱼鱼