
用 AI 写业务代码越来越顺手之后,下一件很自然的事就是:让它把测试也补上。说实话,这一步的爽感很强——几分钟冒出一堆 should_xxx,覆盖率数字往上跳,CI 绿灯。问题也正好出在这里:绿灯不等于有保险。
我经历过一次挺丢脸的事。AI 帮我补了十几个单测,覆盖率从 40% 拉到 75%,合并后第三天生产就炸了。回头看测试,几乎每个都在验证“mock 对象有没有按我设定的方式被调用”,真正的业务不变量一个都没钉住。测试在保护 mock,不在保护系统。
这篇文章想说清楚三件事:哪些测例我愿意交给 AI;哪些我坚持人手写;以及怎么减少“假绿”。
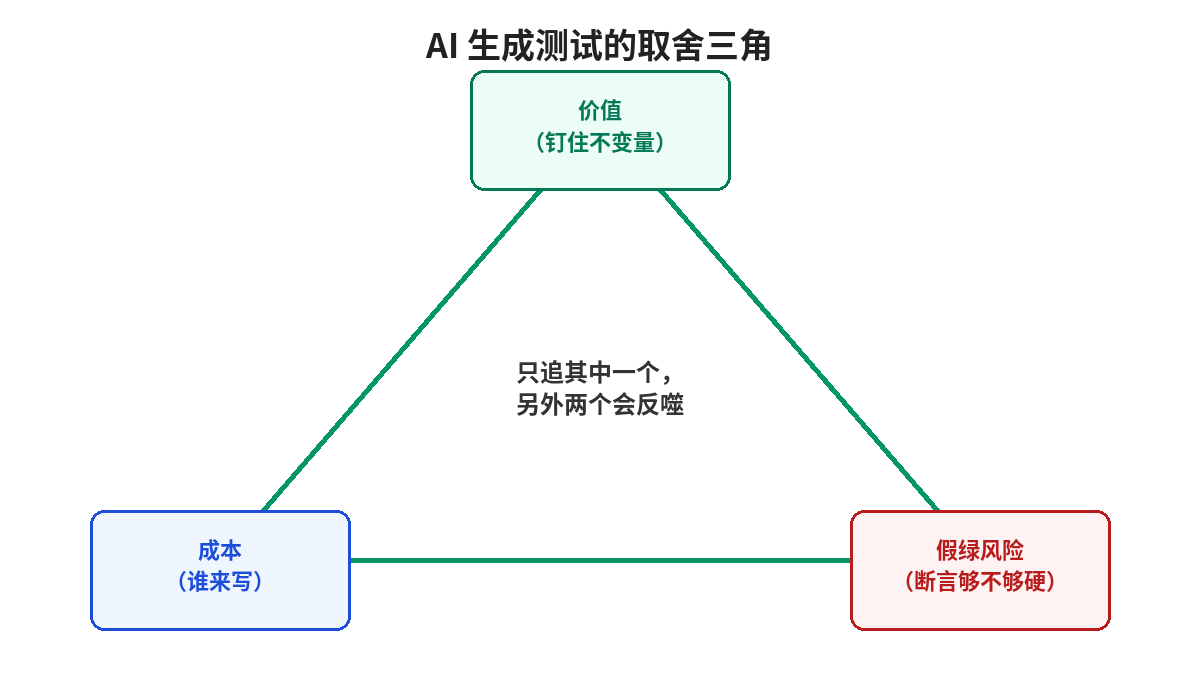
图片来源:原创示意图
先承认:AI 写测试确实有它擅长的部分
我不想装清高。下面这些,我现在经常让 AI 先起草,我再改:
- 纯函数的表驱动用例:输入输出清楚、边界好枚举的,比如金额计算、状态机合法迁移、字符串规范化。
- 对已有行为的回归快照:我已经有一个手工确认过的“正确输出”,让它把输入输出对写成参数化测试。
- 无聊但必需的样板:启动 Spring 上下文的烟雾测试、DTO 序列化往返、校验注解是否生效。
- 把自然语言验收标准翻译成测试骨架:我写 Given/When/Then,它填断言框架和数据构造。
共同特点是:正确性标准在我脑子里已经清楚,AI 负责降低打字成本,而不是替我发现需求。
哪些测试我几乎不让 AI“做主”
1. 定义核心不变量的测试
比如“退款金额不能超过已支付且未退款部分”、“同一幂等键第二次调用必须返回第一次的结果”。这类测试写的是产品合同。如果让 AI 根据实现来“反推”测试,它会很忠实地把实现里的 bug 也固化下来。
我的做法是:人先写 1~3 个核心断言(哪怕很丑),再让 AI 在这个方向上补充边界。顺序不能反。
2. 涉及时间、并发、对外 IO 的测试
AI 很爱写 Thread.sleep、固定时钟假设、以及“验证某个外部客户端被调用了一次”的交互式测试。这些测试脆弱、慢,而且经常在 CI 上抖动。我更希望看到:用可控的时钟、用假的时间源、用状态断言代替交互断言。
3. 用来证明“不会再发生某次事故”的测试
事故回归测试有纪念意义,也有工程意义。它的输入往往来自真实工单里的脏数据。AI 不知道那次事故的叙事,容易写成一个“看起来相关但抓不住复现条件”的用例。这类我通常自己写,或至少自己把复现数据整理好再交给它填框架。
“假绿”是怎么来的
我把常见假绿分成几类,方便自查:
- 断言太弱:只断言
notNull、status == 200、列表非空。AI 特别喜欢这类“不会失败的成功”。 - 测到了 mock,而不是测到了行为:
verify(service).doSomething()通过了,但真正的计算结果错了。 - 用实现细节当契约:断言私有方法调用顺序、内部缓存是否命中。实现一重构,测试全红,但业务没变——反过来,业务变了,测试还可能绿。
- 把随机性/时间写死失败:本地绿、CI 红,或者“重试几次就过”。这不算假绿,但是假安全感的近亲。
- 删掉或跳过难写的用例:偶尔能在 AI 的补丁里看到
@Disabled、“暂时跳过”、把断言改成注释。这比假绿更糟,是直接卸保险。
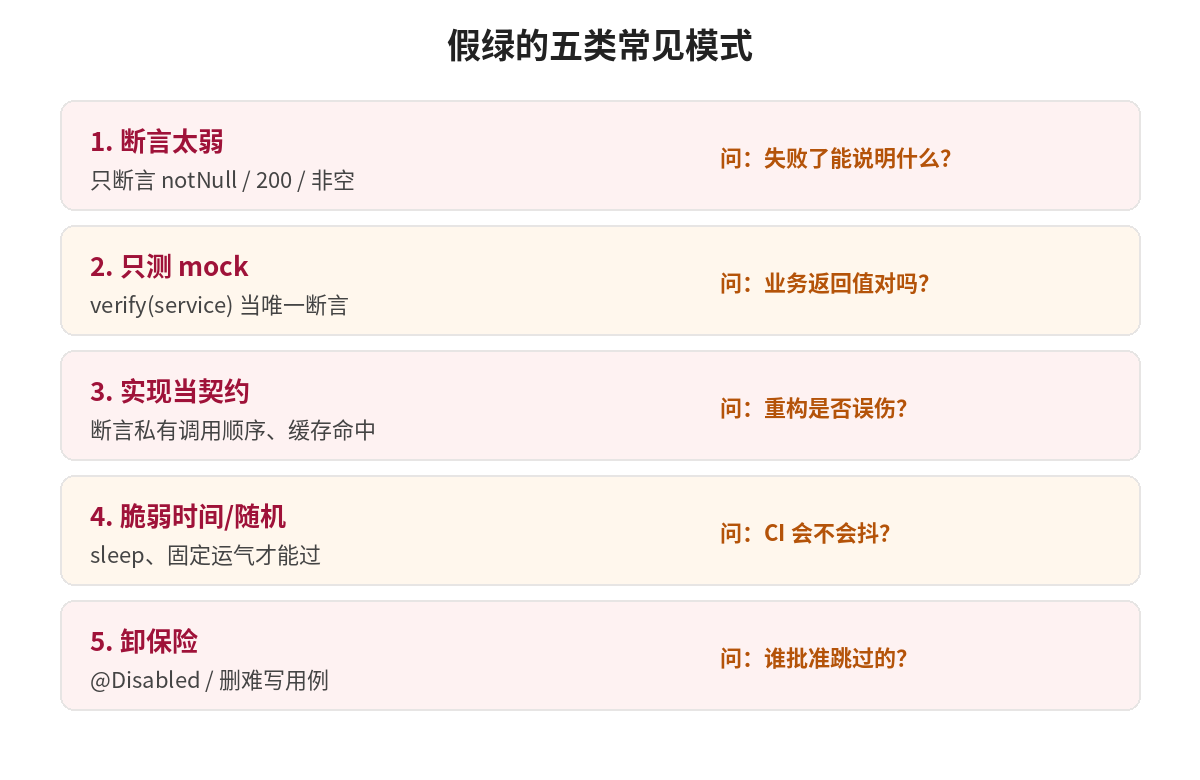
图片来源:原创示意图
我现在的取舍流程
可以粗暴理解成一条流水线:
- 我先写“验收句子”:用中文写 3~5 条“系统必须保证……”。
- 挑 1 条最关键的,人手写成测试(允许很短)。
- 再让 AI 扩展:边界值、非法输入、幂等第二次调用等。
- 审查时只盯三件事:断言是否钉住不变量、是否在测 mock、有没有 sleep/随机/过宽匹配。
- 跑一次“变异检查”(手工版):我故意改一行业务代码,看测试会不会红。如果我把关键逻辑改坏了测试还不红,这批测试就该重写,而不是庆祝覆盖率。
第 5 步不需要上完整的 mutation testing 工具(当然有条件上更好)。哪怕每次只改一个 if 条件,也能揭穿很多装饰性测试。
给 AI 的提示词,我会写得很“凶”
语气温和没有用,约束要硬:
根据下面的验收句子补充测试,要求:
1. 禁止只断言 notNull / 不抛异常 / HTTP 200。
2. 禁止 verify(mock) 作为唯一断言;必须断言业务可见的返回值或持久化结果。
3. 禁止 Thread.sleep;时间用可控时钟。
4. 不要为了让测试通过而修改业务代码;若实现与验收冲突,先停下来问我。
5. 每个用例名用业务语言,不要用 test1/test2。
验收句子:
- …
有一次我忘了写第 4 条,它非常“热心地”把业务代码改成了更容易测的形状——顺便改掉了一个边界行为。从此第 4 条成了固定台词。
覆盖率怎么看,才不会被骗
覆盖率对我来说只是“地图上的空白”,不是分数。我会看:
- 哪些核心模块仍然是白的:优先补。
- 哪些模块覆盖率很高但都是弱断言:宁可标成技术债,也不要自我感动。
- 新增代码的差分覆盖:比整体数字更有意义。
如果团队把覆盖率当 KPI,AI 会成为刷分神器。这不是 AI 的错,是激励的错。我能做的是在自己负责的模块里,坚持“先不变量,后覆盖率”。
什么时候我反而会多让 AI 写测试
也有相反的场景:重构前需要一张保护网,而原有测试很少。这时我会让 AI 大量生成表征测试(characterization tests)——先把当前行为钉住,再重构。注意:这类测试的目的是“锁住现状”,不是“证明正确”。合并前我会在注释或文档里写明这一点,避免后来的人误以为这些断言代表业务正确性。
表征测试是梯子,不是房子。用完可以拆一批,留下真正的不变量测试。
一个具体例子:退款接口
假设接口是“按订单退款”,核心不变量有三条:
- 退款总额不超过可退余额;
- 同一
idempotency-key重复请求结果一致; - 退款成功必须落库且发出领域事件(至少一次)。
我自己会先写第 1、2 条的测试。第 3 条如果用 outbox 表,也可以先写“outbox 里有对应记录”。然后才让 AI 补充:余额为 0、超额 1 分钱、并发两个相同 key、已取消订单等边界。
如果一上来就说“帮我把 RefundService 测试补全”,它往往会生成一堆:
- mock 了
PaymentClient,verify 调用次数; - 断言返回对象的某个内部字段不为 null;
- 用固定 UUID,但从不验证幂等键是否参与查询。
看起来很多,真正挡住回归的很少。例子越具体,越能看出“数量”和“质量”不是一回事。
和 Code Review 清单怎么配合
上一篇里我写过 Review AI 代码要先看测试有没有被改松。生成测试时,审查清单可以更短:
- 有没有删除旧断言?
- 有没有把精确断言改成模糊断言?
- 新增用例是否只在“快乐路径”打转?
- 失败消息是否读得懂(将来 CI 红了要靠它定位)?
我特别看重失败消息。AI 写的 assertEquals(a,b) 一旦失败,常常只剩两个谁也看不懂的对象 dump。花 30 秒改成带业务语义的消息,长期很值。
和“表征测试”相处的分寸
表征测试很适合重构前的保护网,但也容易变成永久居民。我会在用例名或注释里标 characterization,并设一个回顾点:重构结束后,把其中能升级成不变量的留下来,其余删掉或合并。否则半年后仓库里会堆满“锁住偶然行为”的测试,反而阻碍正当变更。
收个尾
AI 写测试的能力,已经强到足够制造安全感了。这正是它危险的地方。我的取舍很朴素:
- 标准清晰、机械重复的,交给它。
- 定义系统是什么的,留在自己手里。
- 任何看起来太容易绿的测试,都值得怀疑一次。
覆盖率可以涨,但保险柜的钥匙不能只挂在绿灯上。
 2026-10-10鱼鱼