
第一次用 AI 改 bug 的真实节奏

  created  by  鱼鱼 {{tag}}
创建于 2026年10月10日 14:40:23 最后修改于 2026年10月10日 14:40:23

第一次认真用 AI 改 bug,不是那种“帮我写个排序”的玩具题,是线上真出了问题:某个接口偶发超时,日志里只有一句 Read timed out,复现不稳。我那会儿把堆栈和一段相关代码扔给 AI,它很快给了一版“优化建议”——加超时、加重试、换连接池参数。看起来很专业,我差点就合进去了。

后来自己又翻了半小时才发现:真正的原因是下游在高峰时返回了一个空 body,客户端按固定 schema 去解析,偶发抛异常,异常被上层吞掉,最终表现为超时。AI 那套建议能“缓解症状”,但治不了病,还可能把问题藏得更深。

这篇文章想写的,是我后来慢慢摸出来的一套节奏:怎么描述现象、给什么上下文、什么时候该自己看代码。不是标准答案,是踩坑后的习惯。
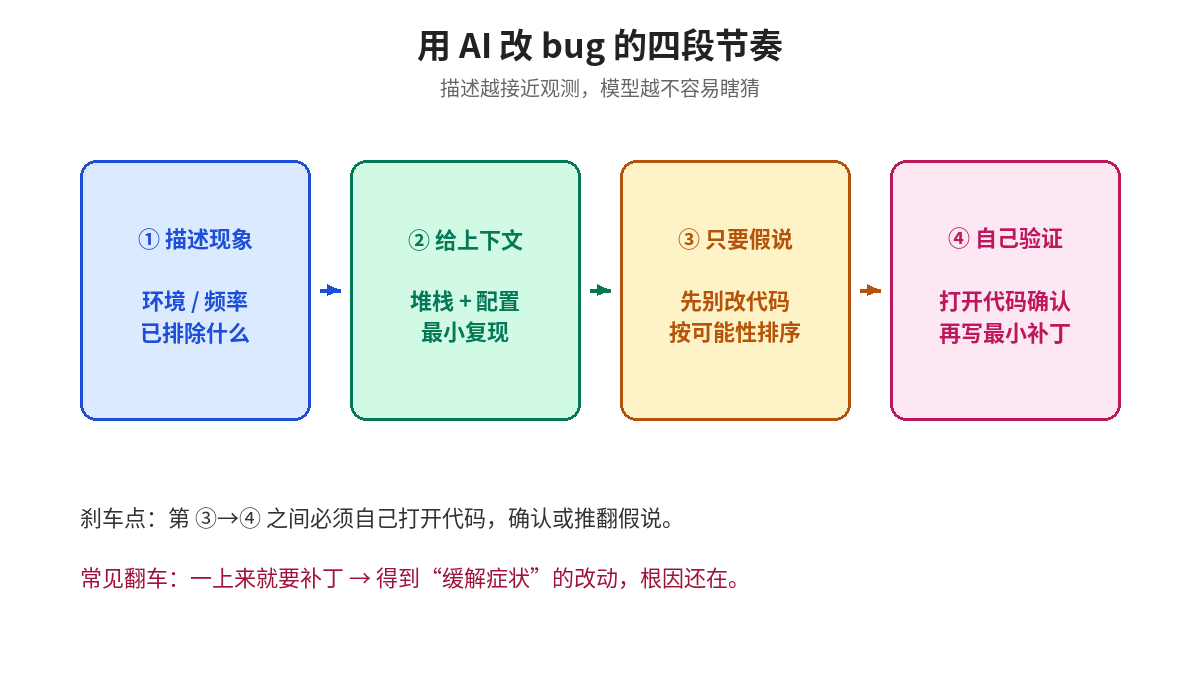
用 AI 改 bug 的四段节奏示意图

图片来源:原创示意图

先把“现象”说清楚,别一上来就给结论

很多人(包括曾经的我)跟 AI 说话,习惯直接给诊断:

这个接口超时了,是不是连接池不够?帮我改一下。

这句话有两个坑。第一,你已经替模型做了归因,它会顺着你的归因往下走,很少主动质疑。第二,“改一下”太模糊,它不知道你要的是排查路径,还是直接给补丁。

我现在会强迫自己按这个模板说现象:

  1. 谁在什么环境下看到了什么:哪个服务、哪个接口、哪个环境、大概什么时间段。
  2. 稳定还是偶发:十次里几次、是否跟流量/特定参数相关。
  3. 已经排除了什么:不是 DNS、不是网关 5xx、下游健康检查是绿的……
  4. 你现在卡住的具体点:是找不到入口,还是怀疑某段逻辑但不敢动。

示例(脱敏后的真实风格):

生产环境 order-query 的 /v1/orders/{id} 在 19:00–21:00 偶发失败,客户端报 Read timed out,服务端 access log 里对应请求耗时 3s 左右就返回了 200,但 body 为空。同时间段其它接口正常。我已经确认下游 payment 的健康检查是绿的,也排除了网关超时。我卡住的点是:服务端明明返回了,客户端为什么会当成超时?

你会发现,一旦现象说清楚,AI 的第一反应往往会变成“我们先对齐调用链和超时配置”,而不是上来改连接池。描述越接近观测,模型越不容易瞎猜。

上下文怎么给:少而准,比多而杂更重要

我见过两种极端。一种是只丢一行报错,模型只能空转;另一种是把半个仓库粘进去,模型在噪声里迷路。我现在的做法更像“给一位远程同事发排查包”:

  • 最小复现:能本地复现就给复现步骤;不能复现就给一次失败请求的关键字段(去掉敏感信息)。
  • 出错栈 + 前后 30 行:不是整个类。栈顶那几个 frame 往往比“相关模块全贴”更有用。
  • 配置里跟超时/重试相关的几项:客户端 timeout、服务端 readTimeout、网关、负载均衡,各写一行现值。
  • 你已经试过但没用的方向:避免它重复你走过的冤枉路。

有个反直觉的点:不要急着把“你觉得相关的业务背景小说”写很长。 业务背景有用,但应放在现象和栈之后,当作补充,而不是开头的长篇设定。模型对“设定”很顺从,对“观测”更敏感——至少在改 bug 这种任务上是这样。

我还会明确告诉它角色边界:

先不要直接改代码。先给出 3 个按可能性排序的假说,每个假说对应要看的日志字段或代码位置。等我确认后再写补丁。

这句话能省掉很多“直接开改、改完发现方向错了”的来回。
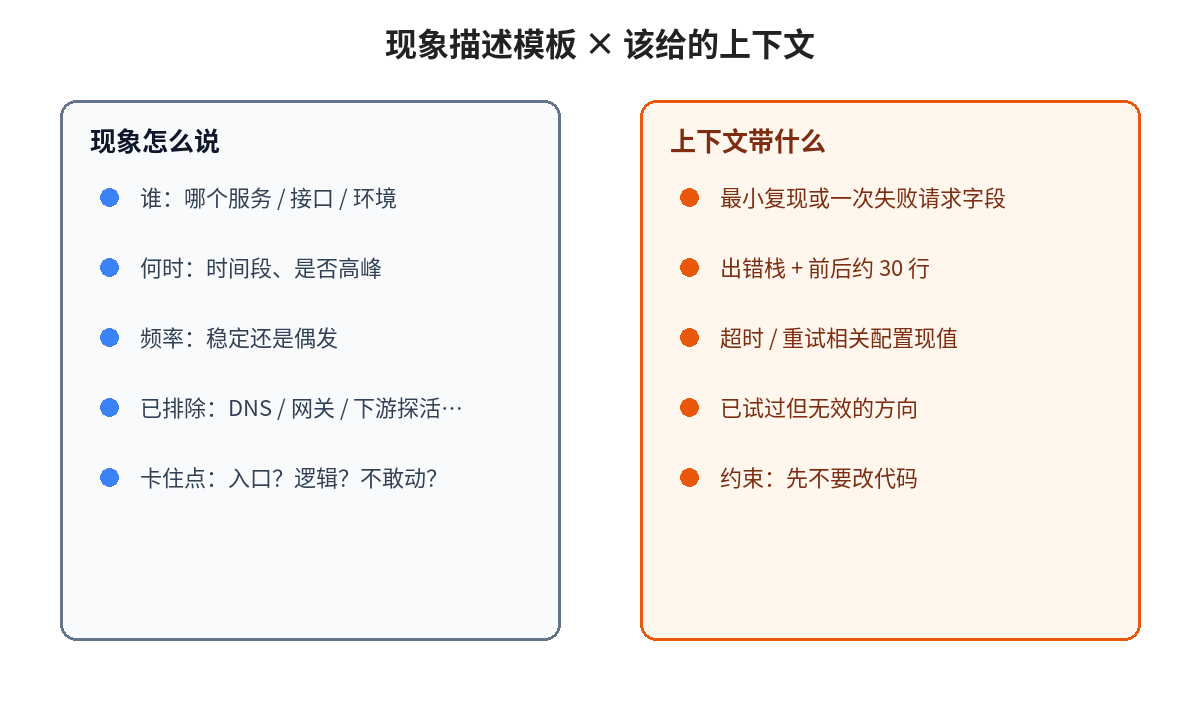
现象描述模板与该给的上下文清单

图片来源:原创示意图

让它提案,但别让它直接合进主干

AI 擅长在给定假说下生成补丁,不擅长替你承担“这个假说对不对”的责任。所以我的节奏通常是:

  1. 要假说,不要补丁(第一轮)。
  2. 针对 Top1 假说,让它指出该打开哪个文件、搜哪个关键字(第二轮)。
  3. 我自己打开代码,确认或推翻(这一步不能省)。
  4. 确认后,再让它在指定范围内写最小改动(第三轮)。
  5. 我跑测试 / 本地复现,再决定是否继续。

第三步是整条链路的刹车。有几次我跳过了“自己看”,直接让它改,结果它很自信地重构了错误处理,把原来能暴露问题的异常变成了默认值。测试还是绿的——因为测试本来就没覆盖那种空 body。

还有一个小习惯:要求补丁说明里写清 “改了什么 / 没改什么 / 如何验证”。如果它写不出可执行的验证步骤,多半说明它对问题的理解还飘着。

什么时候该自己看代码

不是矫情,是分工。下面这些情况,我会把键盘拿回来:

  • 涉及钱、权限、数据删除、幂等:再小的改动也自己过一遍。
  • 异常被吞、返回默认值、catch 后继续:AI 很爱写“温柔”的错误处理,这往往是线上最难查的一类。
  • 并发、缓存、超时叠加:模型容易给出“加锁 / 加缓存 / 加大超时”的万金油,需要人判断会不会掩盖根因。
  • 你看不懂它的改动:这不是谦虚,是硬条件。看不懂就不要合。

反过来,这些事我很乐意交给 AI:

  • 在陌生代码里按关键字定位调用链。
  • 把一段晦涩逻辑翻译成“人话”,帮我建立心理模型。
  • 在我指定的函数里写回归测试骨架。
  • 对比两份配置差异、整理时间线。

一个我现在常用的对话骨架

可以直接抄改:

【现象】(环境 / 接口 / 频率 / 已排除)
【证据】(关键日志 10~30 行 / 堆栈 / 配置现值)
【目标】先给 3 个假说(按可能性),每个假说写:
  - 为什么可能
  - 要看哪个文件或哪条日志才能证实/证伪
  - 若证实,最小改动大概在哪
【约束】先不要改代码;不要引入新依赖;不要扩大超时来“解决”问题。

等假说对上了,再追加:

假说 2 已确认(附上我看到的代码片段)。
请只在 XxxService#yyy 内做最小修复,并补充一个能抓住空 body 的测试。
列出改动说明与本地验证步骤。

两个我真实踩过的坑

坑一:把“缓解”当成“修复”。
AI 很擅长给出防御性编程:加判空、加重试、加兜底返回值。这些东西在评审里常常显得很负责,但在排查阶段很危险——它们会让原本能冒出来的信号消失。我的规则是:在根因确认前,不接受“吞掉异常并返回默认值”这类改动;临时缓解可以,但必须标成临时,并挂上跟进项。

坑二:上下文里混进过时结论。
有一次我把上周的排查笔记一并贴进去,里面写着“怀疑是 Redis 抖动”。模型后半段几乎全程围着 Redis 转,哪怕新日志已经不太支持这个方向。后来我改成:上下文只保留当前仍成立的事实,过时假说单独写在“已排除”里。模型立刻老实多了。

和“让 AI 写新功能”的节奏不一样

写新功能时,你可以容忍多轮返工,目标相对清晰。改 bug 时,目标是“找到并证明根因”,每走错一步都会污染现场——多出来的日志、被改过的配置、被“优化”过的错误处理,都会让下一轮更难判断。

所以我把 AI 在改 bug 里的权限收得更紧:先读、先定位、先提假说;写补丁要晚、要小、要可验证。新功能开发里我可以更大胆地让它起草;线上排障里我更像一个谨慎的值班人。

最后想说的

用 AI 改 bug,最容易高估的是“它给出补丁的速度”,最容易低估的是“你描述现象的质量”。模型不是没有用,它非常有用——但在排查这件事上,它更像一个反应很快、偶尔会顺着你跑偏的结对伙伴。

你负责把世界说清楚,它负责在说清楚的世界里搜索与起草。顺序反了,就会得到一堆看起来很专业、却在给错误治疗的建议。我现在改 bug 变慢了一点点,但返工少了很多。这点慢,我觉得值。
评论区
评论
{{comment.creator}}
{{comment.createTime}} {{comment.index}}楼
评论

第一次用 AI 改 bug 的真实节奏

第一次用 AI 改 bug 的真实节奏

第一次认真用 AI 改 bug,不是那种“帮我写个排序”的玩具题,是线上真出了问题:某个接口偶发超时,日志里只有一句 Read timed out,复现不稳。我那会儿把堆栈和一段相关代码扔给 AI,它很快给了一版“优化建议”——加超时、加重试、换连接池参数。看起来很专业,我差点就合进去了。

后来自己又翻了半小时才发现:真正的原因是下游在高峰时返回了一个空 body,客户端按固定 schema 去解析,偶发抛异常,异常被上层吞掉,最终表现为超时。AI 那套建议能“缓解症状”,但治不了病,还可能把问题藏得更深。

这篇文章想写的,是我后来慢慢摸出来的一套节奏:怎么描述现象、给什么上下文、什么时候该自己看代码。不是标准答案,是踩坑后的习惯。

用 AI 改 bug 的四段节奏示意图

图片来源:原创示意图

先把“现象”说清楚,别一上来就给结论

很多人(包括曾经的我)跟 AI 说话,习惯直接给诊断:

这个接口超时了,是不是连接池不够?帮我改一下。

这句话有两个坑。第一,你已经替模型做了归因,它会顺着你的归因往下走,很少主动质疑。第二,“改一下”太模糊,它不知道你要的是排查路径,还是直接给补丁。

我现在会强迫自己按这个模板说现象:

  1. 谁在什么环境下看到了什么:哪个服务、哪个接口、哪个环境、大概什么时间段。
  2. 稳定还是偶发:十次里几次、是否跟流量/特定参数相关。
  3. 已经排除了什么:不是 DNS、不是网关 5xx、下游健康检查是绿的……
  4. 你现在卡住的具体点:是找不到入口,还是怀疑某段逻辑但不敢动。

示例(脱敏后的真实风格):

生产环境 order-query 的 /v1/orders/{id} 在 19:00–21:00 偶发失败,客户端报 Read timed out,服务端 access log 里对应请求耗时 3s 左右就返回了 200,但 body 为空。同时间段其它接口正常。我已经确认下游 payment 的健康检查是绿的,也排除了网关超时。我卡住的点是:服务端明明返回了,客户端为什么会当成超时?

你会发现,一旦现象说清楚,AI 的第一反应往往会变成“我们先对齐调用链和超时配置”,而不是上来改连接池。描述越接近观测,模型越不容易瞎猜。

上下文怎么给:少而准,比多而杂更重要

我见过两种极端。一种是只丢一行报错,模型只能空转;另一种是把半个仓库粘进去,模型在噪声里迷路。我现在的做法更像“给一位远程同事发排查包”:

有个反直觉的点:不要急着把“你觉得相关的业务背景小说”写很长。 业务背景有用,但应放在现象和栈之后,当作补充,而不是开头的长篇设定。模型对“设定”很顺从,对“观测”更敏感——至少在改 bug 这种任务上是这样。

我还会明确告诉它角色边界:

先不要直接改代码。先给出 3 个按可能性排序的假说,每个假说对应要看的日志字段或代码位置。等我确认后再写补丁。

这句话能省掉很多“直接开改、改完发现方向错了”的来回。

现象描述模板与该给的上下文清单

图片来源:原创示意图

让它提案,但别让它直接合进主干

AI 擅长在给定假说下生成补丁,不擅长替你承担“这个假说对不对”的责任。所以我的节奏通常是:

  1. 要假说,不要补丁(第一轮)。
  2. 针对 Top1 假说,让它指出该打开哪个文件、搜哪个关键字(第二轮)。
  3. 我自己打开代码,确认或推翻(这一步不能省)。
  4. 确认后,再让它在指定范围内写最小改动(第三轮)。
  5. 我跑测试 / 本地复现,再决定是否继续。

第三步是整条链路的刹车。有几次我跳过了“自己看”,直接让它改,结果它很自信地重构了错误处理,把原来能暴露问题的异常变成了默认值。测试还是绿的——因为测试本来就没覆盖那种空 body。

还有一个小习惯:要求补丁说明里写清 “改了什么 / 没改什么 / 如何验证”。如果它写不出可执行的验证步骤,多半说明它对问题的理解还飘着。

什么时候该自己看代码

不是矫情,是分工。下面这些情况,我会把键盘拿回来:

反过来,这些事我很乐意交给 AI:

一个我现在常用的对话骨架

可以直接抄改:

【现象】(环境 / 接口 / 频率 / 已排除)
【证据】(关键日志 10~30 行 / 堆栈 / 配置现值)
【目标】先给 3 个假说(按可能性),每个假说写:
  - 为什么可能
  - 要看哪个文件或哪条日志才能证实/证伪
  - 若证实,最小改动大概在哪
【约束】先不要改代码;不要引入新依赖;不要扩大超时来“解决”问题。

等假说对上了,再追加:

假说 2 已确认(附上我看到的代码片段)。
请只在 XxxService#yyy 内做最小修复,并补充一个能抓住空 body 的测试。
列出改动说明与本地验证步骤。

两个我真实踩过的坑

坑一:把“缓解”当成“修复”。
AI 很擅长给出防御性编程:加判空、加重试、加兜底返回值。这些东西在评审里常常显得很负责,但在排查阶段很危险——它们会让原本能冒出来的信号消失。我的规则是:在根因确认前,不接受“吞掉异常并返回默认值”这类改动;临时缓解可以,但必须标成临时,并挂上跟进项。

坑二:上下文里混进过时结论。
有一次我把上周的排查笔记一并贴进去,里面写着“怀疑是 Redis 抖动”。模型后半段几乎全程围着 Redis 转,哪怕新日志已经不太支持这个方向。后来我改成:上下文只保留当前仍成立的事实,过时假说单独写在“已排除”里。模型立刻老实多了。

和“让 AI 写新功能”的节奏不一样

写新功能时,你可以容忍多轮返工,目标相对清晰。改 bug 时,目标是“找到并证明根因”,每走错一步都会污染现场——多出来的日志、被改过的配置、被“优化”过的错误处理,都会让下一轮更难判断。

所以我把 AI 在改 bug 里的权限收得更紧:先读、先定位、先提假说;写补丁要晚、要小、要可验证。新功能开发里我可以更大胆地让它起草;线上排障里我更像一个谨慎的值班人。

最后想说的

用 AI 改 bug,最容易高估的是“它给出补丁的速度”,最容易低估的是“你描述现象的质量”。模型不是没有用,它非常有用——但在排查这件事上,它更像一个反应很快、偶尔会顺着你跑偏的结对伙伴。

你负责把世界说清楚,它负责在说清楚的世界里搜索与起草。顺序反了,就会得到一堆看起来很专业、却在给错误治疗的建议。我现在改 bug 变慢了一点点,但返工少了很多。这点慢,我觉得值。


第一次用 AI 改 bug 的真实节奏2026-10-10鱼鱼

{{commentTitle}}

评论   ctrl+Enter 发送评论