
一个 Agent 跑到第 37 步,这时候部署系统滚动发布,Pod 被重启了。或者模型接口突然开始返回 429,重试几次之后放弃了。又或者它走到“给客户发邮件”这一步,按规定要等主管审批,而主管这会儿在开会,三个小时后才能看手机。
这些时候你该怎么办?从头再跑一遍吗?
前 36 步花掉的 token 和时间先不说,更要命的是,前面那些步骤里,如果有“发了邮件”“建了工单”“扣了款”这种动作,从头再跑就意味着再发一次、再建一次、再扣一次。
Demo 阶段的 Agent 很少考虑这些,因为 Demo 跑一次也就几十秒。但只要你的 Agent 开始处理真实的长任务,这个问题迟早会找上门。这篇文章想聊聊我对这个问题的理解,以及一个能落地的最小实现。
图片来源:quinn.anya (Quinn Daedal) / Flickr(CC BY-SA 2.0)
先把问题拆开
“断点续跑”听起来是一个问题,其实是两个:
能恢复到哪里:进程挂了之后,怎么知道之前做到了第几步、上下文是什么、每一步的结果是什么?这是状态持久化的问题。
恢复之后会不会重复:那些已经对外部世界产生影响的操作,恢复后会不会又执行一遍?这是幂等性的问题。
第一个问题相对好解决,存数据库就行。第二个问题才是真正的难点,因为它不完全在你的控制范围内:邮件发没发出去,取决于邮件服务;钱扣没扣,取决于支付系统。
另外,人工审批其实也可以放进同一个框架里:审批本质上就是一次“计划内的中断”。把状态存好,进程退出,等审批结果回来再恢复。能处理意外中断的系统,顺带就能处理审批。
核心思路:把 Agent 循环变成“可重放的日志”
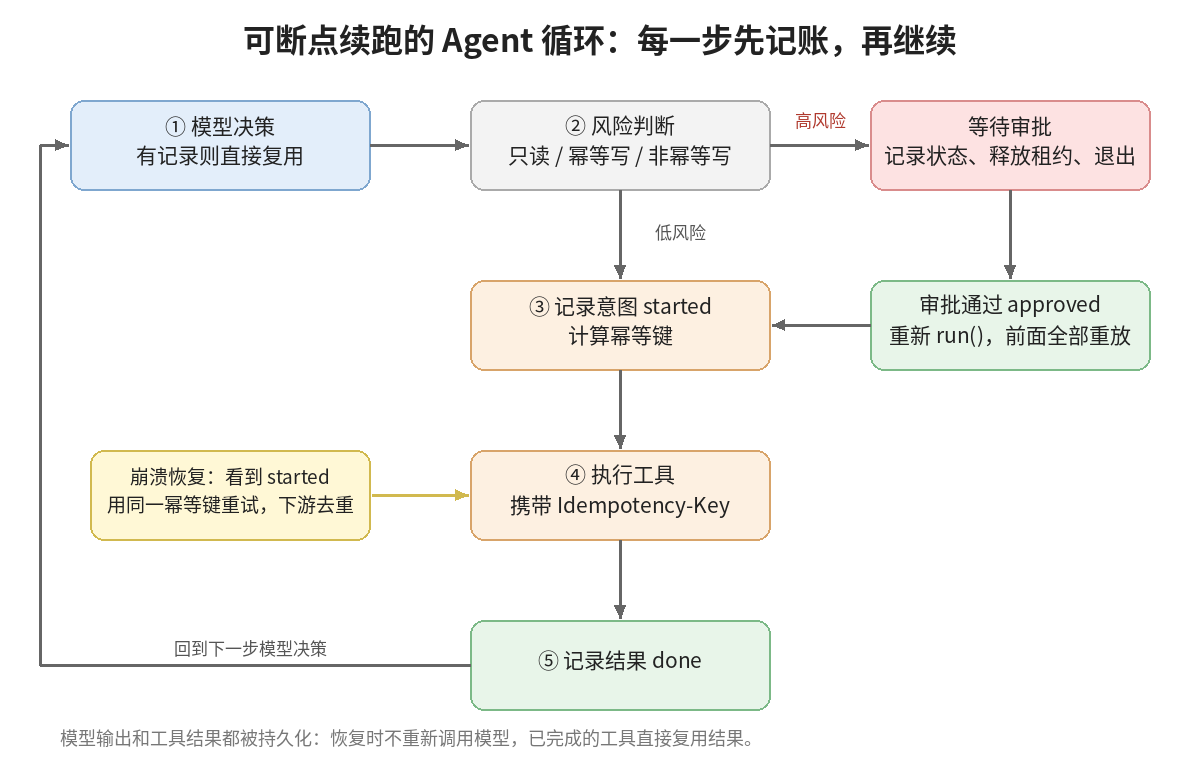
我比较推荐的做法,是借鉴事件溯源的思想:Agent 的每一步,都先记录,再继续。恢复的时候,不是“从某个状态接着跑”,而是“把记录从头重放一遍,已经有结果的步骤直接用记录里的结果,没有结果的才真正执行”。
这里有一个特别容易忽略的点:模型的输出也必须记录下来。
为什么?因为模型的输出是不确定的。同样的输入,第二次调用可能给出完全不同的决策。如果恢复的时候重新调用模型,它可能这次决定调用另一个工具,那后面所有已经记录的步骤就对不上了。所以,模型调用和工具调用一样,都是需要被“记账”的外部操作。
Agent 循环里的每一步,可以看成两种记录交替出现:
| 记录类型 | 记录内容 | 恢复时的处理 |
|---|---|---|
| 模型决策 | 模型这一步的输出(调哪个工具、什么参数,或者最终答案) | 有记录就直接用,绝不重新调用模型 |
| 工具执行 | 工具名、参数、幂等键、状态、结果 | 已完成的直接用结果;执行中的按幂等规则处理 |
最难的那一刻:执行了,但没来得及记录
工具执行的过程中,最危险的时间窗口在这里:
记录“准备执行” → 调用外部服务 → 【进程在这里挂了】 → 记录“执行完成”
恢复的时候,你看到一条状态为“执行中”的记录,但不知道外部服务到底有没有收到请求。重新执行,可能会重复;不执行,可能会遗漏。
这个问题没有银弹,只能根据工具的性质分类处理:
只读操作:查数据库、搜索、读文件。重新执行一遍没有任何副作用,直接重跑就行。
天然幂等的写操作:比如“把订单状态设置为已发货”、upsert、HTTP 的 PUT。执行一次和执行多次结果一样,也可以放心重跑。
非幂等的写操作:发邮件、发消息、创建工单、转账。这一类才需要认真对待。常见的处理方式有三种:
使用幂等键:很多成熟的外部 API 支持幂等键,比如在请求头里带一个
Idempotency-Key。同一个键的重复请求,服务端只会处理一次。Stripe 的 API 就是这种设计的典型代表。先查后做:如果外部服务不支持幂等键,恢复时先去查一下“这封邮件是不是已经发过了”“这个工单是不是已经建过了”,没有再执行。这要求你在请求里带上一个能用来查询的业务标识。
交给人判断:实在无法确定的,把这一步标记为“状态未知”,交给人来确认。这听起来很笨,但对于转账这类操作,笨办法往往是最安全的。
幂等键怎么生成也有讲究。它必须在重放时能稳定地重新算出来,所以不能用随机数或时间戳。我的做法是用“任务 ID + 步骤序号 + 工具名 + 参数”算一个哈希。同一个任务、同一步、同样的参数,算出来的键永远一样。
一个最小实现
下面是一个用 SQLite 实现的最小版本,大约 80 行,包含了状态持久化、幂等键、人工审批和租约。我在本地用假的模型和工具跑过几种场景,包括“执行后、记录前崩溃”的情况。
import json, sqlite3, hashlib, time

db = sqlite3.connect("agent_runs.db", isolation_level=None)
db.executescript("""
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, status TEXT, version TEXT,
  lease_owner TEXT, lease_until REAL);
CREATE TABLE IF NOT EXISTS steps(
  run_id TEXT, seq INTEGER, kind TEXT,      -- kind: model / tool
  status TEXT,                              -- started/done/waiting_approval/approved/rejected
  idem_key TEXT, payload TEXT, result TEXT,
  PRIMARY KEY(run_id, seq));
""")

def idem_key(run_id, seq, name, args):
    raw = json.dumps([run_id, seq, name, args], sort_keys=True, ensure_ascii=False)
    return hashlib.sha256(raw.encode()).hexdigest()[:32]

def get_step(run_id, seq):
    return db.execute("SELECT kind,status,idem_key,payload,result FROM steps "
                      "WHERE run_id=? AND seq=?", (run_id, seq)).fetchone()

def put_step(run_id, seq, kind, status, key=None, payload=None, result=None):
    db.execute("INSERT OR REPLACE INTO steps VALUES(?,?,?,?,?,?,?)",
               (run_id, seq, kind, status, key,
                json.dumps(payload, ensure_ascii=False),
                json.dumps(result, ensure_ascii=False)))

class NeedApproval(Exception):
    pass

def acquire_lease(run_id, worker, ttl=60):
    now = time.time()
    cur = db.execute("UPDATE runs SET lease_owner=?, lease_until=? WHERE run_id=? "
                     "AND (lease_until IS NULL OR lease_until<? OR lease_owner=?)",
                     (worker, now + ttl, run_id, now, worker))
    return cur.rowcount == 1

def run(run_id, task, call_model, tools, worker="w1", max_steps=30):
    db.execute("INSERT OR IGNORE INTO runs VALUES(?,?,?,NULL,NULL)",
               (run_id, "running", "prompt-v3"))
    if not acquire_lease(run_id, worker):
        return "另一个 worker 正在处理这个任务"
    messages = [{"role": "user", "content": task}]
    seq = 0
    while seq < max_steps * 2:
        # ① 模型决策:有记录就用记录,绝不重新调用模型
        rec = get_step(run_id, seq)
        if rec and rec[1] == "done":
            decision = json.loads(rec[4])
        else:
            decision = call_model(messages)
            put_step(run_id, seq, "model", "done", payload=None, result=decision)
        messages.append({"role": "assistant", "content": decision})
        seq += 1
        if decision.get("final"):
            db.execute("UPDATE runs SET status='done', lease_until=NULL WHERE run_id=?", (run_id,))
            return decision["final"]

        # ② 执行工具
        name, args = decision["tool"], decision["args"]
        tool = tools[name]
        key = idem_key(run_id, seq, name, args)
        rec = get_step(run_id, seq)
        if rec and rec[1] == "done":
            result = json.loads(rec[4])                  # 已执行过:直接复用结果
        elif rec and rec[1] == "rejected":
            result = {"error": "用户拒绝了这个操作"}
        else:
            if tool["risk"] == "high" and not (rec and rec[1] in ("approved", "started")):
                put_step(run_id, seq, "tool", "waiting_approval", key, decision)
                db.execute("UPDATE runs SET status='waiting', lease_until=NULL WHERE run_id=?", (run_id,))
                raise NeedApproval(f"{name} {args}")
            put_step(run_id, seq, "tool", "started", key, decision)   # 先记意图
            result = tool["fn"](args, idempotency_key=key)          # 再执行
            put_step(run_id, seq, "tool", "done", key, decision, result)  # 最后记结果
        messages.append({"role": "tool", "content": result})
        seq += 1
    return "超过最大步数,交给人处理"

def approve(run_id, seq, ok=True):
    kind, status, key, payload, _ = get_step(run_id, seq)
    assert status == "waiting_approval"
    put_step(run_id, seq, kind, "approved" if ok else "rejected", key, json.loads(payload))
    db.execute("UPDATE runs SET status='running' WHERE run_id=?", (run_id,))
几个设计上的取舍说明一下:
seq 是步骤的唯一标识。 模型决策和工具执行交替占用序号。重放的时候,只要模型决策是从记录里读出来的,后面每一步的序号就一定对得上。
“先记意图,再执行,再记结果”。 这三步的顺序不能乱。如果进程在中间挂了,恢复时会看到状态为 started 的记录,这时候会用同一个幂等键再执行一次,由下游负责去重。这也是为什么工具函数一定要接收 idempotency_key 参数,并把它传给外部服务。
审批就是一次抛异常退出。 遇到高风险工具,记录一条 waiting_approval,释放租约,然后直接退出。进程完全可以就此结束,哪怕三天后才有人审批也没关系。审批通过后再调用 run(),前面的步骤全部从记录里重放,走到这一步时发现状态是 approved,就真正执行。
租约防止两个 worker 同时恢复同一个任务。 在分布式部署下,同一个任务可能被两个 worker 同时捡起来。租约带一个过期时间,持有者崩溃后,租约过期,其他 worker 才能接手。生产环境里,执行期间还要定期续约。
这段代码离生产可用还差不少东西,比如消息格式、错误重试、并发写入、上下文太长时的处理,但核心骨架就是这样。
图片来源:原创示意图
和现成框架怎么对应
如果你不想自己造轮子,现在的主流方案大致分两类。
一类是 Agent 框架自带的持久化,比如 LangGraph。它的做法是给图配一个 checkpointer,每一步执行后自动保存状态,用 thread_id 标识一次运行;在节点里调用 interrupt() 就能暂停等待人工输入,之后用 Command(resume=...) 恢复。
这里有一个特别需要注意的细节,LangGraph 的文档里写得很明白:恢复时,是从调用 interrupt() 的那个节点的开头重新执行,而不是从 interrupt() 那一行接着往下走。也就是说,同一个节点里、位于 interrupt() 之前的代码,在恢复时会再跑一遍。所以官方建议把有副作用的操作放在 interrupt() 之后,或者干脆拆到单独的节点里,实在不行也要保证它是幂等的。这和上面讲的思路完全一致,只是框架帮你做了一部分记账工作。
另一类是通用的持久化执行引擎,比如 Temporal。它的模型是:工作流代码必须是确定性的,所有不确定的操作(包括调用模型、调用外部 API)都放在 Activity 里,引擎负责记录每个 Activity 的结果、失败重试、崩溃后重放。这其实就是上面那个最小实现的“工业级版本”。如果你的 Agent 本身就是一个复杂业务流程的一部分,或者团队已经在用 Temporal,这条路很值得考虑。
怎么选?我的看法是:任务本身以“和模型对话”为主,选 Agent 框架的持久化就够了;任务里有大量和业务系统交互、对可靠性要求很高的步骤,选持久化执行引擎更踏实。
一些踩坑提醒
恢复前,世界可能已经变了。 任务暂停了三个小时,你恢复时重放的是三个小时前的观察结果。库存可能已经变了,工单可能已经被别人处理了。对于时效性强的场景,恢复之后的第一步,最好让 Agent 先重新观察一下当前状态,再继续决策。
版本升级之后,旧任务怎么办? 你改了提示词、改了工具的参数结构,然后去恢复一个用旧版本启动的任务,记录里的工具调用可能已经和新代码对不上了。所以要在任务里记录版本号(上面代码里的 version 字段就是干这个的),恢复时检查一下,不兼容的要么用旧版本跑完,要么明确地终止,并通知人。
审批要有超时。 没人审批的任务不能无限期挂着,到时间自动拒绝,或者升级给其他人。同时,审批界面上要展示足够的信息:Agent 打算做什么、参数是什么、为什么要这样做。只给一个“同意/拒绝”按钮,审批者大概率会无脑点同意,那审批就形同虚设了。
Checkpoint 别存得太胖。 如果工具返回了一个几 MB 的文件内容,别直接塞进记录里,存到对象存储,记录里只放引用。否则数据库会膨胀得很快,恢复时加载也慢。
别忘了上下文本身。 恢复时要重建发给模型的消息列表。如果你的 Agent 中途做过上下文压缩,那么压缩的结果也要作为一步记录下来,否则重放出来的上下文和当初的不一样,后续的模型决策就可能对不上。
落地检查清单
| 检查项 | 说明 |
|---|---|
| ☐ 每次模型输出都被持久化 | 恢复时不重新调用模型 |
| ☐ 每个工具都标注了风险等级 | 只读 / 幂等写 / 非幂等写 |
| ☐ 非幂等工具都支持幂等键或先查后做 | 幂等键可以在重放时稳定地重新计算 |
| ☐ 工具执行遵循“记意图、执行、记结果”的顺序 | 能识别执行中断的步骤 |
| ☐ 高风险操作有审批,且审批有超时 | 审批信息足够做判断 |
| ☐ 有租约机制 | 同一任务不会被两个 worker 同时执行 |
| ☐ 任务记录了版本号 | 升级后能识别不兼容的旧任务 |
| ☐ 长时间暂停后会重新观察环境 | 避免基于过期信息做决策 |
后端同学,这是你的老本行
写这篇的时候我一直在想,这些东西其实都不新。幂等、事务日志、分布式锁、Saga,做后端的同学多少都接触过。Agent 只是把这些老问题又摆到了桌面上,而且加了一个新变量:决策者本身是不确定的。
所以,如果你是后端出身,转做 Agent 的时候大可不必觉得自己在从零开始。你过去在分布式系统里吃过的那些亏,在这里大概率都用得上。
参考资料:
LangGraph 文档,Interrupts:https://docs.langchain.com/oss/python/langgraph/interrupts
LangGraph 文档,Persistence:https://docs.langchain.com/oss/python/langgraph/persistence
Temporal 文档:https://docs.temporal.io/
Stripe API 文档,Idempotent requests:https://docs.stripe.com/api/idempotent_requests
 2026-10-08鱼鱼