

做 Agent 的人,大概都经历过这么一个时刻:功能调通了,效果也还行,兴冲冲地跑了一批真实任务,然后打开账单页面,沉默了。
同样是调用大模型,Agent 为什么比普通聊天贵这么多?钱都花在哪了?能不能在不明显影响效果的前提下省下来?这篇文章想把这笔账算清楚,再聊几种我觉得性价比最高的省钱办法。
先声明一下:各家模型的价格和缓存规则变得很快,文中涉及的具体规则,以我写作时(2026 年 10 月)看到的官方文档为准,你落地之前最好再核对一遍。思路是通用的,数字请以官方为准。
图片来源:Negative Space / StockSnap(CC0 1.0)
先算账:Agent 的输入 token 是“滚雪球”
普通聊天,一问一答,输入的就是你的问题加上一些历史。Agent 不一样,它的每一步都是一次完整的模型调用,而每次调用都要把系统提示词、工具定义、之前所有的对话和工具结果重新发一遍。
我们来算一个简化的例子。假设:
-
系统提示词加工具定义,一共 8000 token;
-
每一步新增的内容(工具返回的结果加上模型的回复)平均 2000 token;
-
一个任务跑 20 步。
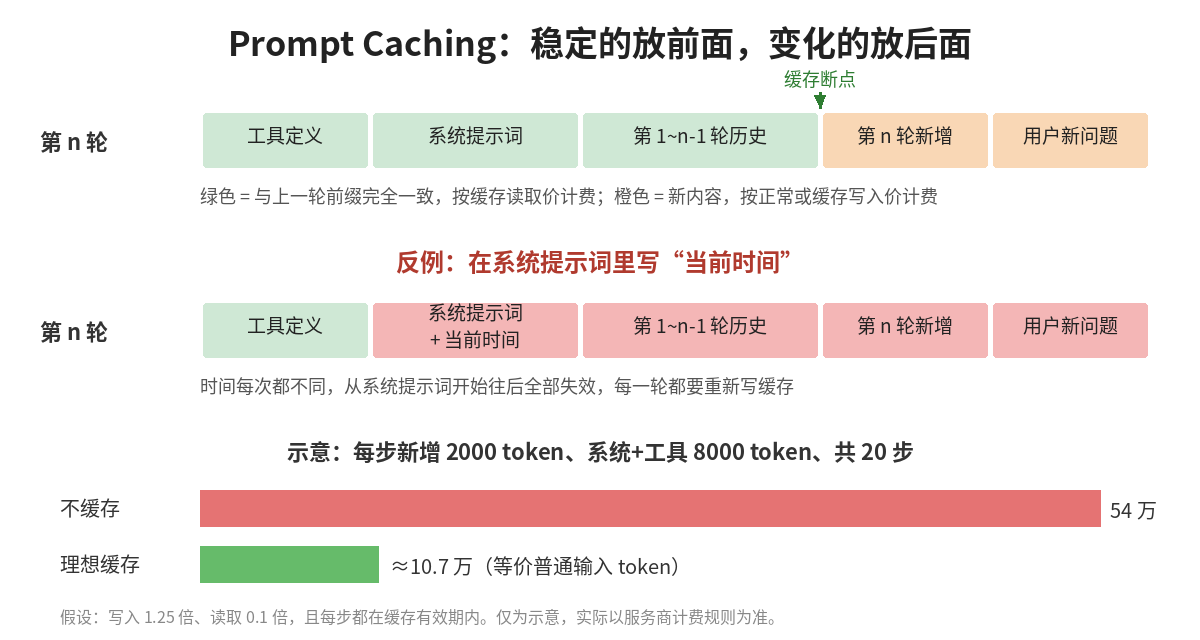
那么第 1 步的输入是 8000,第 2 步是 10000,第 20 步是 46000。20 步加起来,总输入是 54 万 token。而这里面真正“新”的内容,其实只有 8000 加 19 × 2000,也就是 4.6 万 token。
剩下将近 50 万 token,都是在反复发送模型已经看过的东西。输入 token 的总量,大致随步数平方增长。步数一多,这个数字会非常吓人。
这就是 Agent 账单的第一个大头。好消息是,这个大头恰恰是最好省的。
第一刀:Prompt Caching
原理很简单
模型处理输入的时候,会为每个 token 计算一些中间状态(KV cache)。如果两次请求的开头部分一模一样,那第二次就没必要重新计算这部分,直接复用上次的结果就行。服务商把这个能力开放出来,就是 Prompt Caching:命中缓存的那部分输入,按很低的价格计费,响应也更快。
关键词是前缀完全一致。哪怕只差一个字符,从那个字符往后的缓存就全部失效了。
主流服务商怎么用
Anthropic(Claude):需要你在请求里用 cache_control 标记缓存位置。可以在请求顶层加一个 cache_control,让系统自动把断点放在最后一个可缓存的块上,对多轮对话最省心;也可以手动给具体的块(比如系统提示词、最后一个工具定义)打标记,一个请求最多 4 个断点。默认缓存 5 分钟,每次命中都会刷新时间,也可以付更高的写入价格换 1 小时。计费上,5 分钟缓存的写入价是正常输入价的 1.25 倍,1 小时的是 2 倍,读取价大多数模型是 0.1 倍,部分新模型更低。另外,每个模型都有一个最小可缓存长度,太短的前缀不会被缓存,而且不会报错,这点要留意。
OpenAI:对支持的模型默认开启,不需要改代码就能享受。较新的模型还支持显式指定断点,也引入了写入计费;更早的模型没有写入费,但缓存命中依赖请求被路由到同一台机器,可以用 prompt_cache_key 来提高命中率。具体规则因模型而异,建议直接看文档里那张对比表。
两家的共同点是:都可以从返回的 usage 字段里看到缓存命中了多少。这是你验证缓存有没有生效的唯一可靠依据。
代码长什么样
以 Anthropic 的 Python SDK 为例,一个给系统提示词打缓存标记的写法大概是这样:
import anthropic

client = anthropic.Anthropic()
MODEL = "your-model-id"  # 换成你实际使用的模型

SYSTEM = [
    {
        "type": "text",
        "text": LONG_STABLE_INSTRUCTIONS,  # 稳定不变的长指令
        "cache_control": {"type": "ephemeral"},  # 缓存断点放在稳定内容的末尾
    }
]

def step(messages, tools):
    resp = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM,
        tools=tools,       # 工具定义也在前缀里,顺序和内容要保持稳定
        messages=messages,
    )
    u = resp.usage
    print(f"写入缓存 {u.cache_creation_input_tokens},"
          f"命中缓存 {u.cache_read_input_tokens},"
          f"未缓存输入 {u.input_tokens}")
    return resp
如果是多轮的 Agent 循环,更省事的办法是在请求顶层加 cache_control={"type": "ephemeral"},让断点随对话自动往后挪。
回到刚才那笔账
还是 8000 + 每步 2000、跑 20 步的例子。假设每一步都在缓存有效期内,写入按 1.25 倍、读取按 0.1 倍计算,那么 20 步的输入成本,折算下来相当于大约 10.7 万个普通输入 token,是不缓存时的五分之一左右。
这是理想情况。实际中缓存可能过期、可能因为各种原因失效,但即便打个折扣,这也是我见过的单项改动里,投入产出比最高的一个。
图片来源:原创示意图
最容易踩的坑:不知不觉把缓存打碎了
缓存这个东西,开起来容易,保持命中才是真功夫。下面这些操作,都会让缓存在你不知情的情况下失效:
| 操作 | 为什么会打碎缓存 | 怎么改 |
|---|---|---|
| 在系统提示词里写当前时间 | 每次请求开头都不一样 | 把时间放到最后一条用户消息里 |
| 动态增删、重排工具 | 工具定义在前缀的最前面,一动全部失效 | 工具列表保持稳定,用参数控制哪些可用 |
| JSON 序列化顺序不固定 | 有些语言的 map 遍历顺序随机,字节不一致 | 序列化时固定 key 顺序 |
| 每轮都改写历史 | 比如每步都重新摘要前文,前缀每次都变 | 攒到一定长度再批量压缩,别每轮都动 |
| 把用户相关内容放在前面 | 不同用户的前缀从一开始就不同 | 通用内容在前,个性化内容在后 |
| 中途切换推理参数 | 部分服务商会把这类参数渲染进提示词 | 尽量保持一致,或按文档的方式切换 |
说白了就一句:稳定的放前面,变化的放后面,前面的东西尽量别动。
我建议在你的 Agent 里加一个简单的监控:每次调用都把缓存命中的 token 数和总输入 token 数记下来,算一个命中率。命中率突然掉下来,基本就是有人改了提示词结构,比翻代码找原因快得多。
第二刀:给上下文“瘦身”
缓存解决的是“重复发送”的成本,但如果上下文本身就很臃肿,那缓存了也照样要付钱,而且太长的上下文还会影响模型的表现。
工具返回结果要“裁剪”。 这是最常见的浪费。比如一个查询订单的工具,直接把接口返回的完整 JSON 丢给模型,几十个字段,模型真正需要的可能就三四个。我的原则是:
-
只返回模型做决策需要的字段;
-
列表类结果要分页,默认只给前 N 条,并告诉模型“还有更多,可以继续查”;
-
超长文本(日志、网页、文件)先截断,并在结果里注明截断了,以及怎么获取剩余部分。
旧的工具结果可以“退场”。 一个 30 步的任务,第 3 步读的那个文件内容,到第 25 步可能已经没用了。可以把早期的大块工具结果替换成一句简短的摘要。
但这里有个和缓存的矛盾:改写历史会打碎缓存前缀。我的做法是不要每一步都清理,而是设一个阈值,比如上下文超过某个长度时,一次性压缩一大段,之后再继续稳定地往后追加。压缩的那一步会付一次全价,但换来后面很多步更短的上下文,通常是划算的。
用子 Agent 隔离脏活。 有些任务需要大量探索,比如在一个大仓库里找某个函数的所有调用点。与其让主 Agent 自己翻几十个文件,不如派一个子 Agent 去干,干完只把结论交回来。主 Agent 的上下文里只多了几百个 token,而不是几万个。
第三刀:不是每一步都需要最贵的模型
Agent 里的模型调用,难度差别其实很大。“规划整个任务怎么做”和“从这段文本里提取一个日期”,显然不需要同一个级别的模型。
我比较常用的分级方式:
| 任务类型 | 适合的模型 | 例子 |
|---|---|---|
| 规划、复杂推理、关键决策 | 最强的模型 | 拆解任务、判断方案、处理异常情况 |
| 常规的工具调用和执行 | 中档模型 | 按计划一步步执行 |
| 分类、提取、格式转换、摘要 | 小模型 | 意图识别、从网页提取字段、压缩历史 |
还有一个容易被忽略的点:输出 token 通常比输入 token 贵好几倍。所以让模型“少说废话”也是实打实的省钱:要求结构化输出、给 max_tokens 设个合理的上限、在提示词里明确“只输出结论,不要复述问题”。
第四刀:不着急的任务,走批处理
如果你的任务不需要实时返回,比如每天晚上批量处理一批文档、跑一遍评测集、给历史数据打标签,那可以考虑批处理接口。Anthropic 和 OpenAI 的批处理接口都是按正常价格的 50% 计费,代价是结果不会马上返回,一般承诺在 24 小时内完成。
很多团队的评测流程其实特别适合走批处理:评测集一跑就是几百上千条,又不需要立刻看结果。这部分省下来的钱,可能比你想象的多。
最后一道防线:预算护栏
前面说的都是“怎么花得更少”,最后还得有一个“最多花多少”的兜底。Agent 最怕的不是贵,是失控:一个任务陷入循环,反复调用同一个工具,跑了几百步还停不下来。
几个基本的护栏:
-
单任务预算:设定最大步数和最大 token 数,超了就停下来,交给人处理;
-
重复检测:连续几次用相同参数调用同一个工具,大概率是卡住了;
-
按租户/用户记账:知道钱花在谁身上,才知道该优化哪里;
-
告警:单日花费、单任务花费超过阈值时通知人。
说到底,还是先看清账单
说实话,省钱这件事,做到最后会发现很多优化都是“工程上的老问题换了个马甲”:缓存是缓存,裁剪是减少数据传输,模型分级是资源调度,批处理是削峰填谷。真正新的东西不多,难的是你得先知道钱花在哪了。
所以如果只能做一件事,我的建议是:先把每次调用的 token 用量和缓存命中情况记下来。看清楚账单的构成,后面的优化自然就知道从哪下手了。
参考资料:
-
Anthropic 文档,Prompt caching:https://platform.claude.com/docs/en/build-with-claude/prompt-caching
-
OpenAI 文档,Prompt caching:https://platform.openai.com/docs/guides/prompt-caching
-
Anthropic 文档,Message Batches API:https://platform.claude.com/docs/en/build-with-claude/batch-processing
-
OpenAI 文档,Batch API:https://developers.openai.com/api/docs/guides/batch
 2026-10-14鱼鱼