

用 AI 编程助手久了,你大概会有一种“祥林嫂”式的疲惫:每开一个新会话,就得把同样的话再说一遍。
“我们用 pnpm,不是 npm。”“跑测试要加这个参数,不然会连真实数据库。”“generated 目录下的代码是自动生成的,别改。”“提交信息要按这个格式写。”
说一次两次还好,说到第十次,就会开始怀疑人生。更糟糕的是,你偶尔忘了说,AI 就会理直气壮地按自己的默认习惯来,然后你再花时间收拾。
解决这个问题的办法其实很朴素:把这些话写下来,放进仓库,让 AI 每次开工前自己读。这就是 AGENTS.md 要干的事。
图片来源:rawpixel.com(CC0 1.0)
AGENTS.md 是什么
一句话:给 AI 看的 README。
README 是写给人的:项目介绍、快速开始、贡献指南。但 AI 编程助手需要的信息不太一样,它更需要知道怎么构建、怎么跑测试、有哪些约定、哪些地方别碰。这些内容放进 README 会显得很啰嗦,对人类读者也没什么用,于是就有了一个单独的文件。
简单交代一下来历。AGENTS.md 是 OpenAI 在 2025 年 8 月推出的约定,最初由 Codex、Amp、Google 的 Jules、Cursor、Factory 等几家一起推动。2025 年 12 月,Linux 基金会成立了 Agentic AI Foundation(AAIF),AGENTS.md 和 MCP、goose 一起成了首批项目。官网上说已经有超过 6 万个开源项目在用。
它没有任何“必填字段”,就是普通的 Markdown,标题随便写。这一点我挺喜欢的,门槛低到几乎没有。
各家工具的“说明书”文件,怎么对上号
现实情况是,在 AGENTS.md 出现之前,各家工具都有自己的约定,现在也没有完全统一。我整理了一下,截至 2026 年 10 月的情况大致如下:
| 工具 | 自家的说明文件 | 和 AGENTS.md 的关系 |
|---|---|---|
| OpenAI Codex | AGENTS.md | 原生支持 |
| Cursor | .cursor/rules/ 下的规则文件 |
也直接读 AGENTS.md,规则文件适合需要按路径匹配的场景 |
| GitHub Copilot | .github/copilot-instructions.md |
编码 agent 支持 AGENTS.md |
| Gemini CLI | GEMINI.md | 可以在设置里把上下文文件名配置成 AGENTS.md |
| Aider | 约定文件 | 在 .aider.conf.yml 里写 read: AGENTS.md |
| Claude Code | CLAUDE.md | 新版本在没有 CLAUDE.md 时会读 AGENTS.md;最稳妥的是在 CLAUDE.md 里写一行 @AGENTS.md 导入 |
我的建议是:把 AGENTS.md 当作唯一的“事实来源”,其他工具的文件尽量只做引用或者少量补充。比如 CLAUDE.md 可以只写:
@AGENTS.md

## 仅针对 Claude Code 的补充
- 需要跑耗时较长的集成测试时,先问我。
这样团队里有人用 Cursor、有人用 Claude Code、有人用 Codex,大家读到的都是同一份规矩,改一处就行。各家工具的具体行为更新很快,上表仅供参考,落地前最好去对应文档里确认一下。
该写什么
我的经验是,好的 AGENTS.md 写的都是AI 自己猜不到、猜错了代价又挺大的东西。按优先级排:
1. 能直接复制运行的命令。 安装依赖、启动、跑单测、跑某一个测试、格式化、lint。一定要写完整的命令,别写“用 Maven 跑测试”这种话。AI 拿到具体命令,会在改完代码后自己去跑,这比任何“请保证代码质量”的叮嘱都管用。
2. 目录地图。 不用面面俱到,说清楚几个关键目录就行:业务代码在哪、公共组件在哪、哪些是自动生成的。
3. 和“默认习惯”不一样的约定。 这是最有价值的部分。比如“金额一律用 BigDecimal,禁止 double”、“时间统一存 UTC”、“新接口必须走统一的 Result 包装”。跟主流做法一致的约定,AI 本来就会遵守,写了也是浪费篇幅。
4. 禁区。 哪些文件别改(生成代码、已上线的数据库迁移脚本)、哪些命令别跑(会连生产环境的、会删数据的)。
5. 完成的定义。 改完代码之后,提交之前,必须做哪几件事。
6. 提交和 PR 的规范。 提交信息格式、PR 描述要包含什么。
不该写什么
同样重要的是别写什么,因为这个文件每次都会被塞进上下文,写得越长,越占 token,重点也越容易被稀释。
-
别写正确的废话:“请写出高质量、可维护的代码”。AI 本来就这么觉得自己。
-
别把整份设计文档贴进来:写一句“设计文档在
docs/design/,涉及订单状态流转时先读order-state.md”就够了,让它按需去读。 -
别写会很快过期的信息:比如“当前正在重构支付模块”,过两周就成了误导。
-
千万别写密钥、内网地址、账号密码。这个文件是要提交到仓库的。
写给 AI 的话,和写给人的话不太一样
同样一条规矩,写给人和写给 AI,效果可能差很多。我自己摸索出来几个小窍门:
写具体的动作,别写抽象的原则。 “注意代码风格统一”基本等于没写;“提交前执行 ./mvnw spotless:apply”它就会真的去执行。AI 对可执行的指令特别敏感,对形容词则很迟钝。
顺手写一句理由。 比如“不要修改已有的迁移脚本,因为线上库已经执行过,改了会导致校验失败”。带理由的规则,模型在遇到规则没覆盖的相似情况时,更容易举一反三;光写“不要”,它有时会钻空子,比如不改旧脚本,却新建一个把旧逻辑覆盖掉的脚本。
正面说法比反面说法好用。 “金额用 BigDecimal”比“不要用 double 表示金额”更直接,最好两句都写上。
别指望它记住长篇大论。 一条规则一行,用列表,别写成大段散文。重要的规则放前面,越往后越容易被忽略,这一点人和 AI 倒是差不多。
一个 Java 项目的示例
下面是我按一个典型 Spring Boot 项目写的示例,可以直接拿去改:
# AGENTS.md

## 项目概览
订单服务,Spring Boot 3 + MyBatis + MySQL 8,JDK 21。
业务代码在 order-core/,对外接口在 order-api/。

## 常用命令
- 构建:./mvnw -q -DskipTests package
- 全部单测:./mvnw test
- 单个测试:./mvnw -pl order-core test -Dtest=OrderServiceTest
- 格式化:./mvnw spotless:apply(提交前必须执行)

## 约定(与常见做法不同的部分)
- 金额一律用 BigDecimal,禁止 double/float
- 数据库时间字段统一存 UTC,展示层再转换
- 对外接口统一返回 Result<T>,不要直接返回实体
- 日期工具用 common/DateUtils,不要新引入日期库

## 禁止事项
- 不要修改 src/main/resources/db/migration/ 下已有的迁移脚本,只能新增
- 不要修改 target/ 和 generated/ 下的任何文件
- 不要运行任何带 -Pprod 的命令

## 完成标准
1. ./mvnw spotless:apply 和 ./mvnw test 全部通过
2. 新增的业务逻辑要有对应单测
3. 不得删除或跳过已有测试;确需修改测试时,在 PR 描述里说明原因

## 提交规范
提交信息格式:<类型>(<模块>): <描述>,例如 fix(order): 修复重复下单
大概四五十行。我觉得这个长度比较合适,一屏看得完,重点也都在。
Monorepo:用嵌套的 AGENTS.md
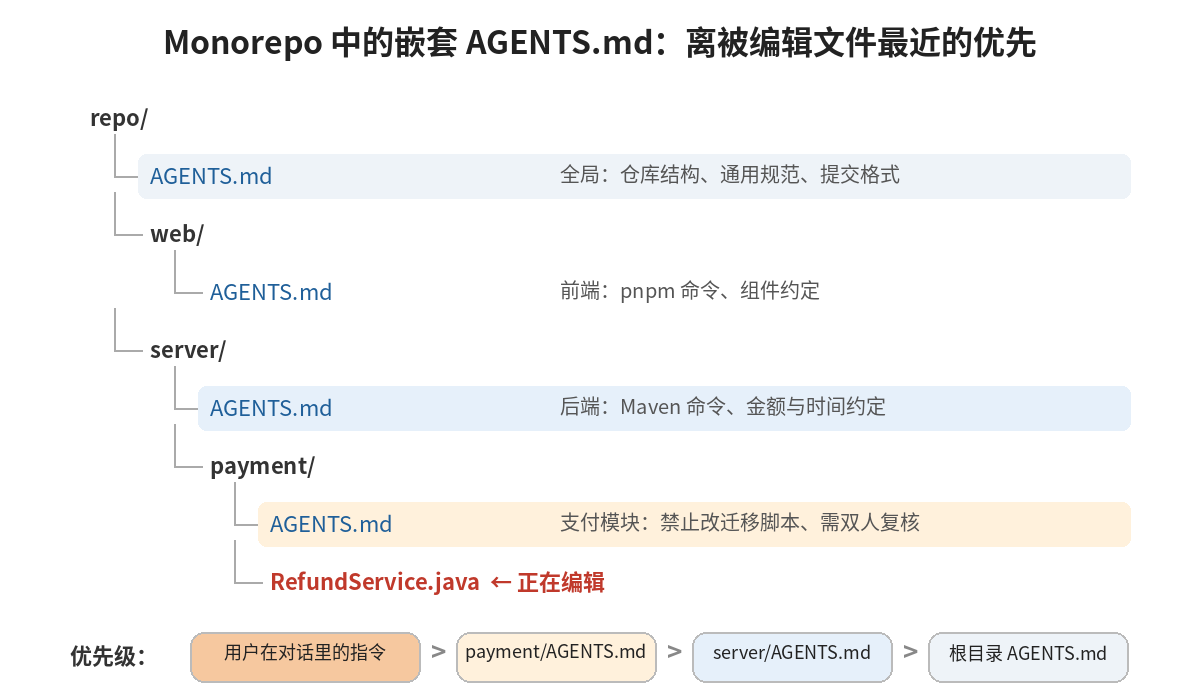
如果是一个大仓库,前端、后端、脚本都在里面,一份文件肯定说不清。AGENTS.md 的约定是:可以在子目录里再放 AGENTS.md,AI 会读离当前编辑文件最近的那一份,越近优先级越高。官网举的例子是,OpenAI 的主仓库里一度有 88 个 AGENTS.md。
图片来源:原创示意图
实践中,我会让根目录的文件只写全局的东西(仓库结构、通用规范、提交格式),每个子项目的文件写自己的命令和约定。冲突的时候以近的为准,用户在对话里直接说的话又比所有文件优先。
不过要注意,不同工具对“嵌套文件怎么合并”的处理细节不完全一样,有的是就近覆盖,有的是父子叠加。写的时候尽量让子目录的文件只做“补充”,别和根目录的说法打架,这样不管哪种合并方式都不会出问题。
怎么维护,才不会写完就烂掉
这个文件最大的风险不是写得不好,而是写完就没人管了。几个我觉得有用的做法:
让 AI 反复犯的错进入这个文件。 这是最自然的更新来源。如果你发现自己在对话里第三次纠正同一个问题,别再口头说了,直接加一行进 AGENTS.md。
让 AI 自己起草,然后你删一半。 大部分编程助手都能扫一遍仓库帮你生成初稿。但它生成的东西通常偏长、偏“正确的废话”。我的做法是让它写,然后把它能猜到的那一半删掉,留下它猜不到的。
把它当代码一样 Review。 改 AGENTS.md 也走 PR,团队里有人觉得某条规则不对,可以在 PR 里讨论。说到底,它其实就是团队开发规范的一个“可执行版本”。
定期瘦身。 每隔一段时间看看,有没有已经过时的条目、有没有 AI 早就不会犯的错。规则只增不减,最后一定会变成没人读、AI 也读不进去的长文。
写着写着发现的事
写 AGENTS.md 这件事,有点像给新同事写入职手册。写的过程中,你会发现很多“大家都知道”的规矩,其实从来没被写下来过,全靠口口相传。
这么看,就算哪天 AI 编程助手不再需要这个文件了,写下来的这些东西对新来的人类同事也一样有用。这笔账怎么算都不亏。
参考资料:
-
AGENTS.md 官网:https://agents.md/
-
Linux Foundation 关于成立 Agentic AI Foundation 的公告:https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
-
Claude Code 文档,CLAUDE.md 与 AGENTS.md:https://code.claude.com/docs/en/memory
-
Cursor 文档,Rules:https://cursor.com/docs/rules
 2026-10-14鱼鱼