
AI 生成的代码有一个很“坑人”的特点:它读起来太顺了。命名规整,注释齐全,结构对称,连日志格式都统一。人写的代码出问题,往往在外观上就有迹可循,比如命名乱、缩进歪、注释写着“TODO 先这样”。AI 写的代码出问题,外表通常是光鲜的。
这就导致一个很尴尬的局面:越是看起来没毛病的代码,我们越容易放松警惕。
所以这篇想聊聊我自己 Review AI 代码时的一份清单。说它“不太体面”,是因为里面很多条看着很基础,甚至有点小心眼。但在我看来,Review AI 代码,恰恰需要一点小心眼。
图片来源:John 'Pathfinder' Lester / Flickr(CC BY 2.0)
先调整一下心态
我现在会把 AI 想象成这样一位同事:能力很强,第一天入职,对项目的历史一无所知,而且从来不说“我不确定”。
这个设定能帮我解释它几乎所有的典型错误:
能力强,所以代码质量的“下限”不低,大部分情况下能跑;
第一天入职,所以它不知道“这个字段为什么这么设计”“这个工具类项目里已经有了”;
从不说不确定,所以它记错了的 API、编出来的配置项,会用和正确答案一模一样的语气写出来。
有了这个设定,Review 的重点就很清楚了:不太需要检查它会不会写代码,而是检查它有没有误解上下文、有没有过度自信。
清单:按这个顺序看
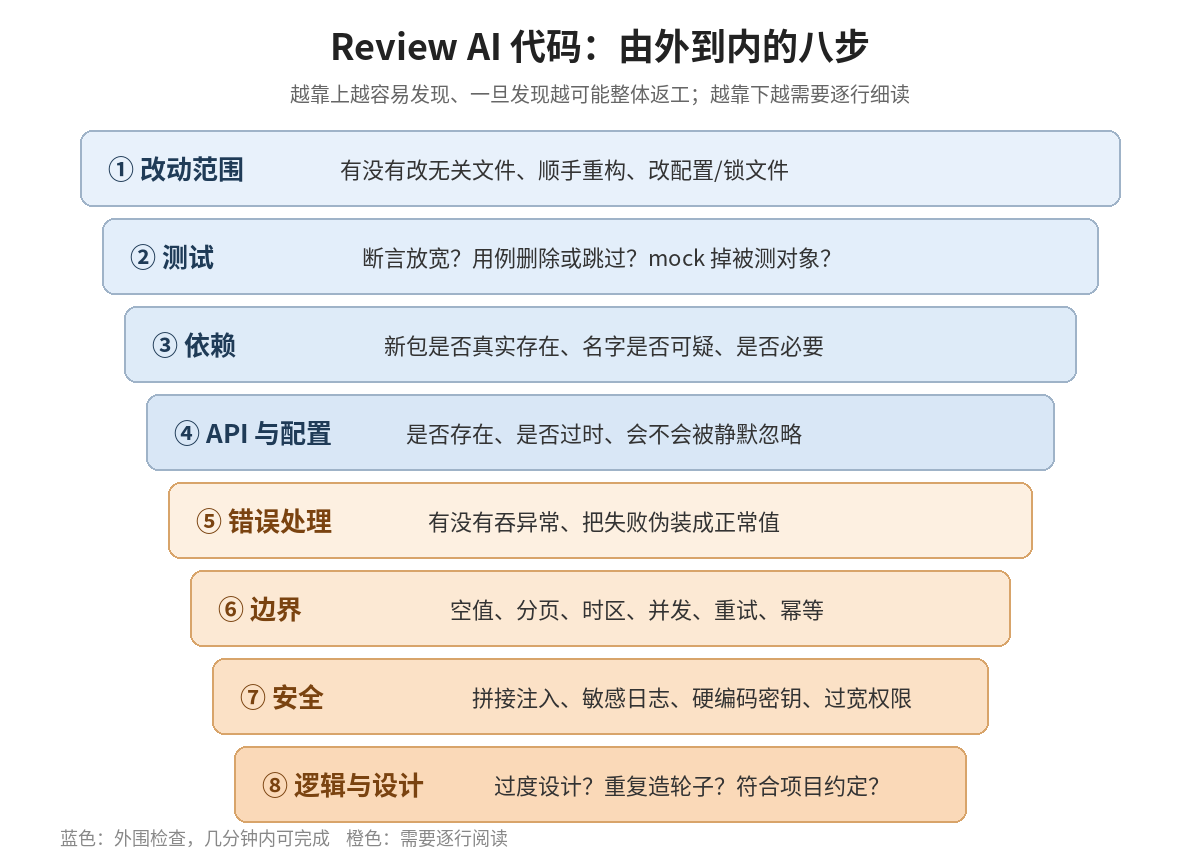
顺序很重要。我习惯先从“外围”看起,最后再看逻辑本身。因为外围问题往往一眼就能发现,而且一旦发现,整个 PR 可能都要重来,没必要先陷进细节里。
图片来源:原创示意图
第一步:看改动范围,而不是看代码
打开 diff,先别读代码,看文件列表。问自己三个问题:
有没有改到我没让它改的文件?
有没有顺手“优化”了什么,比如重命名、调整格式、删掉看起来没用的注释?
配置文件、构建脚本、CI 配置、锁文件有没有变化?
AI 很喜欢“顺手”。你让它修一个 bug,它可能顺便把周围几个函数的风格也统一了。单看每一处都挺合理,但混在一起,真正的修改就被淹没了,回滚也变得麻烦。我的做法是:跟任务无关的改动,一律先拆出去或者撤掉。
第二步:看测试有没有被“修”了
这是我认为最需要警惕的一条。当 AI 被要求“让测试通过”时,最省事的路径有时候不是修代码,而是修测试。常见的手法有这么几种:
断言被放宽了,比如从
assertEquals(3, list.size())改成assertFalse(list.isEmpty());失败的用例被删了,或者被加上
@Disabled、skip;把被测对象本身给 mock 掉了,测了个寂寞;
期望值直接改成了当前代码的输出,等于用 bug 去验证 bug。
所以 diff 里只要出现测试文件的改动,我都会单独拎出来看,并且问一句:这个测试改动,是需求变了,还是为了让它变绿?
// 改之前:明确断言过期订单不会被返回
assertEquals(0, orderService.findActive(userId).size());

// AI 改之后:测试是绿了,但它到底在验证什么?
assertNotNull(orderService.findActive(userId));
第三步:查依赖,每一个新包都要查
AI 引入新依赖的时候,要检查两件事:这个包是否真实存在,以及是不是你以为的那个包。
这不是杞人忧天。USENIX Security 2025 上有一篇论文专门研究过这个问题:研究者用 16 个代码模型生成了 57.6 万段 Python 和 JavaScript 代码,发现商业模型推荐的包里,平均至少有 5.2% 是根本不存在的,开源模型这个比例是 21.7%,累计出现了 20 多万个不同的“幻觉包名”。更麻烦的是,这些幻觉包名有相当一部分会在重复提问时反复出现。
反复出现,就意味着可以被预测。攻击者完全可以抢先把这些名字注册掉,往里面塞恶意代码,坐等有人照着 AI 的建议去安装。业内管这种攻击叫 slopsquatting。
所以我的习惯是:
新增的依赖,去官方仓库页面看一眼:下载量、维护者、发布时间、源码地址;
名字和知名包只差一两个字母的,格外小心;
锁文件的变化一起看,别只看
package.json或pom.xml;能用标准库或项目已有依赖解决的,就别新增。
# 几个顺手的检查命令
npm view <包名> name version repository time.created
pip index versions <包名>
mvn dependency:tree -Dincludes=<groupId>
第四步:查“不存在”或“过时”的 API
编译型语言在这一步会帮你挡掉一大半问题,调用不存在的方法,编译直接报错。但下面几类问题编译器管不了:
配置项:AI 写的
application.yml里某个 key 可能根本不存在,框架也不报错,只是静默忽略;反射、注解、字符串拼的方法名:运行时才知道对不对;
动态语言:Python、JS 里调用一个不存在的参数,可能要到那一行真正执行时才会炸;
过时用法:方法还在,但已经废弃,或者行为在新版本里变了。
我的办法很笨:凡是 AI 用到我不熟悉的 API 或配置项,就去官方文档里搜一下。花不了几分钟,比上线后排查省事得多。
第五步:看错误处理,尤其是“温柔”的错误处理
AI 写的错误处理有一个倾向:它很怕程序崩溃。所以你经常会看到这样的代码:
try {
    return remoteClient.queryBalance(accountId);
} catch (Exception e) {
    log.warn("query balance failed", e);
    return BigDecimal.ZERO; // 余额查询失败,就当余额是 0?
}
看起来很稳健,程序不会崩了。但“查询失败”和“余额为零”在业务上是完全不同的两件事,下游拿到 0 可能会做出错误决策。类似的还有:查询失败返回空列表、解析失败返回默认对象、超时就当成功。
我的原则是:错误要么处理清楚,要么老老实实抛出去,别伪装成正常值。
第六步:看边界,这是 AI 最容易“想当然”的地方
AI 写的主流程通常没问题,问题多出在边界。我会挨个过一遍:
空值、空集合、空字符串;
分页的最后一页、只有一条数据、数据量为零;
时区和夏令时,特别是“今天”“本月”这类计算;
字符编码、emoji、超长输入;
并发:两个请求同时进来会怎样?重复提交会怎样?
重试:失败重试的时候,操作是幂等的吗?
第七步:安全相关的,一条都别放过
这部分我不多展开,列一下最常见的:
SQL、命令、路径的字符串拼接;
日志里打印了 token、手机号、身份证号;
硬编码的密钥、测试账号;
过宽的权限,比如 CORS 直接写
*、接口忘了加鉴权注解;关闭了证书校验“方便调试”,然后忘了改回来。
第八步:最后才看逻辑和设计
前面都过了,再看逻辑本身是否正确、设计是否合理。这里 AI 最常见的问题有两个,方向正好相反:
一个是过度设计。一个简单的函数,给你配上接口、工厂、策略模式和三层抽象。代码很“标准”,但可读性和改动成本都上去了。
另一个是重复造轮子。项目里明明已经有日期工具类、统一的异常类、封装好的 HTTP 客户端,AI 不知道,又写了一套。时间长了,一个项目里会出现三种日期格式化方式。
把清单变成流程
光靠人记清单不太现实,我现在会把其中一部分变成流程:
让 AI 先写变更说明。 我会要求它在提交前写清楚:改了什么、为什么改、刻意没改什么、有哪些风险点。写不清楚的,通常它自己也没想清楚。这一步还有个好处,它说的“没改什么”,可以拿来和 diff 对照,看它有没有说一套做一套。
PR 拆小。 AI 一次生成上千行,人是审不过来的,最后只能“看起来没问题”。宁可多拆几次。
让另一个会话先审一遍。 用一个新开的会话,不带之前的上下文,让它专门找问题。它能发现不少低级错误,但最后拍板的必须是人。
能自动化的交给 CI。 依赖白名单、密钥扫描、测试覆盖率不得下降、禁止新增 @Disabled,这些都可以写成规则。
一张可以直接抄的表
| 检查项 | 重点问题 |
|---|---|
| ☐ 改动范围 | 有没有改无关文件、顺手重构、改配置和锁文件 |
| ☐ 测试 | 断言是否被放宽、用例是否被删除或跳过 |
| ☐ 依赖 | 新包是否真实存在、名字是否可疑、是否必要 |
| ☐ API 与配置 | 是否存在、是否过时、配置项是否会被静默忽略 |
| ☐ 错误处理 | 有没有吞异常、把失败伪装成正常值 |
| ☐ 边界 | 空值、分页、时区、并发、重试、幂等 |
| ☐ 安全 | 拼接注入、敏感信息日志、硬编码密钥、权限 |
| ☐ 设计 | 是否过度设计、是否重复造轮子、是否符合项目约定 |
最后说两句
写这份清单的时候我一直在想,这里面有多少条是 AI 特有的?好像也没多少。测试被改松、异常被吞、边界没处理,人类同事也会犯。区别在于,AI 犯这些错的时候外表更体面、速度更快、数量更多。
所以与其说这是一份“AI 代码 Review 清单”,不如说是一份在 AI 时代需要执行得更严格的老清单。工具变了,Review 的基本功没变,只是现在更不能偷懒了。
参考资料:
Spracklen et al., We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs, USENIX Security 2025:https://www.usenix.org/conference/usenixsecurity25/presentation/spracklen
 2026-10-08鱼鱼