
当 Agent 需要接入越来越多的外部能力——文件系统、数据库、GitHub、内部系统——每个工具都要自己写一套适配代码,非常繁琐。MCP(Model Context Protocol,模型上下文协议) 就是为了解决这个问题而提出的开放协议,由 Anthropic 发布,目标是让“AI 应用”和“外部工具/数据源”之间有一套统一的对接标准。本文从动机出发,讲清楚 MCP 的角色、能力、消息流程,带你用 SDK 写一个最小 Server,再用不依赖 SDK 的方式手写一遍协议交互来理解本质,最后总结安全注意事项、常见坑和 FAQ。
一、为什么需要 MCP
没有统一协议时,N 个 AI 应用接入 M 个工具,理论上要做 N × M 次适配。有了 MCP,工具只要实现一次 MCP Server,任何支持 MCP 的 客户端 都可以直接使用,适配工作变成 N + M。
类比:MCP 有点像 USB 接口——设备只要遵循同一接口标准,就能插到不同电脑上使用。
再具体一点,看看没有 MCP 时的典型痛点:
重复劳动:你为自己的 Agent 写了一个“查询内部工单”的函数,同事的另一个 Agent、IDE 里的助手都想用,只能各自再写一遍;
耦合严重:工具的定义和调用写死在应用代码里,工具升级就得改应用、重新发布;
生态割裂:不同框架各有自己的工具格式,无法直接复用社区已有的集成。
MCP 试图把“工具的提供方”与“工具的使用方”解耦:提供方按协议暴露能力,使用方在运行时动态发现并使用。
二、核心角色
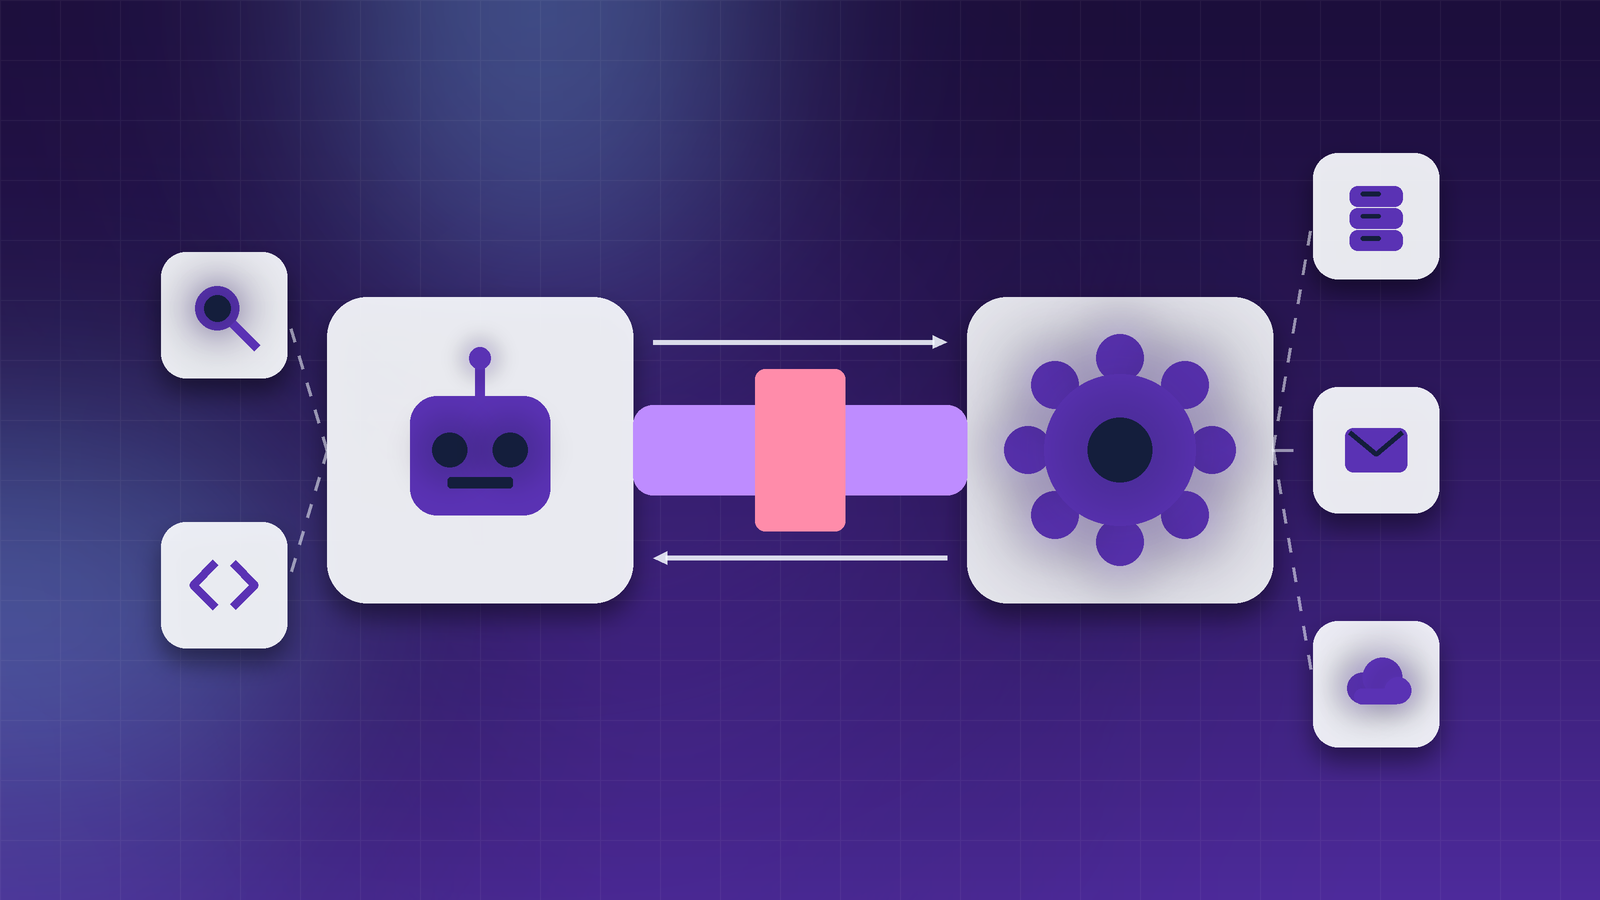
Host(宿主):用户使用的 AI 应用,例如 IDE、聊天客户端或你自己开发的 Agent 程序。
Client(客户端):Host 内部维护的连接器,与某个 Server 保持一对一连接。
Server(服务端):对外暴露能力的程序,可以是本地进程,也可以是远程服务。
 ┌───────────────── Host(AI 应用)─────────────────┐
 │   LLM  ◀──▶  MCP Client A  ◀──▶  MCP Server:文件系统 │
 │              MCP Client B  ◀──▶  MCP Server:数据库   │
 └──────────────────────────────────────────────────┘
需要注意:模型本身不直接和 Server 通信。是 Host 把 Server 暴露的工具定义交给模型,模型决定调用后,由 Host 通过 Client 向 Server 发请求,再把结果交还模型。MCP 定义的是 Host 与 Server 之间的这段“管道”。
三、Server 能提供什么
| 能力 | 含义 | 谁来决定何时使用 |
|---|---|---|
| Tools(工具) | 可被模型调用的函数,可能有副作用 | 模型 |
| Resources(资源) | 可读取的数据,如文件、数据库记录 | 应用/用户 |
| Prompts(提示模板) | 预定义的提示词模板 | 用户 |
大多数人最先接触的是 Tools,它与前文讲的 Function Calling 非常相似,区别在于:工具定义和调用不再写死在你的应用里,而是运行时从 Server 动态发现。
MCP 与直接写 Function Calling 的对比
| 维度 | 应用内自写 Function Calling | 通过 MCP 接入 |
|---|---|---|
| 工具定义位置 | 应用代码内 | Server 内,运行时发现 |
| 复用范围 | 仅当前应用 | 所有支持 MCP 的 Host |
| 升级方式 | 改应用并发布 | 升级 Server 即可(应用需处理工具变化) |
| 进程/部署 | 与应用同进程 | 可以是独立进程或远程服务 |
| 额外成本 | 无 | 多一层协议与进程管理,需要关注安全与稳定性 |
| 适用场景 | 少量、强业务绑定的工具 | 通用能力、需要跨应用共享的工具 |
可见 MCP 不是“替代” Function Calling,而是在它之上提供了一种标准化的工具提供方式。少量业务强绑定的工具,直接在应用里写往往更简单。
四、通信方式与消息格式
MCP 基于 JSON-
stdio:Host 启动本地子进程,通过标准输入输出通信,适合本地工具;
HTTP(Streamable HTTP):通过网络访问远程 Server,适合共享服务。
一次完整会话大致经历这些阶段:
初始化:Client 发送
initialize请求,声明自己支持的协议版本和能力;Server 返回它支持的版本与能力(例如是否提供 tools);Client 再发送一个notifications/initialized通知,表示准备就绪。发现能力:调用
tools/list、resources/list、prompts/list等获取 Server 提供的内容。使用能力:
tools/call调用工具,resources/read读取资源。关闭连接。
列出工具与调用工具的请求大致如下:
{"jsonrpc": "2.0", "id": 1, "method": "tools/list"}
调用工具(tools/call):
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "read_file",
    "arguments": {"path": "/data/notes.txt"}
  }
}
Server 的响应通常把结果放在 content 数组中,每一项带有类型(例如文本),并可以用 isError 标记这次调用是否失败:
{
  "jsonrpc": "2.0",
  "id": 2,
  "result": {
    "content": [{"type": "text", "text": "今天的待办:1. 写周报 2. 评审 PR"}],
    "isError": false
  }
}
这里的字段只展示了最核心的部分,完整的字段、协议版本和可选能力,请以 MCP 官方规范文档为准,协议仍在演进,不同版本之间可能有差异。
五、动手:用 SDK 写一个最小的 MCP Server
官方提供了多语言 SDK。下面以 Python SDK 的 FastMCP 风格为例(具体 API 请以你安装版本的官方文档为准)。这个版本比“加法”更贴近实际:提供一个工具和一个资源,并演示如何限制可访问的目录。
from pathlib import Path
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("notes-demo")

# 只允许访问这个目录,避免 Server 被用来读取任意文件
BASE_DIR = Path("./notes").resolve()

def _safe_path(name: str) -> Path:
    p = (BASE_DIR / name).resolve()
    if BASE_DIR not in p.parents and p != BASE_DIR:
        raise ValueError("不允许访问工作目录之外的文件")
    return p

@mcp.tool()
def add(a: int, b: int) -> int:
    """计算两个整数之和"""
    return a + b

@mcp.tool()
def read_note(name: str) -> str:
    """读取 notes 目录下指定文本文件的前 2000 个字符。name 为相对文件名,例如 todo.txt"""
    return _safe_path(name).read_text(encoding="utf-8")[:2000]

@mcp.tool()
def list_notes() -> list[str]:
    """列出 notes 目录下的所有文件名"""
    return sorted(p.name for p in BASE_DIR.iterdir() if p.is_file())

if __name__ == "__main__":
    mcp.run()   # 默认使用 stdio 传输
函数的类型注解和文档字符串会被用来生成工具的参数 Schema 与描述——这再次说明:描述写得清楚,模型才用得准。
六、不依赖 SDK:手写一遍协议交互,理解它的本质
为了破除“协议很神秘”的印象,下面用几十行 Python 手写一个只支持 tools/list 与 tools/call 的 stdio Server。它只用于学习协议形态,真实项目请使用官方 SDK,因为 SDK 处理了协议版本协商、错误码、取消、进度等大量细节。
import sys, json
TOOLS = {
"add": {
"description": "计算两个整数之和",
"inputSchema": {
"type": "object",
"properties": {"a": {"type": "integer"}, "b": {"type": "integer"}},
"required": ["a", "b"],
},
"handler": lambda args: str(args["a"] + args["b"]),
}
}
def handle(req: dict):
method = req.get("method")
if method == "initialize":
return {"protocolVersion": req["params"].get("protocolVersion"),
"capabilities": {"tools": {}},
"serverInfo": {"name": "tiny-server", "version": "0.1"}}
if method == "tools/list":
return {"tools": [{"name": n, "description": t["description"],
"inputSchema": t["inputSchema"]} for n, t in TOOLS.items()]}
if method == "tools/call":
p = req["params"]
tool = TOOLS.get(p["name"])
if tool is None:
return {"content": [{"type": "text", "text": f"未知工具 {p['name']}"}],
"isError": True}
try:
text = tool["handler"](p.get("arguments", {}))
return {"content": [{"type": "text", "text": text}], "isError": False}
except Exception as e:
return {"content": [{"type": "text", "text": f"执行失败:{e}"}], "isError": True}
return None # 未实现的方法(真实实现应返回 JSON-
这里有一个新手必踩的坑:stdio 模式下,stdout 是协议通道。如果你在代码里随手 print 调试信息,会污染协议流,导致 Client 解析失败。调试输出应该写到 stderr 或日志文件。
七、Java 视角:作为 Client 调用一个 stdio Server
如果你在做 Java 的 Agent 宿主,需要一个 Client 去连接 Server。官方也提供 Java SDK(请以官方文档和所用版本为准),下面用最朴素的方式——启动子进程并逐行收发 JSON——演示原理,方便你理解 SDK 在做什么:
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import java.io.*;
import java.util.Map;

/** 教学用的极简 stdio Client:只演示 tools/list 与 tools/call,不含完整握手与错误处理 */
public class TinyMcpClient implements AutoCloseable {
    private final ObjectMapper mapper = new ObjectMapper();
    private final Process process;
    private final BufferedWriter out;
    private final BufferedReader in;
    private int nextId = 1;

    public TinyMcpClient(String... command) throws IOException {
        this.process = new ProcessBuilder(command)
                .redirectError(ProcessBuilder.Redirect.INHERIT)   // Server 的日志走 stderr
                .start();
        this.out = new BufferedWriter(new OutputStreamWriter(process.getOutputStream(), "UTF-8"));
        this.in = new BufferedReader(new InputStreamReader(process.getInputStream(), "UTF-8"));
    }

    /** 发送一个请求并读取对应的一行响应 */
    private JsonNode request(String method, Map<String, Object> params) throws IOException {
        Map<String, Object> req = Map.of("jsonrpc", "2.0", "id", nextId++,
                "method", method, "params", params);
        out.write(mapper.writeValueAsString(req));
        out.newLine();
        out.flush();
        String line = in.readLine();
        if (line == null) throw new IOException("Server 已退出");
        JsonNode resp = mapper.readTree(line);
        if (resp.has("error")) throw new IOException("协议错误:" + resp.get("error"));
        return resp.get("result");
    }

    public JsonNode listTools() throws IOException {
        return request("tools/list", Map.of());
    }

    public String callTool(String name, Map<String, Object> args) throws IOException {
        JsonNode result = request("tools/call", Map.of("name", name, "arguments", args));
        boolean isError = result.path("isError").asBoolean(false);
        String text = result.path("content").path(0).path("text").asText("");
        return isError ? "工具报错:" + text : text;
    }

    @Override
    public void close() {
        process.destroy();
    }
}
真实项目中,还需要完成 initialize 握手、处理并发请求与通知、超时和重连。所以正式使用时,请优先选用成熟的 SDK,而把上面的代码当作“看懂它在做什么”的材料。
八、一个场景:把“内部工单系统”做成 MCP Server
假设公司有一个内部工单系统,希望不同的 AI 应用(IDE 助手、客服 Agent、运维 Agent)都能查询和处理工单。用 MCP 可以这样设计:
Tools:
search_tickets(keyword, status)(只读)、get_ticket(id)(只读)、add_comment(id, text)(写,需确认)、close_ticket(id, reason)(写,高风险,需确认);Resources:
ticket://{id}形式的只读资源,供应用按需把某张工单放进上下文;Prompts:“写一份故障复盘”模板,供用户手动选择;
鉴权:Server 使用服务账号访问工单系统,按调用者角色限制可见的项目;
审计:记录每次调用的调用方、工具名、参数与结果摘要。
好处是:工单系统的对接只写一次,任何支持 MCP 的应用接入后,都用同一套工具定义;代价是你需要像维护一个正式的内部服务一样,维护它的鉴权、限流、日志和版本。
九、使用 MCP 时的注意事项
只接入可信的 Server:Server 的工具描述和返回内容都会进入模型上下文,恶意内容可能进行提示词注入。
最小权限:给 Server 的文件路径、数据库账号都应限制范围,写操作默认需要用户确认。
别一次接入太多:工具过多会占用上下文并降低选择准确率,按场景启用。
认证与审计:远程 Server 要有认证机制,并记录调用日志。
补充几点容易忽视的风险:
工具描述可能在你不知情时变化:Server 更新后,工具的描述或行为可能改变。对重要 Server 应固定版本,升级前复核工具列表;
同名工具冲突:接入多个 Server 时,可能出现名称相同或相近的工具,需要用前缀或命名空间区分;
返回内容同样不可信:Server 返回的文本要当作“数据”而非“指令”处理,不要让它直接触发高风险操作。
十、多个 Server 组合时:工具命名与按场景启用
单个 Server 很好管理,真正的挑战出现在同时接入多个 Server 时。假设你的 Agent 同时连接了“文件系统”“工单系统”“数据库”三个 Server,它们各自暴露了 search、get、list 之类的通用名称,模型看到三个 search,根本无法区分。
常见的应对办法有:
加命名空间前缀:Host 在把工具交给模型之前,统一改名为
tickets__search、files__search、db__query,调用时再还原成原名转发给对应 Server;按场景启用:不要默认启用全部 Server。例如“排查故障”场景只启用监控和工单,“写文档”场景只启用文件系统,由用户或路由逻辑选择;
工具检索:当总工具数量仍然很多时,先用一次轻量的检索或分类,从全部工具中挑出与当前请求相关的一小部分,再提供给模型;
写工具单独管控:把只读工具与写工具分开标记,只读默认放行,写工具需要确认。
这些都是 Host 侧的职责,协议本身并不替你做。所以“接入 MCP”不等于“工具管理问题被解决了”,它只是把工具的提供方式标准化了,工具的治理仍然需要你自己设计。
十一、常见坑与解决办法
| 坑 | 表现 | 解决办法 |
|---|---|---|
| stdout 被污染 | Client 报 JSON 解析错误 | stdio Server 只向 stdout 写协议消息,日志写 stderr |
| 工具太多 | 模型选错工具,上下文被撑大 | 按场景启用子集,或先做工具检索 |
| 路径越权 | 工具能读取任意文件 | 规范化路径,限制在白名单目录内 |
| 工具描述含糊 | 模型不知道何时调用 | 像写 API 文档一样写清用途、参数、限制 |
| 版本不兼容 | 升级 SDK 后握手失败 | 固定版本,阅读变更说明,升级前回归测试 |
| 子进程僵死 | Host 退出后 Server 进程残留 | 管理子进程生命周期,退出时显式关闭 |
| 写操作无确认 | 模型直接执行了删除/发送 | 在 Host 侧对高风险工具强制人工确认 |
十二、接入与上线检查清单
☐ 明确每个 MCP Server 的来源,仅使用可信或自研的 Server。
☐ Server 版本已固定,升级有回归流程。
☐ 文件、数据库、网络访问均限制在最小范围。
☐ 写操作与高风险工具在 Host 侧需要确认。
☐ 工具描述清晰,数量受控。
☐ 日志包含调用方、工具、参数摘要与耗时,敏感信息已脱敏。
☐ 远程 Server 有认证与限流。
☐ 准备了针对“恶意工具描述/返回内容”的测试用例。
十三、常见问题(FAQ)
Q1:MCP 会取代 Function Calling 吗?不会。Function Calling 是模型表达“要调用工具”的接口能力,MCP 是工具提供方与 Host 之间的标准协议。Host 通常仍会通过模型的 Function Calling 能力让模型选择工具,只是这些工具的定义来自 MCP Server。
Q2:我的 Agent 应该把所有工具都做成 MCP Server 吗?没必要。通用、需要跨应用复用的能力适合做成 MCP Server;业务强绑定、只在本应用内使用的少量工具,直接写在应用里更简单、更可控。
Q3:stdio 和 HTTP 怎么选?本地、单用户、随 Host 启动的工具适合 stdio,部署简单;需要多人共享、集中管理、远程访问的服务适合 HTTP,但要额外处理认证、限流与网络安全。
Q4:Server 的“资源”和“工具”有什么区别?资源偏向“读取数据”,由应用或用户决定何时放入上下文;工具是“可被模型调用的动作”,可能带副作用。需要模型自主决定时调用的用工具,想让用户或应用主动挑选内容的用资源。
十四、小结与下一步
MCP 的价值在于 标准化与生态复用:工具写一次,多处可用。如果你在做 Agent,推荐把通用能力(文件、数据库、内部系统)封装成 MCP Server,而把业务逻辑留在 Agent 本身。
建议的下一步:
用官方 SDK 写一个只读的小 Server,并在任意支持 MCP 的客户端中接入;
手动发送
tools/list与tools/call,亲自看一遍协议消息;为 Server 增加路径限制、日志与错误处理;
回到前面的文章,把安全、评测与可观测性的要求套用到 MCP 工具上——这部分在后续文章里会继续展开。
 2026-09-30鱼鱼