
简单问题一两步就能搞定,但“调研三个竞品并写一份对比报告”这类任务,如果让模型边想边做,很容易跑偏、遗漏或重复。规划(Planning) 就是让 Agent 在动手之前,先把大任务拆成可执行的小步骤。本文从动机讲起,比较三种常见规划模式,给出结构化计划的数据格式,以及一个带依赖调度、失败重试和重规划的完整 Python 示例,并附上 Java 版的计划模型、常见坑和检查清单。
一、背景:边想边做为什么会“跑偏”
回忆一下 ReAct:模型每一步只决定“下一步做什么”。这在短链路任务里很灵活,但当任务变长,会出现几类典型问题:
目标漂移:做到第 10 步,模型被中间的工具结果带偏,开始回答另一个问题;
遗漏:任务包含 5 个要点,模型只完成了 3 个就宣布“完成”,因为没有清单可以对照;
重复劳动:同一份资料反复查询,因为它不记得自己已经查过;
无法并行:即使几个子任务互不依赖,串行的“边想边做”也只能一个一个来;
难以审阅:人类只能看到一串流水账,难以在执行前纠正方向。
规划的核心价值可以概括为:把“隐含在模型脑中的计划”变成“显式、可检查、可追踪的数据”。一旦计划成为数据,程序就能调度它、持久化它、评估它,人也能审阅和修改它。
二、为什么需要规划
长任务中模型容易“忘记”最初目标;
没有清单,就无法判断“做完了没有”;
拆分后的子任务可以 并行执行、单独重试、单独评估;
人类可以审阅计划,在执行前纠正方向。
三、三种常见规划模式
边想边做(ReAct):每步只决定下一步。灵活,适合短链路、不确定性高的任务。
先规划后执行(Plan-and-Execute):先生成完整计划,再逐步执行,每步结果可选择性回写计划。适合步骤较明确的任务。
层次化分解:目标 → 阶段 → 具体动作,逐层细化,适合大型任务。
目标:写一份“三款 Java 框架”对比报告
 ├─ 1. 确定对比维度(性能、生态、学习曲线)
 ├─ 2. 收集资料
 │    ├─ 2.1 框架 A
 │    ├─ 2.2 框架 B
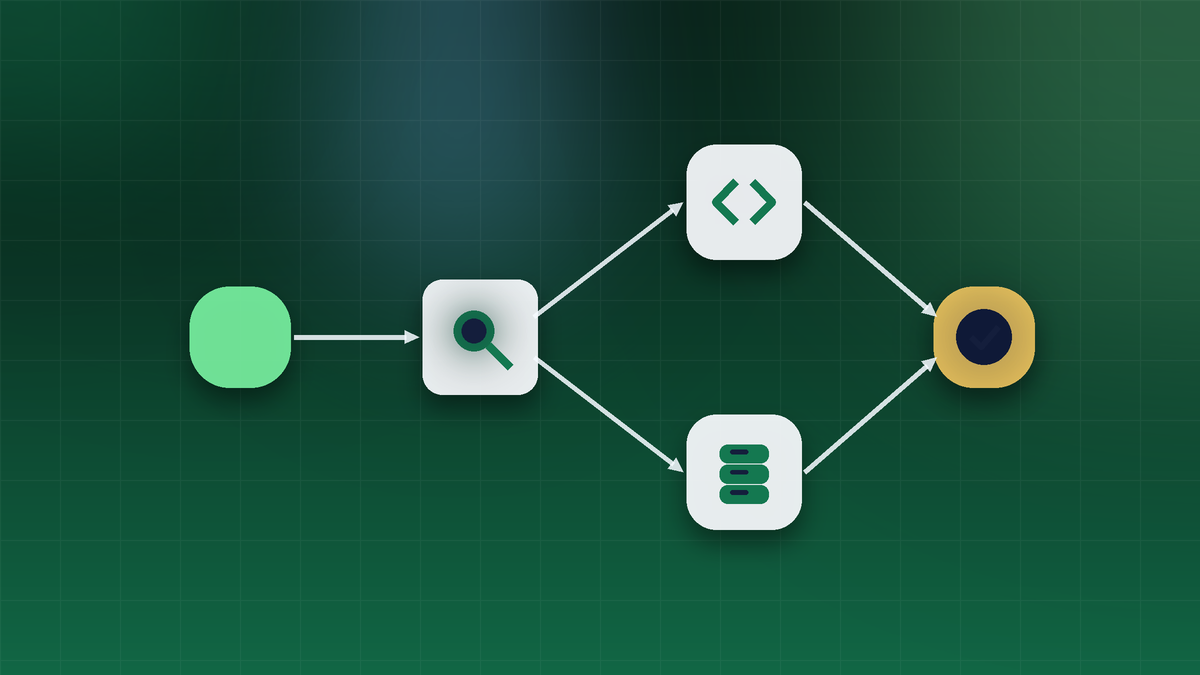
 │    └─ 2.3 框架 C      ← 三者互不依赖,可并行
 ├─ 3. 汇总成对比表
 └─ 4. 撰写结论并自检
模式对比与选择
| 维度 | 边想边做 | 先规划后执行 | 层次化分解 |
|---|---|---|---|
| 灵活性 | 高 | 中 | 中 |
| 可预测性 | 低 | 较高 | 高 |
| 能否并行 | 难 | 可以(按依赖) | 可以 |
| 计划成本 | 无 | 多一次规划调用 | 多轮规划调用 |
| 失效方式 | 跑偏、重复 | 计划与现实脱节 | 层次过深,开销大 |
| 适合任务 | 探索式、短链路 | 步骤较明确的中等任务 | 大型、多阶段任务 |
一个简单的选择思路:能预先知道大致步骤就用 Plan-and-Execute;步骤完全取决于中间结果就用 ReAct;任务太大就分层。 三者也可以混合——外层用计划保证方向,每个步骤内部用 ReAct 灵活完成。
四、让模型输出结构化计划
计划最好是机器可读的 JSON,方便程序追踪状态:
{
  "goal": "写一份三款 Java 框架对比报告",
  "steps": [
    {"id": 1, "task": "确定对比维度", "depends_on": [], "status": "todo"},
    {"id": 2, "task": "收集框架 A 资料", "depends_on": [1], "status": "todo"},
    {"id": 3, "task": "收集框架 B 资料", "depends_on": [1], "status": "todo"},
    {"id": 4, "task": "汇总对比表", "depends_on": [2, 3], "status": "todo"}
  ]
}
有了 depends_on,调度器就可以找出“依赖已满足”的步骤并行执行。实践中建议让每个步骤再多带两个字段:
done_when:完成标准,例如“产出一张包含 3 个维度、3 个框架的表格”;max_retries:该步骤允许的重试次数。
“完成标准”是规划质量的关键:没有它,模型很容易交出一个看起来完成、实际不达标的结果。
提示词怎么写
你是任务规划器。请把用户目标拆成 3~8 个步骤,只输出 JSON。
要求:
1. 每个步骤包含 id、task、depends_on、done_when;
2. 步骤必须是“一次工具调用或一次小型子任务就能完成”的粒度;
3. 互不依赖的步骤不要写依赖关系,以便并行;
4. 不要包含与目标无关的步骤;不确定的地方在 task 中写明“需先确认”。
程序拿到计划后要做校验:id 是否唯一、依赖是否引用了存在的步骤、是否存在循环依赖。
五、一个完整的 Plan-and-Execute 示例(Python)
下面的代码包含:计划校验(环检测)、按依赖并行调度、步骤重试,以及连续失败时触发重规划。llm_make_plan、run_sub_agent、llm_replan 需要你接入真实模型,控制流本身可以直接使用。
from concurrent.futures import ThreadPoolExecutor
from dataclasses import dataclass, field

@dataclass
class Step:
    id: int
    task: str
    depends_on: list[int] = field(default_factory=list)
    done_when: str = ""
    status: str = "todo"          # todo / running / done / failed
    result: str = ""
    retries: int = 0

def validate_plan(steps: list[Step]):
    ids = {s.id for s in steps}
    if len(ids) != len(steps):
        raise ValueError("步骤 id 重复")
    for s in steps:
        for d in s.depends_on:
            if d not in ids:
                raise ValueError(f"步骤 {s.id} 依赖了不存在的步骤 {d}")
    # 用拓扑排序检测循环依赖
    indeg = {s.id: len(s.depends_on) for s in steps}
    queue = [i for i, n in indeg.items() if n == 0]
    seen = 0
    while queue:
        cur = queue.pop()
        seen += 1
        for s in steps:
            if cur in s.depends_on:
                indeg[s.id] -= 1
                if indeg[s.id] == 0:
                    queue.append(s.id)
    if seen != len(steps):
        raise ValueError("计划存在循环依赖")

def run_step(step: Step, done_results: dict[int, str]) -> Step:
    # 只把“依赖步骤的结果”传给子 Agent,而不是整个历史,保持上下文干净
    context = {d: done_results[d] for d in step.depends_on}
    try:
        step.result = run_sub_agent(step.task, context, step.done_when)
        step.status = "done"
    except Exception as e:
        step.retries += 1
        step.result = f"失败:{e}"
        step.status = "todo" if step.retries <= 2 else "failed"   # 最多重试 2 次
    return step

def plan_and_execute(goal: str, max_replans: int = 2) -> str:
    steps = llm_make_plan(goal)                  # 返回 list[Step]
    validate_plan(steps)
    replans = 0
    with ThreadPoolExecutor(max_workers=4) as pool:
        while True:
            done = {s.id: s.result for s in steps if s.status == "done"}
            if all(s.status == "done" for s in steps):
                break
            if any(s.status == "failed" for s in steps):
                if replans >= max_replans:
                    raise RuntimeError("多次重规划后仍失败,转人工处理")
                steps = llm_replan(goal, steps)   # 保留已完成步骤,重排剩余步骤
                validate_plan(steps)
                replans += 1
                continue
            ready = [s for s in steps if s.status == "todo"
                     and all(d in done for d in s.depends_on)]
            if not ready:
                raise RuntimeError("没有可执行的步骤,计划可能存在问题")
            list(pool.map(lambda s: run_step(s, done), ready))   # 并行执行就绪步骤
    return summarize(goal, steps)
这个骨架体现了几个设计取舍:
子 Agent 只拿到依赖步骤的结果:这是“上下文隔离”,避免每个步骤都背着整个历史;
重试与重规划分层:单步失败先重试;重试仍失败才重规划,并限制次数;
最终兜底是人:重规划次数用完后,把状态交给人处理,而不是无限循环。
六、Java 版:计划的数据模型与就绪步骤筛选
在 Java 服务里,建议把计划建模为不可变对象加一个简单的调度方法,状态变更集中在一处,便于持久化和审计:
import java.util.*;
import java.util.stream.Collectors;

public class Plan {
    public enum Status { TODO, RUNNING, DONE, FAILED }

    public static class Step {
        public final int id;
        public final String task;
        public final List<Integer> dependsOn;
        public final String doneWhen;       // 完成标准
        public Status status = Status.TODO;
        public String result = "";
        public int retries = 0;

        public Step(int id, String task, List<Integer> dependsOn, String doneWhen) {
            this.id = id;
            this.task = task;
            this.dependsOn = dependsOn;
            this.doneWhen = doneWhen;
        }
    }

    private final String goal;
    private final List<Step> steps;

    public Plan(String goal, List<Step> steps) {
        this.goal = goal;
        this.steps = steps;
    }

    /** 找出所有“自己待办、且依赖全部完成”的步骤,可交给线程池并行执行 */
    public List<Step> readySteps() {
        Set<Integer> done = steps.stream()
                .filter(s -> s.status == Status.DONE)
                .map(s -> s.id)
                .collect(Collectors.toSet());
        return steps.stream()
                .filter(s -> s.status == Status.TODO && done.containsAll(s.dependsOn))
                .collect(Collectors.toList());
    }

    public boolean isFinished() {
        return steps.stream().allMatch(s -> s.status == Status.DONE);
    }

    public boolean hasFailed() {
        return steps.stream().anyMatch(s -> s.status == Status.FAILED);
    }

    public String goal() { return goal; }
    public List<Step> steps() { return steps; }
}
调度循环里,拿到 readySteps() 后用 ExecutorService 并行执行,完成后更新状态并把整个 Plan 序列化保存。这样服务重启后可以从数据库中读出计划继续执行,即 断点续跑。
七、重新规划与失败处理
计划不是圣旨。执行过程中常见需要调整的情况:
某步骤失败或结果与预期不符;
发现了新信息,需要增删步骤;
用户中途修改了需求。
建议设置重规划触发条件(例如连续两次失败),并限制重规划次数,避免无限打转。重规划时要把这些信息交给模型:原始目标、已完成步骤及其结果、失败步骤及原因,并明确要求“不要重做已完成的步骤”。
一个失败场景的走查
继续用“三款框架对比”这个任务:步骤 3(收集框架 B 资料)因为检索工具超时失败了两次。
调度器把步骤 3 标为
failed,触发重规划;重规划提示词包含:已完成的步骤 1、2 的结果,以及“步骤 3 因检索超时失败”的信息;
模型可能给出调整方案:把步骤 3 改为“用备用数据源收集框架 B 资料”,或者缩小范围“只收集框架 B 的三项核心特性”;
新计划通过校验后继续执行,步骤 1、2 不会重跑。
如果重规划后仍然失败,就把当前状态(已完成的产出、卡住的步骤、原因)整理给用户,让人决定是换思路还是放弃,而不是悄悄返回一份残缺的报告。
八、完整案例:把“周报整理”拆成可执行的计划
再看一个更贴近日常工作的例子。用户的需求是:“把本周的 Git 提交记录、工单系统里的已关闭工单和会议纪要整理成一份周报,要求分为‘完成事项、遇到的问题、下周计划’三部分。”
第一步:判断是否需要规划。 这个任务涉及三个数据源,最后还要汇总和排版,步骤数大于 3,且数据源之间互不依赖,适合规划,并且能并行。
第二步:生成粗粒度计划。
| 步骤 | 内容 | 依赖 | 完成标准 |
|---|---|---|---|
| 1 | 拉取本周 Git 提交并按模块归类 | 无 | 得到按模块分组的提交摘要 |
| 2 | 拉取本周已关闭工单并归类 | 无 | 得到工单列表及类型 |
| 3 | 读取会议纪要并提取结论与待办 | 无 | 得到结论清单与待办清单 |
| 4 | 合并为“完成事项”与“遇到的问题” | 1、2、3 | 两个部分均有条目,且每条可追溯来源 |
| 5 | 基于待办生成“下周计划” | 3、4 | 计划条目有负责人或时间点(若来源中没有,则标注“待确认”) |
| 6 | 整体排版并自检 | 4、5 | 三部分齐全,没有编造来源中不存在的内容 |
第三步:并行执行。 步骤 1、2、3 互不依赖,同时执行;它们都完成后才会解锁步骤 4。如果此时步骤 2 的工单系统接口超时,调度器只重试步骤 2,步骤 1、3 的结果不受影响。
第四步:自检。 步骤 6 不是“再写一遍”,而是对照完成标准逐项核查,例如“每一条完成事项是否都能对应到提交记录或工单号”。这一步能有效拦截模型“顺手编造”的内容。
这个案例里,规划带来的收益很具体:并行节省时间、失败局部重试、每一步可单独评估、最终有明确的验收标准。如果把它交给纯 ReAct,模型往往会读了提交记录就开始写,漏掉会议纪要,或者在三个数据源之间来回反复。
九、实践建议
| 问题 | 建议 |
|---|---|
| 步骤过细,成本高 | 让每个步骤对应一个“可验证的产出” |
| 步骤过粗,仍会跑偏 | 递归拆分,直到能用一个工具或一次调用完成 |
| 计划质量不稳定 | 给出计划示例,并要求包含“完成标准” |
| 长任务中断 | 持久化计划状态,支持断点续跑 |
| 并行导致结果冲突 | 并行的步骤不要写同一份资源;合并步骤统一处理冲突 |
| 计划被用户改动 | 允许人工编辑计划 JSON,程序重新校验后继续 |
规划不是越详细越好,而是要 恰好让每一步都可验证、可重试。
十、一个真实感受:先粗后细
很多人第一次做规划时,会让模型生成十几步甚至几十步的“超详细计划”,结果执行时第三步就与现实脱节。更稳妥的做法是:先给粗粒度计划,只对即将执行的下一两步做细化。这样既保留了方向感,又能吸收执行中获得的新信息,也减少了因为计划过长而浪费的 token。
十一、常见坑与修复
| 坑 | 表现 | 修复 |
|---|---|---|
| 计划与现实脱节 | 后续步骤引用了并不存在的数据 | 只细化近期步骤;每步执行后检查是否需要调整 |
| 循环依赖 | 调度器找不到可执行步骤 | 计划生成后做拓扑检查,不通过则让模型重写 |
| 无限重规划 | 每次都换个新计划,永远做不完 | 限制重规划次数,超限转人工 |
| 完成标准缺失 | 步骤“做完了”但质量不达标 | 要求 done_when,并在步骤结束后做一次核对 |
| 子任务上下文过大 | 子 Agent 被无关历史干扰 | 只传入依赖步骤的必要结果 |
| 规划本身太贵 | 简单任务也先规划一轮 | 按任务复杂度路由:简单任务直接 ReAct |
十二、规划落地检查清单
☐ 复杂度路由:简单任务不走规划流程。
☐ 计划是结构化数据,包含依赖与完成标准。
☐ 计划经过校验(id、依赖、环)。
☐ 独立步骤可并行,共享资源写入已处理冲突。
☐ 单步有重试上限,重规划有次数上限。
☐ 计划状态可持久化,支持断点续跑。
☐ 关键计划可由人审阅、编辑后再执行。
☐ 日志里记录了每次计划版本及变更原因。
十三、常见问题(FAQ)
Q1:规划一定比 ReAct 好吗?不是。规划带来可控性,但增加了一次甚至多次模型调用,并且计划可能与现实脱节。任务简短、步骤取决于中间结果时,ReAct 更合适。
Q2:计划应该由同一个模型生成,还是用更强的模型?规划质量影响全局,许多团队会让较强的模型做规划,较小的模型执行具体步骤。这是一个成本与质量的权衡,建议用自己的评测集比较后再决定。
Q3:并行执行会不会让结果不稳定?可能。如果并行步骤读写同一份资源,会产生冲突。保证并行步骤相互独立,由单独的“汇总”步骤合并它们的输出,可以避免大部分问题。
Q4:怎么判断计划“好不好”?看三点:每一步是否可验证(有完成标准)、依赖是否合理(没有多余的串行)、是否覆盖了目标的全部要点。可以在评测集中对计划本身打分,例如“是否遗漏了关键步骤”。
十四、小结与下一步
对于简单任务,ReAct 已足够;一旦任务变长、变复杂,就引入显式计划、依赖关系和重规划机制。核心是三点:计划要结构化、步骤要可验证、失败要有出口。
建议的下一步:
选一个你已有的多步任务,手写一份带依赖与完成标准的计划 JSON,看看能否发现以前遗漏的步骤;
用上面的调度骨架把它跑起来,并故意让某一步失败,验证重试与重规划;
继续阅读后面的文章,让多个 Agent 分工执行这些子任务。
 2026-09-30鱼鱼