
Agent 能不能“动手”,取决于工具调用。很多团队发现:模型明明够聪明,却总是选错工具、传错参数。问题往往不在模型,而在 工具设计。这篇文章从背景出发,讲清楚工具调用的完整流程,总结六条实用的设计原则,给出 Python 与 Java 两套防御式代码,并列出常见坑和检查清单。
一、背景与动机:为什么工具设计这么重要
大模型只能输出文字。让它“查天气”“下订单”“读数据库”,中间必须有一层翻译:模型用结构化的方式说出“我想做什么”,你的程序把它变成真实的函数调用。这一层翻译的质量,取决于你给模型的“说明书”写得怎么样。
可以做个类比:工具定义之于模型,就像 API 文档之于新入职的后端同事。文档含糊、接口职责重叠、错误信息只有一个 500,再聪明的同事也会反复踩坑。模型甚至更“吃亏”——它无法追问你,也无法翻看源码,只能依赖你给的那几行描述。
因此,工具调用的问题可以分成两类:
模型侧问题:选错工具、漏传参数、参数格式不对、编造不存在的取值;
程序侧问题:没有校验就执行、错误信息不可读、返回值过大、重试造成重复写入。
前者主要靠把工具定义写好来缓解,后者靠防御式编程来兜底。两边都做,才算“好用”。
二、工具调用的基本流程
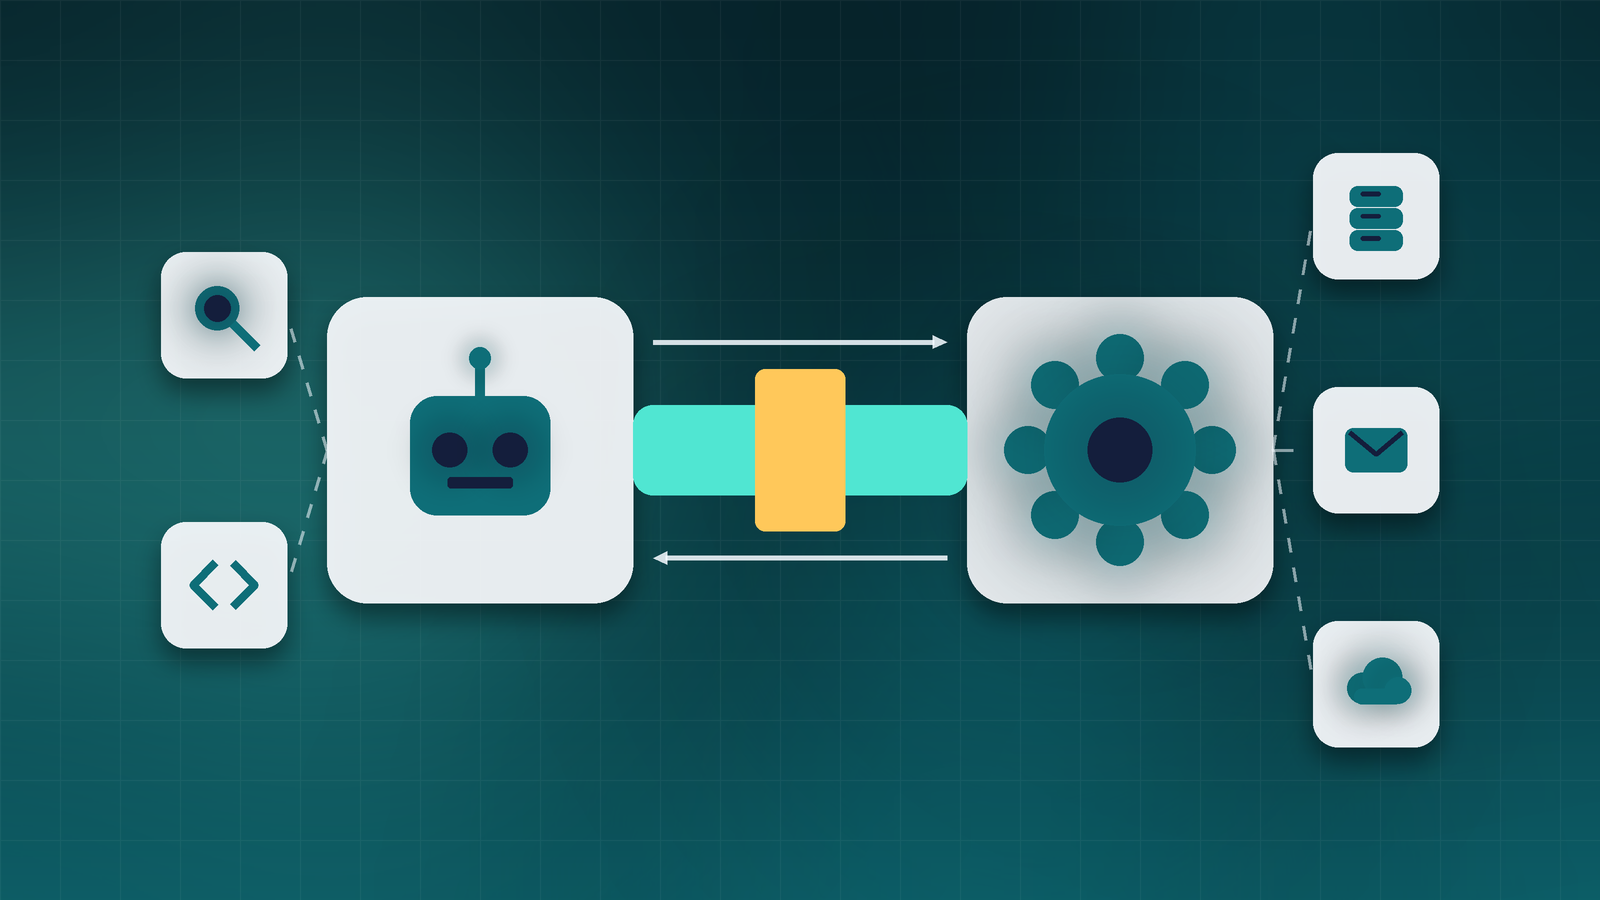
Function Calling 的本质是:你把工具的“说明书”(名称、描述、参数的 JSON Schema)随请求发给模型;模型不会真的执行函数,而是返回“我想调用哪个工具、参数是什么”;由你的程序执行,再把结果回传给模型。
应用把
tools列表和用户消息一起发送给模型。模型返回一个结构化的调用请求(工具名 + JSON 参数)。
应用校验参数并执行真实函数。
应用把执行结果作为
tool消息追加到对话。模型据此继续推理,或给出最终回答。
 用户消息 + tools 说明书
        │
        ▼
   ┌─────────┐   ① 返回 {name, arguments}   ┌────────────┐
   │  大模型  │ ───────────────────────────▶ │  你的程序   │
   └─────────┘                              │ 校验 → 执行 │
        ▲                                   └─────┬──────┘
        │        ② tool 消息(执行结果)           │
        └──────────────────────────────────────────┘
有两个容易被忽略的事实:一是模型可能在一次回复里同时请求多个工具调用(并行调用),你的程序要能逐个处理并分别回传结果;二是不同厂商的字段命名和消息格式并不完全一致,本文的代码用的是通用的示意结构,接入时请以所用模型 SDK 的文档为准。
三、一个好的工具定义长什么样
看一个查询天气的工具定义:
{
  "name": "get_weather",
  "description": "查询指定城市未来 1~7 天的天气预报。仅用于天气问题,不能查询历史天气。",
  "parameters": {
    "type": "object",
    "properties": {
      "city": {
        "type": "string",
        "description": "城市中文名,例如“杭州”,不要带“市”字"
      },
      "days": {
        "type": "integer",
        "minimum": 1,
        "maximum": 7,
        "description": "预报天数,默认 3"
      }
    },
    "required": ["city"]
  }
}
好的定义有几个特点:名字是动词短语、描述写清适用与不适用场景、参数有类型、范围和示例、必填项明确。
反面教材:同一个功能的两种写法
| 对比项 | 不好的写法 | 好的写法 |
|---|---|---|
| 名称 | weather / tool1 |
get_weather |
| 描述 | “天气工具” | “查询指定城市未来 1~7 天的天气预报;不能查历史天气” |
| 参数类型 | query: string(自由文本) |
city: string + days: integer(1~7) |
| 取值范围 | 未说明 | 写明范围与默认值 |
| 必填项 | 全部可选 | city 必填 |
| 失败时返回 | Error |
“city 不存在,可选值示例:杭州、上海” |
左边的写法并不是不能用,而是把“猜”的成本全部转嫁给了模型。
四、六条设计原则
单一职责:一个工具只做一件事。
manage_order(action=...)这种“万能工具”会让模型难以选择,拆成create_order、cancel_order更稳。描述面向模型,而非面向人:写清“什么时候该用、什么时候别用”,比写功能介绍更有价值。
参数尽量少且尽量结构化:能用枚举就不要用自由文本,能给默认值就不要求必填。
返回值精简:只返回模型下一步需要的信息。一次返回几万字的原始 JSON,会挤爆上下文。
错误信息要可行动:不要只返回
Error 500,而要返回“city 参数不存在,可选值:杭州、上海……”,模型才能自我修正。幂等与可重试:模型可能重复调用,写操作最好支持幂等键。
用一个场景把原则串起来:订单客服 Agent
假设你在做电商客服 Agent,用户说“把我昨天那单取消掉”。如果只有一个 manage_order 万能工具,模型要在 action 字段里猜 cancel 还是 CANCEL 还是 cancel_order;而拆分后:
list_orders(user_id, days):先查最近订单,返回精简字段(订单号、商品名、状态、金额),不返回整张订单表;cancel_order(order_id, reason, idempotency_key):只做取消,且声明“仅当订单状态为‘待发货’时可取消”;如果订单已发货,工具返回“订单 A123 已发货,无法取消,可改用 create_return_request”——把下一步建议写进错误信息里。
这样模型自然形成“先查、再确认、再取消”的链路,也不容易在“取消”上出现重复扣退款,因为幂等键保证了同一个请求只生效一次。
五、程序侧:校验、执行与容错(Python 版)
模型给的参数永远不可信,必须像处理用户输入一样处理。下面是一个更完整的执行器,包含注册、校验、超时、截断和错误分类:
import json
from concurrent.futures import ThreadPoolExecutor, TimeoutError as FutTimeout
from dataclasses import dataclass
from typing import Any, Callable
from jsonschema import validate, ValidationError

@dataclass
class ToolSpec:
    name: str
    description: str
    schema: dict                      # 参数的 JSON Schema
    run: Callable[..., Any]
    timeout_s: float = 10.0           # 每个工具单独的超时
    max_output_chars: int = 2000      # 返回给模型的最大长度

REGISTRY: dict[str, ToolSpec] = {}
_pool = ThreadPoolExecutor(max_workers=8)

def register(spec: ToolSpec):
    REGISTRY[spec.name] = spec

def truncate(text: str, limit: int) -> str:
    if len(text) <= limit:
        return text
    return text[:limit] + f"…(已截断,原长度 {len(text)},如需更多请缩小查询范围)"

def execute_tool(name: str, raw_args: Any) -> str:
    """返回值永远是字符串:成功是结果,失败是“可行动”的错误说明。"""
    tool = REGISTRY.get(name)
    if tool is None:
        return f"未知工具 {name},可用工具:{list(REGISTRY)}"

    # 1) 参数可能是 JSON 字符串,也可能已经是 dict
    if isinstance(raw_args, str):
        try:
            raw_args = json.loads(raw_args)
        except json.JSONDecodeError as e:
            return f"参数不是合法 JSON:{e}"

    # 2) 按 Schema 校验,失败则把原因告诉模型
    try:
        validate(instance=raw_args, schema=tool.schema)
    except ValidationError as e:
        path = ".".join(map(str, e.path)) or "(根)"
        return f"参数不合法(位置 {path}):{e.message}"

    # 3) 带超时地执行,异常分类处理
    future = _pool.submit(tool.run, **raw_args)
    try:
        result = future.result(timeout=tool.timeout_s)
    except FutTimeout:
        return f"工具 {name} 执行超过 {tool.timeout_s} 秒,请稍后重试或换一种方式"
    except PermissionError as e:
        return f"没有权限:{e}"          # 不要让模型反复重试权限问题
    except Exception as e:
        return f"工具执行失败:{type(e).__name__}: {e}"

    # 4) 控制返回长度
    text = result if isinstance(result, str) else json.dumps(result, ensure_ascii=False)
    return truncate(text, tool.max_output_chars)
需要留意:Python 的线程池超时只是“不再等待”,并不能强制终止已经在运行的线程。对于真正可能卡死的操作(外部进程、网络请求),应在工具内部使用自身的超时参数,或者放进独立进程中执行。
六、程序侧:Java 版的工具接口与执行器
如果你的后端是 Java,同样的思路可以用接口加统一执行器来实现。下面的示例不依赖具体的模型 SDK:
import java.util.Map;
import java.util.concurrent.*;

/** 所有工具实现的统一接口 */
public interface Tool {
    String name();
    String description();
    String schemaJson();                      // 参数的 JSON Schema
    String run(Map<String, Object> args) throws Exception;
}

/** 统一执行器:校验、超时、错误转换都在这里,工具本身只关心业务 */
public class ToolExecutor {
    private final Map<String, Tool> registry;
    private final ExecutorService pool = Executors.newFixedThreadPool(8);
    private static final int MAX_OUTPUT = 2000;
    private static final long TIMEOUT_SECONDS = 10;

    public ToolExecutor(Map<String, Tool> registry) {
        this.registry = registry;
    }

    public String execute(String name, Map<String, Object> args) {
        Tool tool = registry.get(name);
        if (tool == null) {
            // 告诉模型可用工具,帮助它自我纠正
            return "未知工具 " + name + ",可用工具:" + registry.keySet();
        }
        String invalid = validate(tool, args);      // 用 JSON Schema 校验库实现
        if (invalid != null) {
            return "参数不合法:" + invalid;
        }
        Future<String> future = pool.submit(() -> tool.run(args));
        try {
            String out = future.get(TIMEOUT_SECONDS, TimeUnit.SECONDS);
            return out.length() > MAX_OUTPUT
                    ? out.substring(0, MAX_OUTPUT) + "…(已截断)"
                    : out;
        } catch (TimeoutException e) {
            future.cancel(true);                    // 尝试中断执行线程
            return "工具超时,请稍后重试或换一种方式";
        } catch (ExecutionException e) {
            // 只暴露必要信息,避免把堆栈或内部细节泄露给模型
            return "工具执行失败:" + e.getCause().getClass().getSimpleName()
                    + ": " + e.getCause().getMessage();
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
            return "执行被中断";
        }
    }

    private String validate(Tool tool, Map<String, Object> args) {
        // 这里可以接入 networknt/json-schema-validator 等库;示例仅返回 null 表示通过
        return null;
    }
}
注意 future.cancel(true) 只是向线程发送中断信号,工具内部如果不响应中断(例如阻塞在某些 IO 上),仍然可能继续运行,所以工具内部依然需要各自的超时设置。
七、幂等与重试:写操作的安全垫
模型重复调用同一个写操作,在实践中并不罕见:可能是它没有看清上次的结果,也可能是网络超时后程序重试了。对写操作的建议:
让模型(或你的程序)为每次“意图”生成一个 幂等键(idempotency key),例如
user_id + 订单号 + 动作;工具端收到重复的键时,直接返回上次的结果,而不是再执行一次;
区分“可重试错误”(超时、限流)和“不可重试错误”(参数错误、无权限),前者做有限次退避重试,后者直接回传给模型。
_done: dict[str, str] = {}   # 示例用内存字典;生产环境请用数据库或 Redis 并设置过期

def cancel_order(order_id: str, reason: str, idempotency_key: str) -> str:
    if idempotency_key in _done:
        return _done[idempotency_key] + "(重复请求,已返回上次结果)"
    result = do_cancel(order_id, reason)      # 真正的业务逻辑
    _done[idempotency_key] = result
    return result
八、工具数量与选择
| 工具数量 | 常见现象 | 建议 |
|---|---|---|
| 1~5 个 | 选择准确,描述容易维护 | 入门首选 |
| 5~20 个 | 偶尔混淆相似工具 | 用清晰命名与分组,描述中写明区别 |
| 20 个以上 | 选择准确率下降,提示词变长 | 先做一次“工具检索/路由”,只暴露相关的子集 |
这里的数量区间是经验性的参考,并非严格界限;不同模型、不同工具的相似度会使结果差别很大,建议用自己的评测集验证。
经验法则:如果你自己读工具描述都要犹豫用哪个,模型大概率也会犹豫。
九、如何迭代工具描述:用失败样本驱动修改
工具描述不是一次写完的,而是靠观察失败逐步打磨。一个朴素但有效的流程是:
收集失败样本:从日志里找出“该调 A 却调了 B”“参数填错”的真实对话,每类至少留几条;
归因:是描述没说清、两个工具职责重叠,还是参数缺少约束?不同原因的修法不同;
只改一处:每次只修改一个工具的描述或一个参数的约束,避免多处同时改动后无法判断哪一处起了作用;
回归评测:用同一批样本重新跑一遍,既要看失败样本是否改善,也要看原本正确的样本有没有被改坏;
沉淀规则:把反复出现的问题写进团队的工具设计规范,例如“所有日期参数统一用 ISO 8601 格式”“所有 ID 类参数必须说明从哪个工具获取”。
这里有个很实用的小技巧:在描述里直接写“与其他工具的区别”。例如 search_docs 的描述里加一句“用于查询内部知识库;如果要查互联网公开信息,请使用 web_search”,往往比调整系统提示更有效。
十、常见坑与修复办法
| 坑 | 表现 | 修复 |
|---|---|---|
| 万能工具 | 参数里有 action 字段,模型乱填 |
拆成多个单一职责工具 |
| 返回整表 | 一次返回几千行,后续推理变差 | 分页、只返回必要字段、提供“按条件过滤”参数 |
| 错误信息不可读 | 模型反复用同样的错误参数重试 | 错误里写明原因和可选值 |
| 信任模型参数 | 出现 SQL 拼接、路径穿越 | 用参数化查询、白名单、路径规范化 |
| 相似工具过多 | 总在 A、B 之间选错 | 合并或在描述里写明“与 B 的区别” |
| 枚举值写在自然语言里 | 模型写出近义词 | 在 Schema 中使用 enum |
| 忽略并行调用 | 只处理了第一个调用,漏掉其余 | 遍历所有调用并逐个回传结果 |
| 不设超时 | 一个慢工具拖垮整个任务 | 每个工具单独超时,并全局限制总耗时 |
十一、工具设计检查清单
☐ 工具名是动词短语,全局唯一,风格一致(例如全部
snake_case)。☐ 描述写明了适用场景、不适用场景和必要的前置条件。
☐ 每个参数都有类型、含义;有范围、枚举或示例的都已写明。
☐ 必填项与默认值已明确。
☐ 返回内容有长度上限,并提供分页或过滤手段。
☐ 错误信息包含“原因 + 下一步建议”。
☐ 写操作支持幂等,高风险操作有人工确认。
☐ 所有参数在程序侧经过校验,没有直接拼接到 SQL、Shell 或路径里。
☐ 为工具准备了评测样本:应该调用、不应该调用、参数边界。
十二、常见问题(FAQ)
Q1:模型总是不调用我的工具,怎么办?先检查描述是否清楚说明了“什么情况该用”;再检查系统提示有没有鼓励使用工具;最后看工具是否与其他工具职责重叠。必要时在评测集里加入“应该调用”的样本,对比修改前后的调用率。
Q2:参数 Schema 写得越详细越好吗?不是。Schema 会占用上下文,而且过于复杂的嵌套结构更容易让模型出错。原则是“够用即可”:扁平优先,能用枚举就不用自由文本,嵌套层级尽量控制在两层以内。
Q3:工具应该返回 JSON 还是自然语言?两者都可以。关键是信息精简且明确。给模型下一步推理使用的内容,简洁的文本摘要往往比一大坨原始 JSON 更有效;需要程序二次处理时再返回结构化数据。
Q4:模型编造了参数值(比如不存在的订单号)怎么办?在工具内部校验业务合法性(订单是否存在、是否属于当前用户),并在错误信息里提示“请先调用 list_orders 获取有效订单号”。这也是把“前置依赖”写进描述的价值所在。
十三、小结与下一步
工具调用的设计,本质上是 给模型写 API 文档 + 给程序写防御性代码。先把描述写清、参数收窄、错误可读,再考虑更复杂的编排。建议的落地顺序是:
对照检查清单审视你现有的每个工具,先改名称和描述;
加上统一的校验、超时、截断和错误转换;
为写操作补幂等键与人工确认;
用一批固定样本评测工具选择与参数正确率。
下一篇我们讨论 Agent 的“记忆”:工具的结果如何被保存、筛选和再利用。
 2026-09-30鱼鱼