
最近一年,“Agent”这个词几乎出现在每一篇 AI 文章里。但很多人写了半天 Agent,其实只是把一个大模型接口包了层壳。这篇文章从最小的模型出发,讲清楚 Agent 到底是什么,以及它的核心运行机制——ReAct 循环。读完之后,你应该能回答三个问题:Agent 和普通聊天有什么本质区别?一个 Agent 的每一步到底在发生什么?怎样用几十行代码搭出一个能跑的最小 Agent,并知道它会在哪里出问题?
一、背景:为什么大家都在谈 Agent
早期使用大模型,基本是“一问一答”:把问题写进提示词,模型返回一段文字。这种方式对写文案、翻译、解释概念很好用,但一遇到下面这些需求就力不从心:
需要最新或私有的信息:模型的训练数据有截止时间,也不可能知道你公司数据库里的内容;
需要真正执行动作:比如查订单、改配置、提交工单,光“说”没有用;
需要多步骤完成:比如“把这周的日志整理成周报”,要先读日志、再分类、再汇总、再排版,一次回答很难又准又全。
于是工程上出现了一种自然的解法:让模型不再只“说话”,而是可以“决定调用什么工具”,拿到工具结果后再继续思考,如此循环,直到任务做完。这个“会循环、会用工具的模型程序”,就是我们今天说的 Agent。
需要先说明一点:Agent 目前没有一个被所有人认可的严格定义。本文采用的是偏工程的理解——模型负责决策,程序负责执行,两者在一个循环里协作。
二、Agent 和普通“聊天机器人”的区别
普通的大模型调用是 一问一答:你给一段提示词,模型返回一段文字,结束。而 Agent 的特点是:
有目标:用户给的是“任务”,而不是“问题”,例如“帮我把这周的日志整理成周报”。
会使用工具:可以调用搜索、数据库、代码执行、HTTP 接口等外部能力。
能多步循环:根据上一步的结果决定下一步做什么,直到任务完成或主动放弃。
有状态:会记住已经做过什么、观察到了什么。
一句话概括:Agent = 大模型(决策) + 工具(行动) + 记忆(状态) + 循环(控制流)。
很多人还会把 Agent 与“工作流(Workflow)”混在一起。两者的关键差别是:谁来决定下一步。
| 形态 | 下一步由谁决定 | 典型例子 | 优势 | 代价 |
|---|---|---|---|---|
| 单次问答 | 没有“下一步” | 翻译、润色、解释概念 | 简单、便宜、稳定 | 无法接触外部世界 |
| 固定工作流 | 程序员提前写死 | “先检索→再总结→再格式化”的流水线 | 可预测、易测试、成本可控 | 遇到意外分支只能失败 |
| Agent | 模型在运行时决定 | 自动排查故障、调研并写报告 | 灵活,能处理开放问题 | 路径不确定,调试和成本控制更难 |
选型时有一条很实用的经验:能用固定工作流解决的,就不要上 Agent。只有当步骤数量和顺序在运行前无法确定时,Agent 才真正物有所值。
三、ReAct:思考与行动交替进行
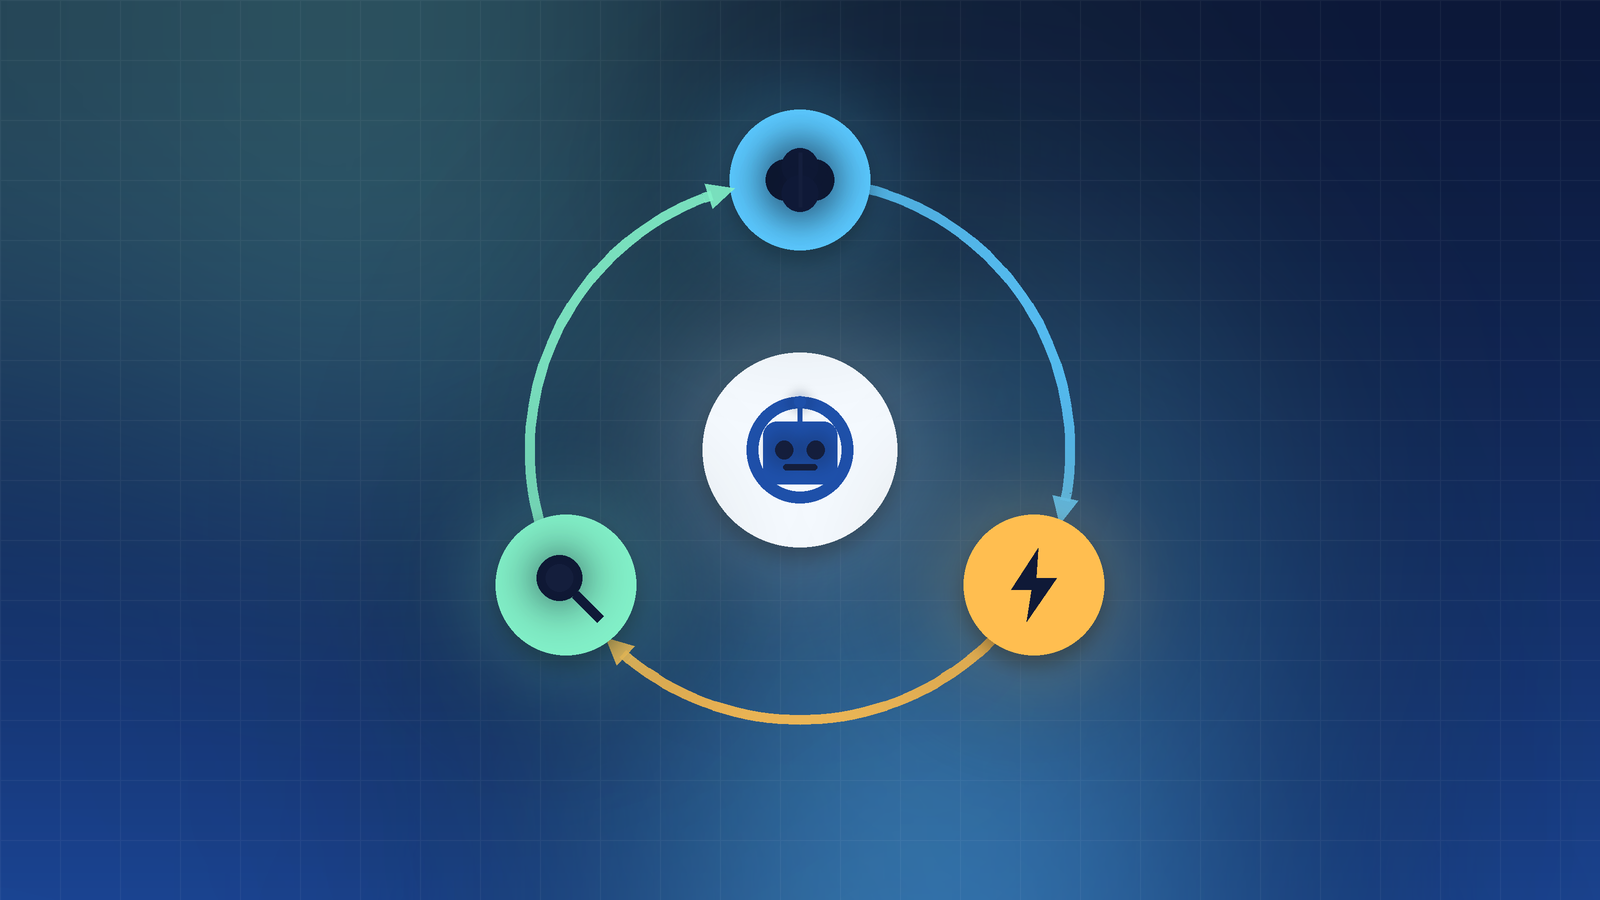
ReAct 来自 2022 年的论文《ReAct: Synergizing Reasoning and Acting in Language Models》,名字是 Reasoning + Acting 的缩写。它的思想很朴素:让模型在每一步先写出 Thought(想法),再给出 Action(动作),环境返回 Observation(观察),然后进入下一轮。
        ┌──────────────────────────────────┐
        │                                  │
        ▼                                  │
  ┌───────────┐   Action    ┌───────────┐  │
  │  Thought  │ ──────────▶ │   Tool    │  │
  │ (模型推理) │             │ (外部世界) │  │
  └───────────┘             └───────────┘  │
        ▲                        │         │
        │      Observation       │         │
        └────────────────────────┘         │
        │                                  │
        └── 信息足够?是 ──▶ Final Answer ──┘
为什么这个模式有效?因为“先想再做”让模型把复杂问题拆成小步,而“做完再看”让每一步都有真实反馈来校正,避免模型在没有依据的情况下一路猜下去。
一个具体的运行轨迹
Thought:用户想知道仓库里有多少个 Java 文件,我需要执行命令统计。
Action:调用
run_shell,参数find . -name "*.java" | wc -l。Observation:
128。Thought:已经拿到结果,可以回答。
Final Answer:仓库里共有 128 个 Java 文件。
换一个稍复杂的场景:排查接口变慢
假设用户说:“订单查询接口今天下午变慢了,帮我看看可能的原因。”一个设计合理的 Agent 大概会这样走:
Thought:先确认慢在哪段时间,需要查监控。Action:
query_metrics(service="order", metric="p95_latency", range="today")。Observation:14:00 之后延迟明显上升。Thought:时间点明确了,看这个时间点附近是否有发布。Action:
list_deployments(service="order", since="13:00")。Observation:13:50 有一次发布。Thought:怀疑发布引入了慢查询,去看该版本的变更。Action:
get_commit_diff(...)。Observation:新增了一个没有索引字段的查询。Thought:证据链已经比较完整,可以给出结论和建议,并注明这是推断而不是已验证的事实。Final Answer:……
注意第 4 步里“注明这是推断”。好的 Agent 提示词会要求模型区分“观察到的事实”和“自己的推断”,这会显著降低误导用户的风险。
四、用 Python 写一个能跑的最小 Agent
下面的代码分成三部分:工具定义、模型调用接口、Agent 循环。为了让你不接任何模型也能把流程跑通,我写了一个“脚本化的假模型” ScriptedLLM,它按预设顺序返回工具调用和最终答案。等你理解了控制流,再把它替换成真实的模型 SDK 即可。
import json
from dataclasses import dataclass, field
from typing import Any, Callable

# ---------- 1. 工具:普通的 Python 函数 + 一份“说明书” ----------
@dataclass
class Tool:
    name: str
    description: str          # 写给模型看的:什么时候该用这个工具
    func: Callable[..., Any]

def add(a: int, b: int) -> int:
    return a + b

def read_file(path: str) -> str:
    # 示例:真实场景里要限制可读目录,见后文“安全”相关文章
    with open(path, encoding="utf-8") as f:
        return f.read()[:2000]        # 限制返回长度,防止撑爆上下文

TOOLS = {
    t.name: t for t in [
        Tool("add", "计算两个整数之和,参数 a、b 为整数", add),
        Tool("read_file", "读取本地文本文件前 2000 个字符,参数 path 为文件路径", read_file),
    ]
}

# ---------- 2. 模型接口:输入消息列表,输出“调用工具”或“最终答案” ----------
@dataclass
class Reply:
    kind: str                       # "tool_call" 或 "final"
    content: str = ""               # final 时的文本
    name: str = ""                  # tool_call 时的工具名
    arguments: dict = field(default_factory=dict)

class ScriptedLLM:
    """演示用:按预设脚本返回。替换成真实模型时,保持 chat() 的签名不变即可。"""
    def __init__(self, script):
        self.script, self.i = script, 0

    def chat(self, messages) -> Reply:
        reply = self.script[self.i]
        self.i += 1
        return reply

# ---------- 3. Agent 循环 ----------
def run_agent(llm, task: str, max_steps: int = 8) -> str:
    messages = [
        {"role": "system", "content": "你是一个会使用工具的助手,信息不足时先调用工具。"},
        {"role": "user", "content": task},
    ]
    for step in range(1, max_steps + 1):
        reply = llm.chat(messages)
        if reply.kind == "final":
            print(f"[step {step}] 最终答案")
            return reply.content

        print(f"[step {step}] 调用工具 {reply.name}({reply.arguments})")
        tool = TOOLS.get(reply.name)
        try:
            if tool is None:
                raise KeyError(f"未知工具 {reply.name},可用:{list(TOOLS)}")
            result = tool.func(**reply.arguments)
        except Exception as e:           # 工具失败也要回传给模型,让它有机会自我纠正
            result = f"工具执行出错: {type(e).__name__}: {e}"

        messages.append({"role": "assistant",
                         "content": json.dumps({"tool": reply.name, "args": reply.arguments},
                                               ensure_ascii=False)})
        messages.append({"role": "tool", "name": reply.name,
                         "content": json.dumps(result, ensure_ascii=False)})
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    llm = ScriptedLLM([
        Reply("tool_call", name="add", arguments={"a": 17, "b": 25}),
        Reply("final", content="17 加 25 等于 42。"),
    ])
    print(run_agent(llm, "帮我算一下 17 加 25"))
运行后输出大致是:
[step 1] 调用工具 add({'a': 17, 'b': 25})
[step 2] 最终答案
17 加 25 等于 42。
逐步拆解:一次循环里消息列表是怎么变化的
理解 Agent 最直观的办法,是盯着 messages 看它每一轮多了什么。以“17 加 25”为例:
第 0 轮(初始):列表里只有两条——系统提示和用户任务。
第 1 轮,模型决定调工具:程序执行
add(17, 25)得到42,然后追加两条消息:一条记录“模型想调用 add”,一条记录“工具返回 42”。第 2 轮,模型看到完整历史:它发现结果已经有了,于是输出最终答案,循环结束。
可以看到,模型本身并不“记得”上一轮发生了什么,它只是每次都重新阅读整个列表。这也是为什么后续文章要专门讨论“记忆”与“上下文工程”:列表越长,成本越高,关键信息越容易被淹没。
代码里值得注意的细节
max_steps必须有,否则模型陷入死循环时会一直烧钱。工具报错要作为 Observation 回传,让模型有机会自我纠正,而不是直接抛异常中断。
未知工具名也要容错:模型偶尔会“幻想”出一个不存在的工具,把可用列表告诉它,它通常能改正。
每一轮都把完整历史发给模型,所以上下文会不断增长——这就引出了后面的“记忆”和“上下文工程”话题。
不同模型 SDK 对“工具调用消息”的字段格式并不一样(有的用专门的
tool_calls字段,有的用特定角色),接入真实模型时,以所用 SDK 的文档为准,上面的messages结构只是示意。
五、从“能跑”到“能用”:换成真实模型要补什么
最小示例离生产还有一段距离。把 ScriptedLLM 换成真实模型时,建议依次补上这些能力:
工具的结构化说明:用 JSON Schema 描述参数,让模型知道每个字段的类型和含义(下一篇详细讲)。
参数校验:模型给的参数永远不可信,执行前先校验。
超时与重试:模型接口和工具都可能超时,要有限次重试,而不是无限重试。
日志与 Trace:每一步记录 Thought / Action / Observation,这是调试最有价值的资料。
人工确认:对删除、转账、发邮件等不可逆操作加确认环节。
上下文控制:历史过长时做摘要或裁剪。
六、Agent 的几个关键组成部分,各自解决什么问题
前面反复提到“模型 + 工具 + 记忆 + 循环”,这里把它们拆开看一下,方便你在自己的项目里对号入座:
模型(决策者):负责理解任务、选择下一步。它的能力上限决定了 Agent 能处理多复杂的任务,但它并不直接“做事”。
工具(手和眼):把模型的决定落地为真实动作,也把外部世界的信息带回来。工具越清晰、越可靠,Agent 越稳。
记忆(笔记本):短期记忆是当前上下文,长期记忆是外部存储。没有记忆,Agent 每一步都像第一次见到这个任务。
循环(控制流):决定何时继续、何时停止、何时求助人类。这部分是普通程序代码,最好写得保守、可预测。
一个有价值的工程直觉是:把“需要灵活判断”的部分交给模型,把“必须可靠”的部分交给代码。例如“是否调用删除工具”可以由模型建议,但“是否真的允许删除”必须由代码里的权限检查和人工确认来决定。
七、ReAct 的优点与局限
| 维度 | 优点 | 局限 |
|---|---|---|
| 可解释性 | Thought 让决策过程可读、可调试 | Thought 不一定反映模型真实的内部推理 |
| 灵活性 | 无需预先写死流程,遇到意外可调整 | 路径不可控,同一任务每次走法可能不同 |
| 成本 | 简单任务步数少,开销小 | 复杂任务步数多,token 和延迟累积明显 |
| 可靠性 | 有 Observation 反馈可纠错 | 容易重复调用同一工具、陷入循环 |
再补充一个取舍:ReAct 是“走一步看一步”,对需要全局安排的长任务,往往要配合显式规划(后面的文章会讲)。
八、常见坑与排查思路
| 现象 | 常见原因 | 解决办法 |
|---|---|---|
| 反复调用同一个工具、参数一样 | 工具返回信息太少或含糊,模型不知道已经完成 | 返回更明确的结果;在循环里检测“重复调用”并提示模型换思路 |
| 总是选错工具 | 工具名和描述相似或太笼统 | 改为动词短语命名,在描述里写清“何时用、何时不用” |
| 参数总是填错 | Schema 缺少类型、范围和示例 | 补充枚举、范围、示例;错误信息回传具体原因 |
| 跑很久不结束 | 没有步数或时间上限 | 同时设置最大步数、最大耗时、最大 token |
| 上下文越来越长,后面变“笨” | 历史和工具输出原样堆积 | 裁剪工具输出、对旧历史做摘要 |
| 结论看似合理但没有依据 | 模型在信息不足时直接“编” | 提示词要求“没有证据就说不确定”,并要求引用观察结果 |
九、给初学者的实践清单
☐ 先从 单 Agent + 2~3 个工具 做起,不要一上来就搞多智能体。
☐ 工具的 名字和描述要写得像给新同事写文档一样清楚,这直接影响模型选择是否正确。
☐ 记录每一步的 Thought / Action / Observation 日志,这是后续调试最有价值的资料。
☐ 对不可逆操作(删除、转账、发邮件)加入人工确认。
☐ 准备 10~20 条固定的测试任务,每次改提示词或工具后都跑一遍。
☐ 所有循环都要有“出口”:最大步数、超时、费用上限。
十、常见问题(FAQ)
Q1:Agent 一定要用很强的模型吗?不一定,但决策质量直接取决于模型的推理与指令遵循能力。工具少、流程简单时,较小的模型也可能胜任;工具多、任务开放时,通常需要更强的模型。建议用自己的评测任务实际比较,而不是凭印象选择。
Q2:ReAct 里的 Thought 一定要输出给用户看吗?不需要。Thought 主要用于模型自己“想清楚”和开发者调试。面向用户时,可以只展示进度和最终结果,而把完整过程记录在日志里。
Q3:用了 Function Calling,还算 ReAct 吗?可以这样理解:Function Calling 是一种让模型以结构化形式表达“我要调用什么工具”的接口能力,而 ReAct 描述的是“思考—行动—观察”的循环范式。现在多数 Agent 用 Function Calling 来实现这个循环。
Q4:Agent 会不会比普通调用贵很多?通常会更贵,因为一次任务包含多轮模型调用,而且每轮都带着不断增长的历史。所以要设置预算上限,并在能用固定工作流的地方不用 Agent。
十一、小结与下一步
回顾一下:Agent 不是“更聪明的模型”,而是 模型 + 工具 + 记忆 + 循环 组成的系统;ReAct 用“思考—行动—观察”的循环把这四者串了起来;最小实现只需要几十行代码,但要走向可用,必须补上校验、容错、日志和安全控制。
下一步建议你:
把上面的
ScriptedLLM换成你手头的模型 SDK,自己跑通一个“算数 + 读文件”的小任务;故意让工具抛错、让模型选错工具,观察 Agent 如何恢复;
继续阅读下一篇 工具调用(Function Calling)的设计原则,这是让 Agent 真正“动手”的关键。
 2026-09-30鱼鱼