

过去两年,我们团队把 AI 编程工具真正用进了日常研发:补全式的 Copilot、IDE 里的对话助手,以及能自己读写文件、跑命令的 Agent。收益是实打实的,样板代码、单元测试、脚本、联调、陌生框架的第一版实现,速度都明显提升。但用得越深,我越确信一件事:AI 工程化迭代最危险的地方,不是它“不会写代码”,而是它太会写了。在缺少稳定工程约束的时候,它会持续、高速地产出“单独看都挺合理,放在一起却彼此矛盾”的局部方案。
这些矛盾的方案不会立刻表现为一个 Bug。它们表现为一种缓慢累积的混乱:同一个纠正反复被推翻,数据库越改越别扭,代码里一个概念长出两三个名字,线上出事时拼不出一条完整的因果链。我把自己和团队最常撞上的四类问题归纳如下:
思维惯性:在对话里明明纠正过、甚至在另一个会话里也修过的错误,过几轮又被模型“请”了回来;
数据库糟糕设计:超长的键、滥用
LONGTEXT、用应用代码而不是数据库约束来保证唯一性、表设计得过多、过少或过宽,以及缺少日志表、审计表和关联表;细节上的过度设计:同一个业务字段既有
a_b又有aB,而其中只有一个是真实字段,另一个只是“以防万一”;日志追溯困难:调用链又长又危险,出事时却串不起一条可查的线索。
这篇文章换了一种写法。上一版我主要从“模型为什么会这样”的角度吐槽和拆解,这一版我想借用更专业的工程术语,把四类问题放进同一个治理框架:每一类问题都给出专业定性、形成机制、典型后果、控制方法,最后落到四个可以直接在团队里执行的工程控制面,并附上模板和代码。文中凡是涉及具体模型行为的判断,都是我的工程经验加上对公开原理的推断,不同模型、不同版本差异很大,请当作“经验假设”,而不是定论。
一、总判断:AI 迭代的核心风险是“局部合理,整体失序”
先把结论放在前面。深度依赖 AI 做工程迭代时,系统会逐步出现四种“病灶”,它们互相放大:
规格熵(Specification Entropy):需求、流程、状态、命名、约束这些“规格”本应是系统里最稳定的部分,但没有被显式记录,于是每一轮迭代都在悄悄改写它。规格的不确定性越积越多,就像孤立系统里的熵,只增不减。
语义分叉(Semantic Divergence):同一个业务概念,在数据库里是一个样子,在接口里是另一个样子,前端又有第三种理解。各层都“自洽”,但互相对不上。
偶然复杂度(Accidental Complexity):与业务本身无关、纯粹由实现方式带来的复杂度,比如多余的别名字段、层层复制的对象、没人敢删的兼容分支。业务本身的复杂度(本质复杂度)降不下来,但偶然复杂度本来是可以不产生的。
诊断债务(Diagnostic Debt):像技术债一样,欠下的是“将来排障的能力”。今天少打的每一条关键日志、少传的每一个 ID,都会在某次凌晨的故障里连本带利地收回。
理解这四个词,可以得到一个很重要的推论:问题不在“AI 写的某一行代码错了”,而在于缺少一套能持续收敛问题边界的工程体系。因此对策也不是简单地“限制 AI”,而是把它放进一个有外部权威规格、有变更纪律、有复杂度预算、有可观测性的框架里。后面我会把这个框架拆成四个控制面(规格、变更、复杂度、观测),先看问题本身。
为什么 AI 容易把局部合理累加成整体失序
在分别展开之前,我想先交代一个贯穿全文的底层事实,免得后面每一节重复解释。
第一,目标错位。 大语言模型的基础训练目标是预测下一个 token,之后还会经过指令微调和偏好优化。这些阶段优化的是“在当前上下文里给出看起来正确、让人满意的回答”。而生产系统真正需要的是:十八个月后仍然容易修改,真实流量下仍然稳定,出了问题能被定位。前者是局部、即时、一眼可判断的;后者是全局、长期、必须在运行中才能验证的。两者冲突时(比如多写一个兜底分支能让 demo 跑通,却让维护成本翻倍),模型没有理由选后者,因为后者的代价不出现在它眼前的上下文里。
第二,局部视野。 模型的世界就是上下文窗口:你贴进来的文件、它检索到的片段、之前的对话。生产库里有多少行数据、哪些接口是热点、哪个字段前端其实从不读取、下游有哪些服务依赖这张表,这些决定设计好坏的信息通常不在窗口里。
第三,缺少反馈回路。 人类工程师是被线上事故教育出来的:慢查询拖垮过一次库,就再也不敢随手写 LONGTEXT;半夜排障找不到日志痛苦过一次,就会在每个边界打点。模型在单次会话里的反馈基本只来自编译器和测试,而编译器和测试恰恰不检查“表结构合不合理”“日志能不能串起来”。
第四,分布偏移。 公开教程、示例和小型开源项目在训练语料里占比很高,它们规模小、场景单一、目的是讲清一个概念。企业系统却是在数据量、并发、合规和历史包袱共同作用下长出来的。让模型“照着典型写”,得到的往往是教程级别的设计。
这四点合起来,就是一句话:AI 的默认行为是扩大局部解空间。你给它一个小问题,它会尽可能多地考虑“还有哪些写法、还要兼容什么”,而工程的任务恰好相反,是不断收敛全局的问题空间。后文所有现象,都可以看成这句话的不同侧面。
二、问题一:思维惯性——外部权威规格缺失时,纠正会“漂移”
现象
这是最让人抓狂的一类,场景通常是这样的:
第 3 轮,我指出“这个项目的时间字段统一用
LocalDateTime,别再用Date”,模型道歉并改好了;第 12 轮,让它加一个新功能,新代码里又出现了
new Date();换一个新会话,我们曾经修过的“不要在循环里查库”,它又写出了同样的 N+1;
人类手工修掉了某个 Bug,让 Agent 接着做后续任务,它读到旧的上下文摘要,把 Bug“修复回去”了。
我一开始把这叫作“思维惯性”。后来读到一套更精确的说法,才发现它根本不只是“模型记性差”这么简单。
专业定性
从工程治理的角度看,这类问题可以归入下面四个术语:
| 术语 | 含义 | 在“惯性”问题里的表现 |
|---|---|---|
| Specification Gap(规格缺口) | 该被明确写下的要求没有写下,或者只存在于某次对话里 | “时间统一用 LocalDateTime”只在第 3 轮的聊天里出现过,没有任何项目级文档承载它 |
| Boundary Ambiguity(边界歧义) | 不清楚某个约定适用的范围 | 这条约定是只对当前文件有效,还是整个仓库?对新写的代码和老代码是否一视同仁? |
| State-Machine Omission(状态机缺失) | 流程里的状态、前置条件、终态没有被定义 | 让 AI 做“退款”功能,没人定义“已支付→退款中→已退款/退款失败”,AI 只好自己编,下一轮编出另一套 |
| Invariant Drift(不变量漂移) | 本应始终成立的业务/工程约束,随迭代被悄悄打破 | “所有时间用 LocalDateTime”“循环内不查库”本是不变量,却因没有外部权威来源而逐轮漂移 |
这里的关键词是“外部权威规格”。人类团队里,约定存在于文档、代码规范、评审记录和老员工的脑子里;AI 的“脑子”只有当前上下文。如果规格不在上下文里,那它就等同于不存在。所以我把“惯性”看作规格缺口的一个典型症状:不是模型固执,而是没有任何机制保证那条纠正在下一次生成时依然在场。
形成机制
下面这几条机制会叠加起作用,它们解释了为什么“明明改过又回来”。
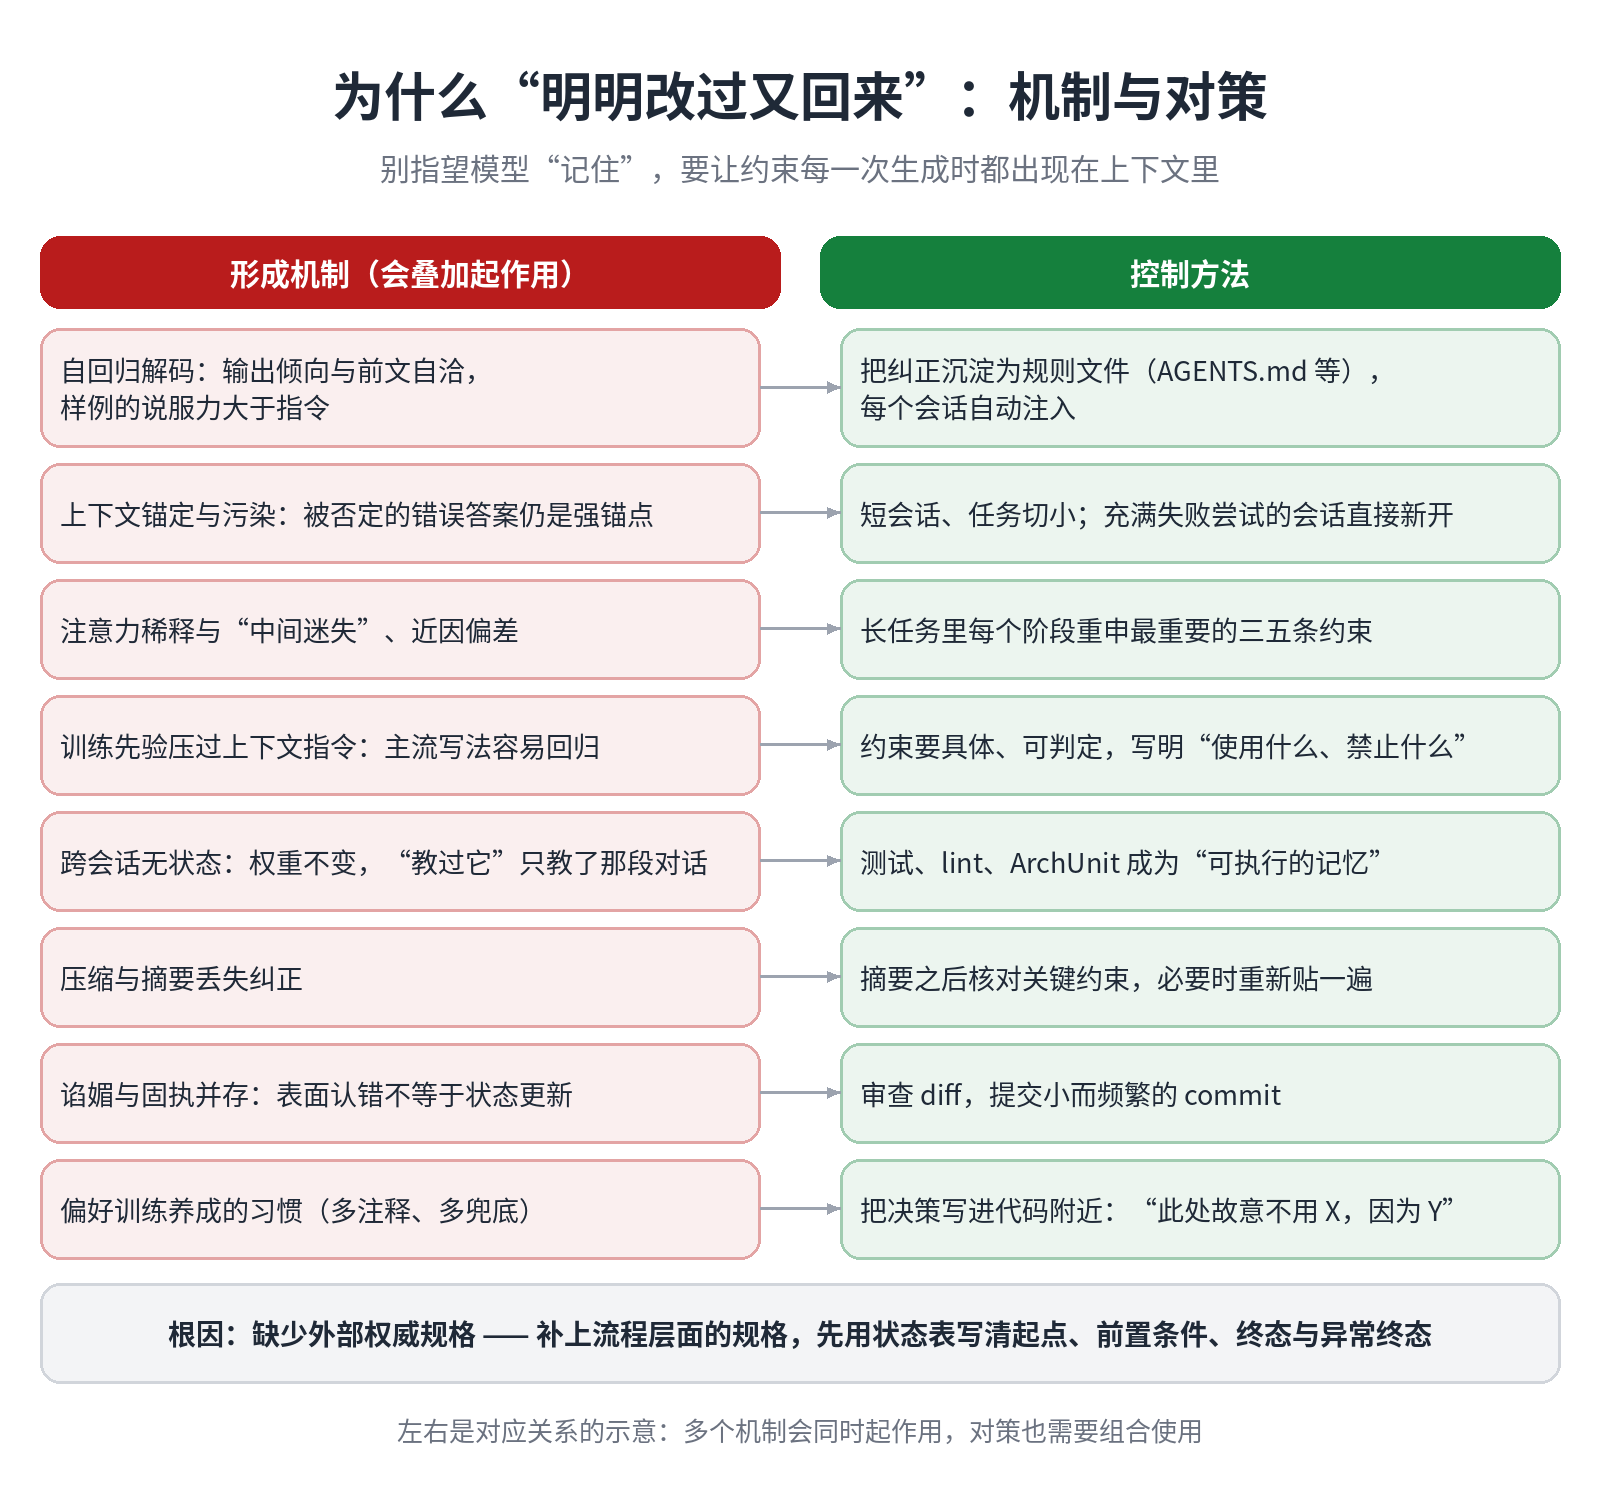
1. 自回归解码与上下文自洽。 Transformer 类语言模型是自回归的,每生成一个 token 都以此前全部上下文为条件。输出天然倾向于和前文保持一致。上下文里已经有大量“错误写法”的痕迹(它先前生成的代码、你贴进来的旧代码、报错日志里的旧调用),模型就会把它们当成“这个项目的风格与事实”来延续。一句“不要用 Date”只是一小段文字,而十几处 Date 是大量结构化的“样例”。样例的说服力通常大于指令。
2. 上下文锚定与上下文污染。 对话里出现过的错误答案,即使后来被否定,依然留在上下文里,成为强锚点。更微妙的是,被纠正的错误在上下文中至少出现两次:一次是错误本身,一次是你纠正语句里对它的复述。模型并不会像人那样把它标记为“作废”,注意力只是看到“这个序列和当前任务很相关”。
3. 注意力稀释与“中间迷失”(lost-in-the-middle)。 上下文越长,注意力要在越多 token 间分配,每条信息分到的份额就越小。同时,研究者在不少模型上观察到:位于上下文开头和结尾的信息更容易被利用,位于中间的更容易被忽略。你在第 3 轮给出的纠正,几轮之后正好落到“中间”,又被大量后续内容淹没。需要强调的是,这种效应的强弱取决于具体模型和上下文长度,新一代模型在长上下文上改进明显,但不宜假设它已被彻底解决。
4. 近因偏差。 许多模型对靠近生成位置的内容更敏感。如果最近几轮里你或工具输出贴进了旧写法(比如 git diff 里的旧版本、报错堆栈),它们的近因优势会压过很早之前的一句口头纠正。
5. 训练先验与上下文指令的冲突。 模型参数里编码了大量“网上最常见”的写法,Java 里日期就这样写、分页就那样写。你的指令只是上下文内的临时信息,两者冲突时谁占优,取决于指令是否显著、模型指令遵循能力强不强、先验有多强。越是主流写法,越容易在你不注意时回归,这也是“违背主流习惯”的项目约定特别容易被反复破坏的原因。
6. 谄媚与固执并存。 偏好训练容易带来谄媚:你一指出错误,模型立刻说“您说得对,非常抱歉”,并给出修改。但表面认错不等于内部状态更新,它只是生成了符合“被纠正时应有反应”的文本。另一些时候它又会固执:用一大段解释证明“其实我原来的写法也没问题”。两者看似矛盾,其实是同一机制的两面:都在追求“看起来合理的下一段文本”,而不是维护一个可验证的事实状态。
7. 跨会话无状态(statelessness)。 推理时模型权重不会改变。你在会话 A 里的所有纠正,对会话 B 完全不存在,除非有机制把它们再次写入上下文(规则文件、记忆功能、检索)。所谓“记忆功能”,本质上也是把文本注入上下文,并不是模型学会了。很多人以为“我教过它了”,实际上只教了那一段对话。
8. 压缩与摘要丢失纠正。 长任务里,Agent 工具通常在上下文快满时把历史压缩成摘要。摘要由模型生成,倾向于保留“做了什么、结论是什么”,却容易丢掉“你曾经纠正过什么、为什么”这样的细节性约束,甚至可能把“曾经出现过的错误方案”记成“已完成的工作”。压缩一次,纠正就被有损压缩掉一次。
9. 偏好训练养成的习惯。 喜欢加注释、喜欢加异常处理、喜欢给“更完整”的实现,这些是分布层面的偏好,不是某段对话能轻易压制的。所以“别写多余的注释”“别加兜底”这类指令需要反复重申才能维持。
把这些放在一张图里:
会话早期                            会话后期
┌────────────────────┐             ┌──────────────────────────────┐
│ 用户: 别用 Date     │             │ ...大量新代码、日志、diff...   │
│ 模型: 好的,改用     │  ──────▶    │ 其中含有旧写法 Date (近因强)   │
│ LocalDateTime      │  注意力稀释  │ 早期纠正被稀释、位于“中间”     │
└────────────────────┘             │ → 新生成代码回归 Date         │
                                   └──────────────────────────────┘
        新会话 = 上下文清零 → 纠正完全不存在(无状态)
                    ▲
                    └── 缺少“外部权威规格”:没有任何地方在每次生成时重新注入这条约束
“改过又回来”的形成机制与对应的控制方法
典型后果
同一个错误在不同的会话、不同的人手里反复出现,团队形成“AI 总在重犯”的集体印象,信任感下降;
流程节点之间缺少明确的前置条件和终态,异常路径没有业务定义,接口、数据库和前端各自形成局部理解;
人工修复被“顺手改回去”,而且往往在评审时不易被发现,因为改回去的代码本身“看起来没毛病”;
之后每一轮迭代都要用兼容逻辑去弥补上一轮的模糊,规格熵于是持续上升。
控制方法
核心思想只有一句:别指望模型“记住”,要让约束在每一次生成时都“出现在上下文里”,并且尽量由机器而不是人来执行。
把纠正沉淀为规则文件。 例如
AGENTS.md、CLAUDE.md、.cursor/rules之类(名称因工具而异)。每次人工纠正过一个重复出现的错误,就往里加一条,把“会话内的纠正”转成“每个会话都自动注入的先验”。短会话,任务切小。 一个会话只做一件事,做完新开。不要在一个已经充满失败尝试的会话里继续修修补补,直接新开,并把正确结论带过去。
关键约束重新注入。 长任务里,在每个阶段的提示里重申最重要的三五条约束,利用近因效应,不要只在开头说一次。
约束要具体、可判定。 不写“注意代码质量”,而写“所有时间字段使用
java.time.LocalDateTime,禁止java.util.Date”。让测试与静态检查成为“可执行的记忆”。 能写成 ArchUnit、Checkstyle、lint、单元测试的约束,就别只写在文档里。模型改坏了 CI 就红,Agent 拿到的是确定性反馈,不依赖谁记不记得。
摘要之后做核对。 Agent 压缩上下文后,检查关键约束是否还在,必要时手动重新贴一遍。
审查 diff,而不是审查“看起来对的结果”。 人类手工改过的地方盯着 diff 看,提交小而频繁的 commit,让人工修改成为不容易被覆盖的基线。
把决策写进代码附近。 在容易被“修正”的地方放一行说明(例如“此处故意不用 X,因为 Y”),既给后来的人看,也给模型提供局部、近距离的上下文。
补上流程层面的规格。 对涉及多个状态的功能,先用状态表把“起点、前置条件、终态、异常终态”写清楚,再让 AI 实现。很多“反复出现的错误”其实是因为连状态机都没有,AI 每次都在重新发明。
一个规则文件的最小示例:
# 项目约定(Agent 必读)
## 硬性约束(不变量)
- 时间类型统一使用 java.time.LocalDateTime / Instant,禁止 java.util.Date。
- 数据库访问只能通过 Mapper,禁止在循环内查询(避免 N+1)。
- 新增表必须有主键、created_at、updated_at;字符串列必须显式给出合理长度。
## 曾经犯过的错(不要复发)
- 不要把同一个 DTO 字段同时写成 snake_case 和 camelCase 两份。
- 不要吞异常:catch 后必须记录日志(带业务ID)或向上抛出。
## 交付前自检
- 运行 ./gradlew check,并列出本次修改中新增的依赖与配置项。
规则文件本身也要克制。它同样占用上下文,写得太长同样会被稀释。我的经验是:硬性约束控制在二三十条以内,每条都能被人或机器判定对错,过时的条目定期清理。
三、问题二:数据库糟糕设计——本质是领域、时间与关系的建模失败
现象
我们见过的 AI 生成建表语句,常见问题大致有这些:
键过长:主键或唯一键用
VARCHAR(255),甚至VARCHAR(512),或者几个长字符串列拼成联合唯一索引;滥用 TEXT / LONGTEXT:状态、类型、姓名、
URL,甚至枚举值都用 LONGTEXT,或者把整段 JSON 塞进一个大字段,再把 ID 列表用逗号拼在一个字段里;唯一性靠应用代码:先
SELECT判断是否存在,再INSERT,却不建唯一索引;或者反过来,用了错误的唯一约束(比如在软删除表上给email加唯一索引,结果删除后无法重新注册);表的数量与宽度失衡:要么把一切塞进一张几十列的大宽表,要么把很小的概念拆成十几张表,查询要 JOIN 一圈;也有“该拆没拆”和“不该拆硬拆”并存的情况;
缺少日志、审计与关联表:多对多关系用逗号字符串表达,状态流转没有流水表,事后无法追溯是谁在什么时候改了什么。
专业定性
数据库设计差,通常不只是“字段类型选错了、索引没建好”。更深一层的问题是:没有先定义领域对象、关系的生命周期和业务不变量,就直接开始建表。借用治理框架里的术语:
| 术语 | 含义 | 对应到我们的现象 |
|---|---|---|
| Domain Modeling Failure(领域建模失败) | 没有先回答“系统里有哪些业务对象、它们之间是什么关系” | 大宽表把订单、用户、收货信息、支付信息混成一张表;或者把“成员”“项目”“成员在项目里的角色”揉在一起 |
| Temporal Modeling Failure(时间维度建模失败) | 只建模“当前状态”,没有建模“状态如何随时间变化” | 订单只有一个 status 字段,没有状态流转表;谁在何时把它改成已取消,无从查证 |
| Relationship Lifecycle Modeling Failure(关系生命周期建模失败) | 把关系当成一个字段的值,而不是一个有生命周期的业务对象 | 用 member_ids = "1,2,3" 表示项目成员,无法表达谁何时加入、担任什么角色、何时被移除 |
| Referential Integrity Loss(参照完整性丢失) | 引用关系没有被数据库层面的约束保护 | 字符串里的 ID 可能指向早已删除的成员,数据库一点也不知道 |
最典型的案例就是“多对多关系硬塞进字符串或 JSON”。
-- ❌ 不推荐的关系存储
CREATE TABLE project (
    id         BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    name       VARCHAR(100) NOT NULL,
    member_ids VARCHAR(2000) NOT NULL DEFAULT '',   -- '1,2,3'
    PRIMARY KEY (id)
);
这样做会失去四样东西:参照完整性(成员被删除后,字符串里的 ID 仍然静静躺着)、独立属性(角色、加入时间没地方放)、高效查询(“某个成员参与了哪些项目”只能 LIKE '%,3,%' 全表扫描,还会误匹配 13、30)、单条关系的审计能力(移除成员只是字符串被改写,历史消失)。
更合理的边界,是把“关系”本身当作一个可追踪的业务对象,用关联表表达:
-- ✅ 关联表:关系是有生命周期的业务对象
CREATE TABLE `project_member` (
    `id`          BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    `project_id`  BIGINT UNSIGNED NOT NULL COMMENT '项目ID',
    `member_id`   BIGINT UNSIGNED NOT NULL COMMENT '成员ID',
    `role`        TINYINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '0成员 1负责人 2观察者',
    `joined_at`   DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '加入时间',
    `removed_at`  DATETIME(3) NULL COMMENT '移除时间,NULL表示仍在项目中',
    `operator_id` BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '操作人',
    PRIMARY KEY (`id`),
    KEY `idx_project_member` (`project_id`, `member_id`, `removed_at`),
    KEY `idx_member` (`member_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='项目成员关系';
这不仅是“符合范式”的问题,更是关系生命周期的问题:谁加入、何时加入、担任何种角色、何时被移除,都应该能被独立表达和审计。注意,这里我特意没有对 (project_id, member_id) 直接建唯一索引,因为同一个人可以“退出后再加入”,会产生两条历史记录。如果业务要求“任一时刻只能有一条有效关系”,就需要另外设计(例如在有效记录上使用生成列辅助唯一约束,或者把有效性编码进唯一键),这又是一个必须由规格先回答的业务不变量,而不是靠 AI 随手决定。这个例子本身就说明了为什么建模要先于建表。
形成机制
1. 训练语料偏向教程与 CRUD 示例。 网上大量建表示例是为了讲解语法:name VARCHAR(255)、content TEXT,简洁通用,没有任何量级假设。模型学到的是“建表长这样”,而不是“建表前先想清楚数据量和访问模式”。
2. 把“能跑”当作局部最优。 LONGTEXT 对模型是“永远不会因长度报错”的安全选择,VARCHAR(255) 是“看起来合理”的默认值。它们不会引发即时错误,所以在“跑通”这个目标下是局部最优,代价(索引膨胀、临时表落盘、页分裂)要等数据增长后才显现。
3. 缺乏工作负载、基数与数据量信息。 好的 schema 取决于:表未来多少行、读多还是写多、热点查询是什么、字段取值基数多大。这些几乎从不出现在提示词里,模型只能按平均情况猜。
4. 看不到生产查询模式。 索引为查询而设计。没有慢查询日志、没有 EXPLAIN、没有真实 SQL 分布,模型不知道该建 (user_id, status, created_at) 还是别的。它常做的是“每个查询条件各建一个索引”,或者干脆不建。
5. 没有被要求先建模。 这一点最关键。我们很少在提示词里写“先给出实体关系和状态机,再给 DDL”,AI 便直接从“请帮我设计订单表”跳到了 CREATE TABLE,领域模型、时间维度和关系生命周期这些环节被整体跳过。
关键技术点
索引键长度与 InnoDB 页结构。 InnoDB 以 B+Tree 组织数据,默认页大小是 16KB。索引键越长,单页能放的条目越少,树越高越“胖”,缓存命中率越低。索引键长度也有上限:DYNAMIC 行格式(MySQL 5.7 起的默认)下,单个索引键最多 3072 字节;较老的 COMPACT/REDUNDANT 格式下只有 767 字节(具体以你的版本与配置为准)。utf8mb4 每字符最多 4 字节,所以 VARCHAR(255) 作为索引列最坏需要 1020 字节,几列联合起来很容易逼近上限,也带来不必要的浪费。
聚簇索引与二级索引。 InnoDB 的主键就是聚簇索引,所有二级索引的叶子节点都会存一份主键值。如果主键是 VARCHAR(64) 的字符串(尤其是随机 UUID),每个二级索引都会因此变大;随机的主键插入位置还会引起页分裂和碎片。自增 BIGINT 或有序的分布式 ID 通常更稳妥。
行大小与 TEXT/BLOB。 MySQL 对一行(不含 BLOB/TEXT 溢出部分)有 65535 字节的总限制,InnoDB 还要求行在页内的部分大约不超过半页。TEXT/BLOB 在 DYNAMIC 行格式下通常只在行内保留指针,内容放在溢出页,读取可能带来额外随机 I/O;它们不能被完整索引(需要前缀长度);含 TEXT/BLOB 的排序、分组更容易落到磁盘临时表;SELECT * 遇到大字段代价更高。大字段不是不能用,而是应该与热点数据分表存放,并且确认它确实需要。
唯一性与并发:竞态 vs 唯一约束。 “先查后插”在并发下必然出现竞态:两个请求同时查到“不存在”,然后都插入成功。应用层加锁(synchronized、本地锁)在多实例部署下同样无效,分布式锁又引入新的复杂度。能用数据库唯一索引保证的,就用唯一索引保证;应用层只负责捕获冲突(duplicate key)并转成业务语义。 这也是“业务不变量必须由系统边界之下最底层、最不可绕过的机制来守护”的一个例子。
软删除的陷阱。 用 is_deleted 标记软删除后,唯一索引会与“已删除的历史数据”冲突。常见做法是把删除标记纳入唯一键,例如 (email, deleted_at),未删除记录的 deleted_at 用固定默认值(MySQL 唯一索引允许出现多个 NULL,所以不能用 NULL 表示“未删除”)。软删除还会让所有查询都得带 is_deleted = 0,稍有遗漏就是数据泄漏;何时清理历史数据也要提前设计。
范式与反范式的取舍。 范式化减少冗余、保证一致,反范式用冗余换查询性能。合理的做法是默认从第三范式起步,只在有明确查询性能证据时才有目的地冗余。AI 的两种极端(大宽表或过度拆分)都是缺少“证据”这个输入。
迁移成本。 表结构一旦上线,修改代价随数据量快速上升:大表加索引、改列类型、拆表都需要在线变更工具、灰度与回滚方案,还要协调所有读写方。这是“schema 是最贵的决策之一”的原因,也是我们坚持 schema 必须由人评审的理由。
订单表:AI 第一版与评审后的逐项对照
一个完整对照:订单表(MySQL 8.x)
先看典型的“AI 第一版”:
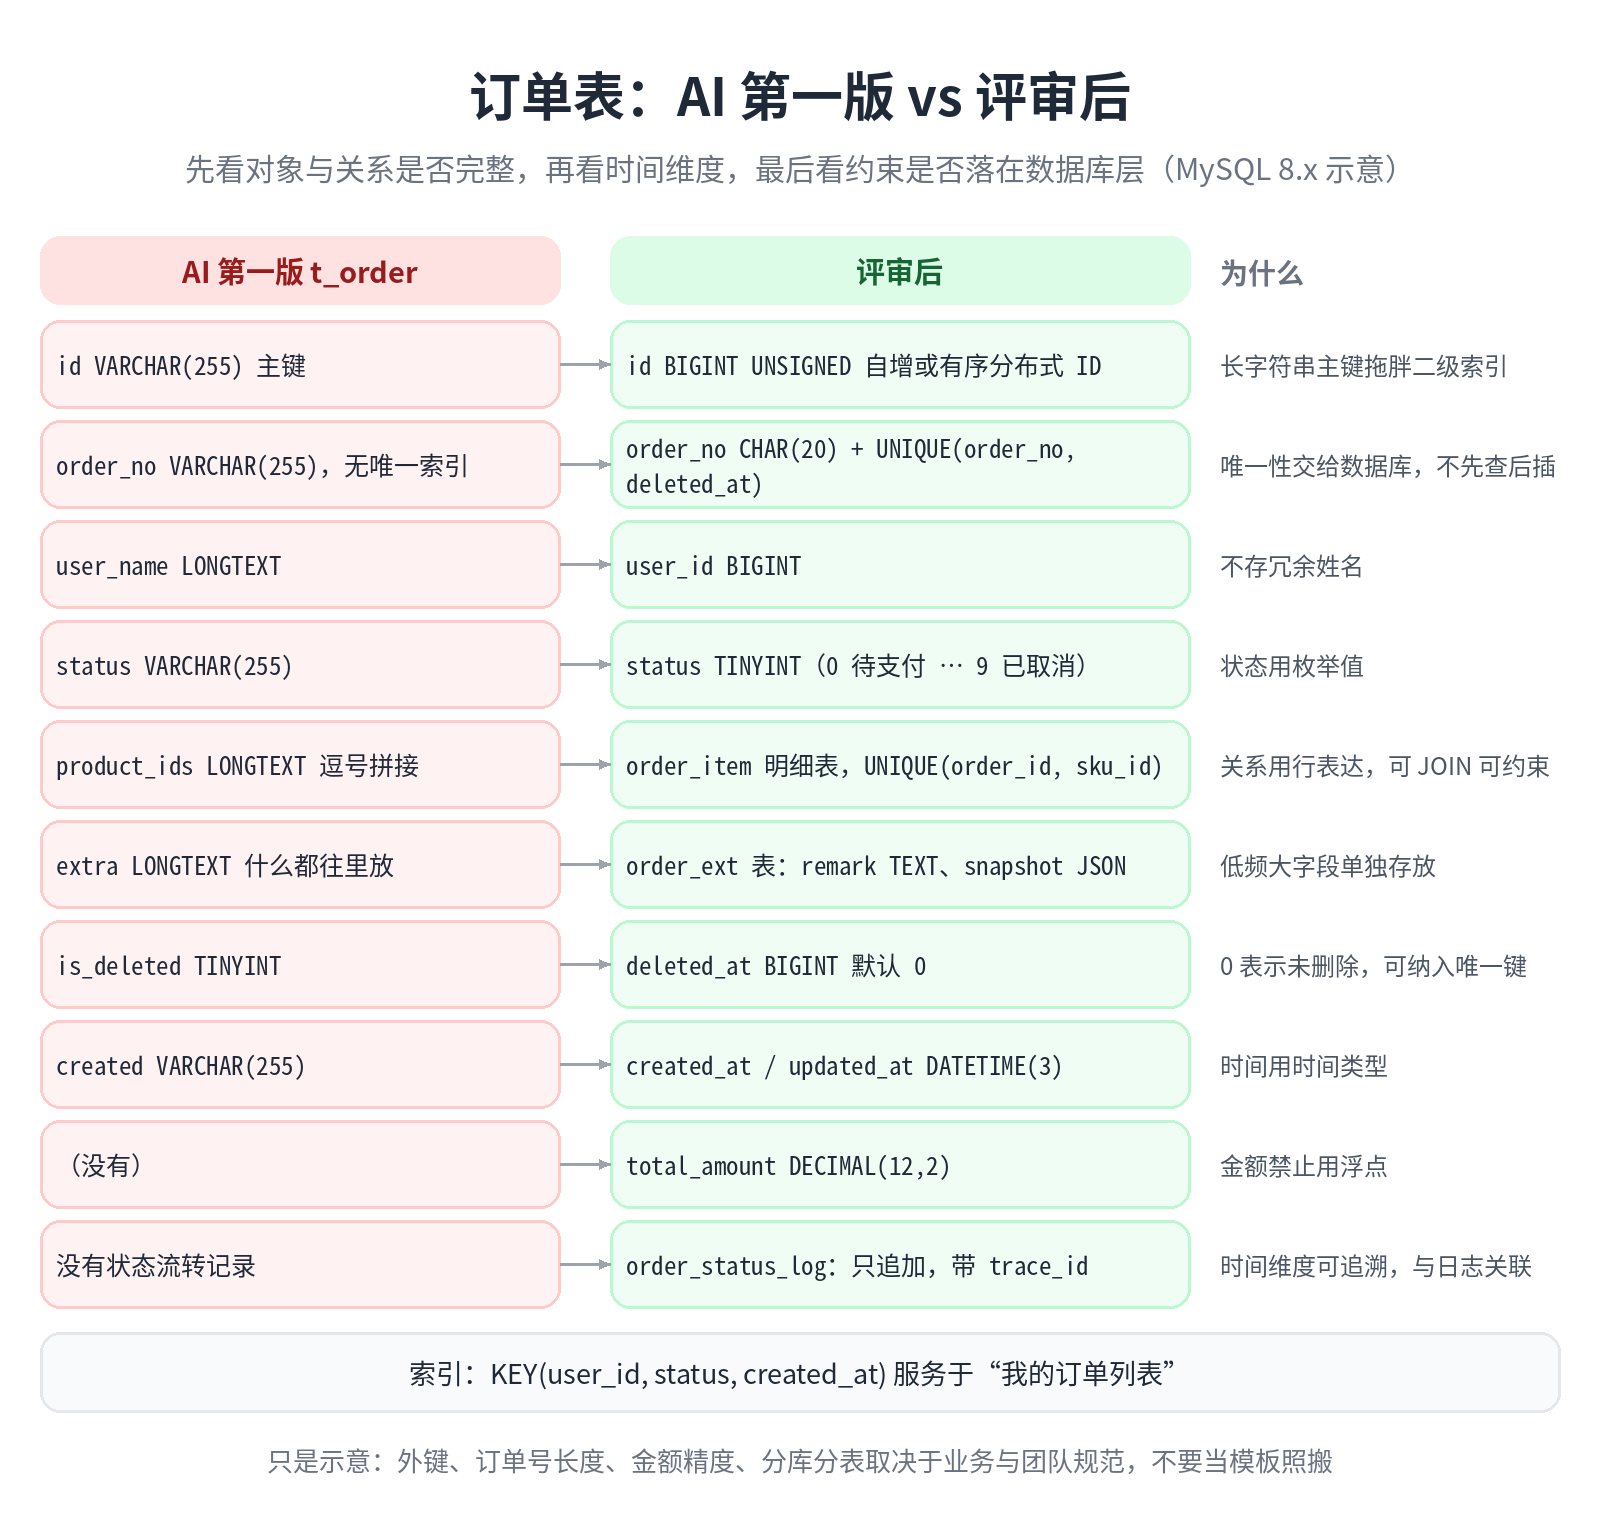
-- ❌ 坏例子:能跑,但每一行都是隐患
CREATE TABLE t_order (
    id            VARCHAR(255) PRIMARY KEY,       -- 长字符串主键,所有二级索引都被拖胖
    order_no      VARCHAR(255),                   -- 没有唯一索引,靠应用先查后插
    user_name     LONGTEXT,                       -- 姓名用 LONGTEXT
    status        VARCHAR(255),                   -- 状态用长字符串
    product_ids   LONGTEXT,                       -- '1001,1002,1003' 逗号拼接,无法 JOIN 与约束
    extra         LONGTEXT,                       -- 整个 JSON 塞进来,什么都往里放
    is_deleted    TINYINT DEFAULT 0,
    created       VARCHAR(255)                    -- 时间用字符串
);
-- 没有状态流转记录,没有关联的明细表
再看评审之后期望的形态:
-- ✅ 订单主表:窄、稳、热数据
CREATE TABLE `order_main` (
    `id`           BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '主键,自增或有序分布式ID',
    `order_no`     CHAR(20)        NOT NULL COMMENT '业务单号,定长',
    `user_id`      BIGINT UNSIGNED NOT NULL COMMENT '用户ID,不存冗余姓名',
    `status`       TINYINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '0待支付 1已支付 2已发货 3已完成 9已取消',
    `total_amount` DECIMAL(12,2)   NOT NULL COMMENT '金额,禁止用浮点',
    `deleted_at`   BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '软删除时间戳,0表示未删除',
    `created_at`   DATETIME(3)     NOT NULL DEFAULT CURRENT_TIMESTAMP(3),
    `updated_at`   DATETIME(3)     NOT NULL DEFAULT CURRENT_TIMESTAMP(3) ON UPDATE CURRENT_TIMESTAMP(3),
    PRIMARY KEY (`id`),
    UNIQUE KEY `uk_order_no` (`order_no`, `deleted_at`),     -- 唯一性交给数据库
    KEY `idx_user_status_created` (`user_id`, `status`, `created_at`)  -- 服务于“我的订单列表”
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单主表';

-- ✅ 关联(明细)表:一对多/多对多用行表达,而不是逗号字符串
CREATE TABLE `order_item` (
    `id`         BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    `order_id`   BIGINT UNSIGNED NOT NULL,
    `sku_id`     BIGINT UNSIGNED NOT NULL,
    `quantity`   INT UNSIGNED    NOT NULL,
    `unit_price` DECIMAL(12,2)   NOT NULL COMMENT '下单时价格快照',
    PRIMARY KEY (`id`),
    UNIQUE KEY `uk_order_sku` (`order_id`, `sku_id`),        -- 同一订单同一商品只有一行
    KEY `idx_sku` (`sku_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单明细';

-- ✅ 状态流转/审计表:只追加,不修改
CREATE TABLE `order_status_log` (
    `id`          BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    `order_id`    BIGINT UNSIGNED NOT NULL,
    `from_status` TINYINT UNSIGNED NOT NULL,
    `to_status`   TINYINT UNSIGNED NOT NULL,
    `operator_id` BIGINT UNSIGNED NOT NULL COMMENT '操作人,系统操作用0',
    `trace_id`    CHAR(32)        NOT NULL DEFAULT '' COMMENT '与日志系统关联',
    `reason`      VARCHAR(255)    NOT NULL DEFAULT '',
    `created_at`  DATETIME(3)     NOT NULL DEFAULT CURRENT_TIMESTAMP(3),
    PRIMARY KEY (`id`),
    KEY `idx_order_created` (`order_id`, `created_at`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单状态流转日志';

-- ✅ 低频大字段单独存放,避免拖累主表
CREATE TABLE `order_ext` (
    `order_id` BIGINT UNSIGNED NOT NULL,
    `remark`   TEXT NULL,
    `snapshot` JSON NULL COMMENT '收货信息快照等低频读取的数据',
    PRIMARY KEY (`order_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单扩展';
应用层配合唯一索引,只需要把冲突转成业务语义:
try {
    orderMapper.insert(order);
} catch (DuplicateKeyException e) {
    // 唯一约束是并发下的最终裁判;这里只做幂等处理,不再“先查后插”
    log.warn("duplicate order, orderNo={}", order.getOrderNo());
    return orderMapper.selectByOrderNo(order.getOrderNo());
}
需要说明:以上只是示意。是否使用外键、订单号长度、金额精度、分库分表策略,都取决于业务与团队规范,不要当模板照搬。我想强调的是评审的角度:先看对象与关系是否完整(主表、明细表、扩展表、状态流水),再看时间维度是否可追溯(created_at、status_log),最后看约束是否落在数据库层(唯一索引、类型、长度)。
典型后果
数据库里出现“孤儿数据”和不可解释的状态,因为没有参照完整性兜底;
查询越来越慢,且慢的原因藏在索引膨胀、回表和临时表里,改起来要动线上大表;
关系变化无法审计,客户问“这个人什么时候被移出了项目”时只能耸肩;
每次业务扩展都要在已有设计上打补丁,用更多字段和兼容逻辑去弥补最初的建模缺失。
控制方法:数据库设计评审清单
☐ 每张表都有主键;主键短、有序、不含业务含义(或有充分理由)
☐ 每个索引列的长度合理,联合索引的顺序与真实查询匹配,没有“每列一个索引”
☐ 没有为了“省事”而使用 TEXT/LONGTEXT;大字段是否已拆到扩展表
☐ 状态、类型等枚举使用小整型或短定长字段,含义写在注释或字典里
☐ 业务唯一性由唯一索引保证;应用层处理 duplicate key,而不是先查后插
☐ 软删除与唯一索引的关系已经想清楚
☐ 一对多、多对多使用明细/关联表,没有逗号拼接的 ID 列表;关系是否有
role、joined_at、removed_at这样的生命周期字段已被讨论☐ 关键业务对象有状态流转/审计表,含操作人与
trace_id☐ 金额、时间的类型正确(DECIMAL、DATETIME 或整型时间戳,不用字符串、浮点)
☐ 预估了 1 年、3 年后的数据量,以及归档/清理方案
☐ 变更如何上线(在线 DDL、回滚)已有方案
除了清单,流程上更重要的一条是:建模在建表之前。我们现在要求 AI 在给出 DDL 之前,先输出“实体清单、关系清单、状态机、业务不变量”四样东西,由人确认后再生成 DDL。这四样东西本身就是后文“规格控制面”的一部分。
四、问题三:局部细节制造语义分叉——a_b 与 aB 的故事
现象
和“设计不足”相反,AI 还有一种同样普遍的毛病:在小处写得过多。我们反复看到:
一个实体里同时存在
user_name和userName,其中只有一个是真正被数据库和接口使用的,另一个只是“以防万一”;Entity、DTO、VO、BO、Query、Param 一套复制,字段完全一样,只是换了类名,中间一堆
BeanUtils.copyProperties或手写转换器;每个方法开头都是
if (x == null) { return null; },哪怕调用链上这个参数根本不可能为空;莫名其妙的 fallback 分支:主路径失败后静默走另一条路,掩盖了真实错误;
从没被读取的配置开关
enableNewLogic、compatMode,以及为“可能存在的旧版本”写的兼容 shim。
最典型的就是同一个业务概念同时出现 a_b 与 aB。表面上这是命名风格差异,实际上它带来了一整串问题。
专业定性
| 术语 | 含义 | 在 a_b / aB 里的体现 |
|---|---|---|
| Naming Inconsistency(命名不一致) | 同一概念的命名风格或词汇不统一 | 数据库列 user_name,Java 字段 userName,自己手写的 user_name 又混进了 Java 里 |
| Semantic Aliasing(语义别名) | 多个名字指向同一语义 | 两个字段其实是同一个东西的别名 |
| Conceptual Duplication(概念重复) | 同一个概念在模型里被表示了不止一次 | DTO、VO、BO 完全一样的字段重复声明 |
| Accidental Complexity(偶然复杂度) | 与业务本质无关的额外复杂度 | 需要写转换逻辑、判空逻辑、同步逻辑,而这些本不该存在 |
| Cognitive Load(认知负荷) | 读者为理解代码需要同时记住的信息量 | “哪个才是真的?是旧字段吗?” |
| Design Divergence(设计分叉) | 同一问题出现两种以上并行的解决路径 | 新旧两套命名同时被不同模块使用,越走越远 |
这种“代码上有多个名字、业务上只有一个概念”的现象,可以统称为 Semantic Duplication(语义重复)。
它的真正杀伤力在于:维护者必须不断判断——这两个名字是不是同一个概念?哪个是旧字段?它们之间有没有转换逻辑?改了一个,另一个要不要同步?这些问题没有一个能靠读代码本身得到权威答案,只能靠猜或者问人,而问不到人的时候,往往就是改出线上问题的时候。
一个 Java 例子:两套命名并存
// ❌ 过度设计:同一份数据两套字段,以及一个“兜底”的 getter
public class UserDTO {
    private String user_name;   // 数据库/JSON 下划线风格
    private String userName;    // Java 驼峰风格
    // ... 两套 getter/setter

    public String getDisplayName() {
        if (userName != null && !userName.isEmpty()) {
            return userName;
        }
        if (user_name != null && !user_name.isEmpty()) {
            return user_name;
        }
        return "";   // 兜底:调用方永远不知道数据其实缺失了
    }
}

// Mapper 里两边都赋值,“以防万一”
dto.setUserName(entity.getUserName());
dto.setUser_name(entity.getUserName());
面对这段代码,后来的维护者会陷入一堆无法回答的问题:哪个字段才是真的?前端读的是哪个?改名时要不要两个都改?空字符串是合法值还是缺失?
// ✅ 只保留一个真实字段;外部协议命名用注解明确声明,转换由框架统一负责
public class UserDTO {
    @JsonProperty("user_name")   // 对外 JSON 使用下划线,Java 内部统一驼峰
    private String userName;
    // getter/setter 由 Lombok 或 record 生成
}
如果确实有“旧客户端仍在发 userName”这样的兼容需求,正确的做法是显式、有边界、有期限:
public record UserDTO(
    @JsonProperty("user_name")
    @JsonAlias("userName")   // TODO(2026-12-31): 旧客户端全部升级后删除
    String userName
) {}
注意区别:前一个例子是在核心模型内部默默并存两个名字,没人知道何时删;后一个例子的兼容只存在于边界转换层,有明确的存在理由和删除条件。这条分界线,就是下面“领域命名词典”要守护的。
形成机制
1. 适配已有局部风格。 AI 倾向于贴合它在上下文里看到的写法。如果前一个文件是下划线、后一个文件是驼峰,它就会顺着各自的局部风格写,最终在同一个对象里留下两套。
2. 为保护调用方而新增别名,而不是统一模型。 当需求不明确时,模型倾向于“都支持一下”,这样无论你实际想要哪种都不算错。人类会去问“到底是哪个”,模型的默认路径是生成一个覆盖所有可能性的答案。统一模型需要决策和删除旧名,新增别名则无需决策,所以后者在“不出错”的目标下赢了。
3. 过早预判未来兼容需求,即 Premature Generalization(过早泛化)。 为“可能存在的旧版本”“将来可能的新渠道”预先写好兼容层和抽象,而这些假想的未来大多不会到来,或者到来时的样子完全不同。
4. 成本外部化。 多写的每一行代码都是人类维护者未来要读、要测、要改的成本,模型不承担这个成本,也没有“两年后我还得维护它”的激励。成本外部化是过度设计的经济学根源。
5. 偏好训练对“看起来周全”的奖励。 评审者(人或评分模型)往往觉得有判空、有兜底、有兼容、有分层的代码更专业、更健壮。克制的收益(未来维护成本更低)在当次回答里无法体现,难以被奖励。同时,许多评测里更长、更详细的回答容易获得好评,这种长度偏好会迁移到代码里,表现为多余的抽象、注释和分支。
6. 缺少全局视图,不知道什么是死代码。 模型不知道这个字段前端到底读没读,这个配置线上有没有人在用,所以它不敢删,也不敢少写。没有调用关系和运行数据,就无从判断“不需要”。兜底分支从不会在测试里报错,相反还会让测试更容易通过,没有人告诉模型“这个分支线上从来没走过”。
典型后果
认知负荷升高:阅读者要同时记住两套命名、四层对象、若干开关的含义;
霰弹式修改(shotgun surgery):加一个字段要改 Entity、DTO、VO、Mapper、转换器、文档六个地方,漏一处就是 Bug;
静默失败:兜底分支把本该暴露的错误吞掉,问题被推迟到更难排查的位置;
测试面积膨胀:每个分支理论上都需要覆盖,否则就是未测试的代码;
设计分叉扩散:新来的人(或新一轮 AI 会话)看到两套命名,就会再复制一套,复杂度自我繁殖。
控制方法:领域命名词典与复杂度问责
核心原则:建立领域命名词典。核心模型中,一个概念只允许保留一个规范名称;边界转换可以存在,但必须明确范围、兼容期限和删除条件。 词典可以是一张很朴素的表:
| 业务概念 | 规范名称(核心模型) | 数据库列 | 对外 JSON | 禁止出现的别名 | 备注 |
|---|---|---|---|---|---|
| 用户昵称 | nickname |
nickname |
nickname |
nick、userName、user_name、displayName |
displayName 仅用于展示层拼装,不是持久化字段 |
| 订单号 | orderNo |
order_no |
order_no |
orderId、orderCode |
orderId 专指数据库自增主键 |
| 项目成员关系 | ProjectMember |
project_member |
members[] |
memberIds、memberList |
以关联表为准 |
| 加入时间 | joinedAt |
joined_at |
joined_at |
joinTime、addTime、createTime |
createTime 在本项目只表示记录创建时间 |
有了这张表,AI 的每次修改都应当回答一组固定问题:
是否新增了同义字段、别名或兼容层?
如果新增,它位于核心模型还是边界层?
兼容到什么时候?删除的条件是什么?由谁负责?
有没有对应的测试,保证删除后能被发现?
除此之外还有这些实用手段:
用工具兜底:Checkstyle / PMD / SpotBugs / Error Prone、SonarQube 的重复代码与未使用代码规则,IDE 的 unused 检查,以及 ArchUnit 约束分层(比如不允许出现
xxxVO)。死代码检测:静态分析加运行时数据,如覆盖率报告、Feature Flag 使用统计、访问日志;一个月内没被走过的分支,认真考虑删除。
提示词里明确“克制”:例如“不要添加未被需求提到的字段、配置项与兼容逻辑;参数的非空性由调用方与校验注解保证,不要重复判空;如果需要 fallback,先问我。”
审查三问:“这个字段谁在读?”“这个分支什么情况下触发?”“删掉它会让哪个测试失败?”回答不上来的就删。
边界严格,内部信任:在系统边界(Controller 入参、外部接口返回)做一次严格校验,内部代码信任已校验的数据,而不是处处防御。这也是区分“防御性编程”与“过度设计”的界线。
删除优先:把 AI 给的每个 PR 当成“候选集”,审查的任务是做减法。我们甚至专门让 AI 做一轮“只删不加”的重构,并要求它对每处删除给出依据。
五、问题四:日志追溯困难——可观测性缺口与因果链断裂
现象
这类问题往往在线上出事时才暴露:
调用链很长(网关 → 订单 → 库存 → 支付 → MQ → 通知),偏偏没有一个能串起全链路的 trace id / correlation id;
日志里只有“处理失败”,没有订单号、用户 ID 等关键业务标识;
catch (Exception e) {},或者只e.printStackTrace(),或者只记录e.getMessage()而丢掉堆栈与原因链;日志级别用错:正常流程用
ERROR,真正的故障用INFO;或者为了“调试”到处System.out.println;日志是随手拼接的长句,无法检索与聚合;
在异步任务、MQ 消费、跨服务调用处,没有入口/出口/分支日志,线程切换后 MDC 上下文丢失。
我们的真实感受是:越是“危险”的链路(涉及钱、库存、状态变更),越是链条长,越是出了问题最难查。它们恰恰是最需要日志的地方。
专业定性
现代请求通常经过前端、API Gateway、服务、消息队列、Worker、数据库、第三方服务以及各种回调。如果每一层只记录“开始”“成功”“失败”,日志就只是互不相关的孤立事件,无法重建事件之间的关系。对应的专业术语是:
| 术语 | 含义 | 典型表现 |
|---|---|---|
| Observability Gap(可观测性缺口) | 系统的内部状态无法通过外部输出(日志、指标、链路)推断 | 看到了“支付失败”,却不知道是超时、风控拒绝还是参数错误 |
| Traceability Failure(可追溯性失败) | 无法从结果倒查到引发它的原因与操作者 | 订单被取消了,不知道是用户、客服还是定时任务干的 |
| Causal Chain Break(因果链断裂) | 事件之间的“因为-所以”关系丢失 | 网关日志和订单日志各自完整,但没有字段能把两者连起来 |
| Distributed Context Propagation Failure(分布式上下文传播失败) | 上下文(trace id 等)在跨线程、跨服务、跨消息时丢失 | 线程池里的日志没有 traceId,MQ 消费端是一条全新的链路 |
| Correlation ID Missing(关联 ID 缺失) | 没有能贯穿多个系统的统一标识 | 只能靠“时间相近 + 用户相同”去猜测关联 |
| Opaque Boundary(黑盒边界) | 对某个边界(第三方、网关、异步队列)内部发生了什么毫不知情 | 调用第三方支付后没有记录请求耗时、返回码和对方的流水号 |
形成机制
1. 局部视图生成。 模型每次只在一个方法、一个类里工作,写出的日志也只对这个方法有意义。日志的价值在于跨越边界的串联,而边界恰恰是局部视图看不到的。
2. 训练样本里缺少可观测性思维。 教程和示例里,日志要么没有,要么就是一句 log.info("start")。真正的生产日志规范(字段约定、采样、脱敏、链路传播)存在于公司内部文档与运维经验里,公开语料中较少。
3. 快乐路径偏差。 训练样本多是“正常情况”的演示,异常分支被省略或写得潦草。于是模型最擅长写“成功怎样”,对“失败时需要留下什么线索”并不敏感。
4. 把日志当噪音。 在“简洁、干净”的偏好下,日志常被视为影响可读性的杂项,尤其在被要求“精简代码”时,它们是最先被删的东西。
5. 不了解运行时拓扑。 模型不知道系统有几个服务、用 Kafka 还是 RocketMQ、网关有没有注入 trace id、日志被谁采集。没有拓扑,就不知道哪里是边界,也就不知道该在哪里打点。
6. 缺失 MDC 等基础设施意识。 线程池、CompletableFuture、响应式调用、MQ 消费都会让线程局部变量(ThreadLocal,MDC 的底层实现)无法自动传递。这需要“知道系统怎么运行”才会想到。
7. 只生成输出文本,没有设计端到端的因果链。 这是最本质的一点。日志在 AI 眼里是“一行要输出的文字”,但在工程里它是“因果链上的一个节点”。节点之间靠什么字段连接,不是在写某一行日志时能想清楚的,必须在设计阶段就定好。
trace id 跨线程与 MQ 传播,让因果链不断
最小字段集:让每一行日志都能接上链
要形成可追溯链路,团队需要一套统一的字段约定。下表是我们整理的最小字段集(命名以 snake_case 为例,你的团队可以按词典调整,但必须统一):
| 类别 | 字段 | 说明 |
|---|---|---|
| 上下文 | timestamp、service、environment |
何时、哪个服务、哪个环境(test/staging/prod) |
| 上下文 | trace_id、span_id、parent_span_id、request_id |
一次完整链路的标识;链路中每一段的标识及其父节点;单个入口请求的标识 |
| 业务主体 | user_id、session_id、business_id |
谁、哪次会话、哪个业务对象(订单号、工单号等) |
| 业务主体 | event_name、operation |
发生了什么事件或执行了什么操作 |
| 状态与结果 | state_before、state_after |
状态迁移前后值,状态变更必须成对记录 |
| 状态与结果 | result、error_code、retry_count |
成功/失败,标准化错误码,第几次重试 |
| 依赖与性能 | dependency、latency_ms |
调用了哪个下游,耗时多少 |
| 异步链路 | causation_id、message_id |
是哪条消息/事件“导致”了当前处理;当前消息自身的标识 |
几个容易被忽略的细节:
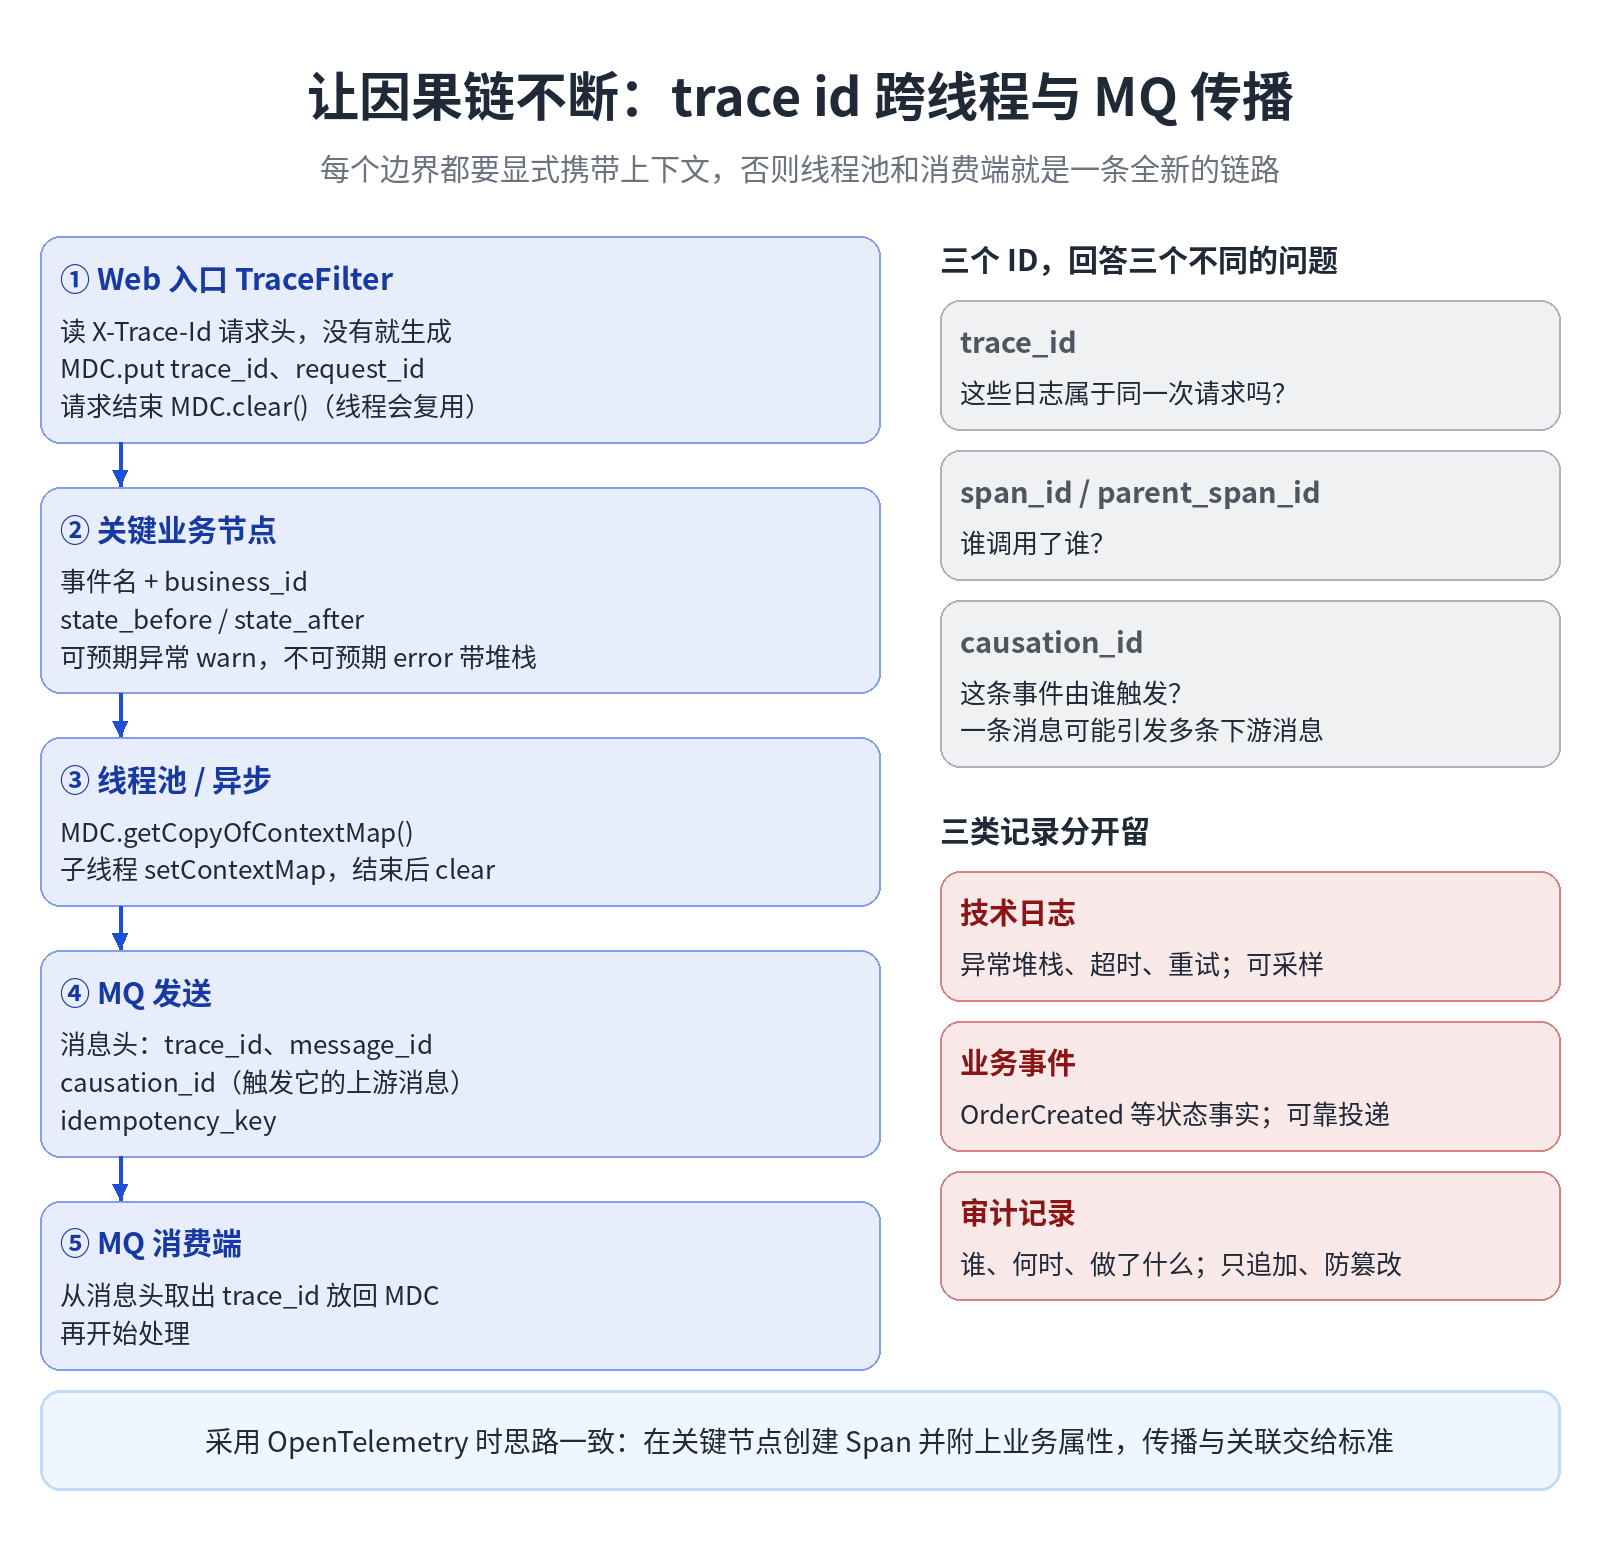
trace_id回答“这些日志属于同一次请求吗”,span_id/parent_span_id回答“谁调用了谁”,causation_id回答“这条事件由谁触发”。三者并不重复,异步链路里尤其需要causation_id,因为一条消息可能引发多条下游消息,仅靠trace_id无法还原因果顺序。state_before / state_after是把“时间维度建模”落到日志上的字段,它与前面数据库的order_status_log表是一回事的两种存储。error_code必须是稳定、可枚举的值,不要把异常消息当作错误码,否则无法聚合告警。retry_count与幂等键配合,才能判断“这是第一次失败还是第五次重复”。
三类记录:技术日志、业务事件、审计记录
同一个请求里,要同时留下三种性质不同的记录,把它们混在一起,往往三种用途都做不好:
| 记录类型 | 回答的问题 | 内容举例 | 保留与访问特点 |
|---|---|---|---|
| 技术日志 | 系统哪里出了问题? | 异常堆栈、超时、依赖失败、重试、降级触发 | 量大,可采样(错误日志不采样),保留期较短,开发/运维可检索 |
| 业务事件 | 业务上发生了什么状态事实? | OrderCreated、PaymentSucceeded、OrderCancelled,带 business_id 和状态迁移 |
需要可靠投递,可用于对账、统计、驱动下游,保留期较长 |
| 审计记录 | 谁在何时以何种来源做了什么?前后状态是什么? | 操作人、来源 IP/系统、操作类型、操作前后状态、理由 | 只追加、防篡改,保留期按合规要求,访问需要授权 |
三者结合才能完成真正的诊断与审计。举个例子,用户反馈“钱扣了,订单却是待支付”。技术日志告诉你支付回调超时过一次并重试;业务事件告诉你 PaymentSucceeded 事件确实发生了,但 OrderPaid 没有;审计记录告诉你没有人为介入。三条证据对齐,就能判断问题出在回调处理的幂等逻辑上。
一个 Java 例子:入口注入 trace id,跨线程与 MQ 传播
// 1) Web 入口:接收或生成 traceId,放进 MDC,请求结束清理
@Component
public class TraceFilter extends OncePerRequestFilter {
    @Override
    protected void doFilterInternal(HttpServletRequest req, HttpServletResponse resp,
                                    FilterChain chain) throws ServletException, IOException {
        String traceId = Optional.ofNullable(req.getHeader("X-Trace-Id"))
                                 .filter(s -> !s.isBlank())
                                 .orElseGet(() -> UUID.randomUUID().toString().replace("-", ""));
        MDC.put("trace_id", traceId);
        MDC.put("request_id", UUID.randomUUID().toString().replace("-", ""));
        resp.setHeader("X-Trace-Id", traceId);
        try {
            chain.doFilter(req, resp);
        } finally {
            MDC.clear();   // 线程会被复用,必须清理,否则会串号
        }
    }
}
// 2) 关键业务节点:事件名 + 业务标识 + 状态迁移 + 保留异常原因链
public void pay(String orderNo, long userId) {
    log.info("event=pay.start business_id={} user_id={} state_before=UNPAID", orderNo, userId);
    try {
        PayResult r = payClient.pay(orderNo);
        log.info("event=pay.done business_id={} dependency=pay-channel channel_txn_id={} latency_ms={} state_after=PAID",
                 orderNo, r.txnId(), r.costMs());
    } catch (PayTimeoutException e) {
        // 可预期的异常:warn,并明确后续动作(重试/补偿)
        log.warn("event=pay.timeout business_id={} error_code=PAY_TIMEOUT retry_count={} will_retry=true",
                 orderNo, currentRetry(orderNo), e);
        throw e;
    } catch (Exception e) {
        // 不可预期:error,带堆栈;不吞、不改写成“处理失败”
        log.error("event=pay.error business_id={} user_id={} error_code=PAY_FAILED", orderNo, userId, e);
        throw new BizException("PAY_FAILED", e);
    }
}
// 3) 线程池 / MQ:跨线程需要显式传递上下文
Map<String, String> ctx = MDC.getCopyOfContextMap();
executor.submit(() -> {
    if (ctx != null) MDC.setContextMap(ctx);
    try {
        doWork();
    } finally {
        MDC.clear();
    }
});

// MQ 发送:把 trace_id 放进消息头;causation_id 指向触发它的上游消息
Message<OrderEvent> msg = MessageBuilder.withPayload(event)
        .setHeader("trace_id", MDC.get("trace_id"))
        .setHeader("message_id", UUID.randomUUID().toString())
        .setHeader("causation_id", currentMessageId())   // 当前正在处理的消息ID,无则为空
        .setHeader("idempotency_key", event.getOrderNo() + ":" + event.getType())
        .build();
// 消费端:从消息头取出 trace_id 放回 MDC,再开始处理
如果采用 OpenTelemetry,思路一致,只是传播与关联交给标准去做:
// OpenTelemetry 风格:在关键节点创建 Span,并附上业务属性
Span span = tracer.spanBuilder("order.pay").startSpan();
try (Scope scope = span.makeCurrent()) {
    span.setAttribute("order.no", orderNo);
    span.setAttribute("user.id", userId);
    doPay();
} catch (Exception e) {
    span.recordException(e);
    span.setStatus(StatusCode.ERROR);
    throw e;
} finally {
    span.end();
}
// 使用 OpenTelemetry 的 Java Agent 与日志框架集成时,通常可以自动把 trace_id / span_id
// 写入 MDC,使日志与链路互相跳转(具体字段名与配置以你使用的版本文档为准)。
日志输出建议使用 JSON 等结构化格式,一行日志就是一个可检索的“记录”:
{"timestamp":"2026-09-30T15:20:11.532+08:00","level":"ERROR","service":"order-service",
 "environment":"prod","trace_id":"4bf92f3577b34da6a3ce929d0e0e4736",
 "span_id":"00f067aa0ba902b7","parent_span_id":"a2fb4a1d1a96d312",
 "event_name":"pay.error","operation":"pay","business_id":"O2026093000001","user_id":10086,
 "state_before":"UNPAID","state_after":"UNPAID","result":"FAILED",
 "error_code":"PAY_TIMEOUT","retry_count":2,"dependency":"pay-channel","latency_ms":3012,
 "message_id":"m-7788","causation_id":"m-7766","msg":"channel timeout"}
典型后果
线上故障的平均定位时间变长,工程师只能凭经验猜,反复加日志、发版、复现;
多个团队互相甩锅:每一方的日志都“看起来没问题”,因为没人能证明另一方的行为;
资金、库存类问题无法对账,也无法回答“这次变更是谁、通过什么入口做的”;
诊断债务逐步累积,直到某一次大故障把它一次性清算。
控制方法:可追溯性检查清单
☐ 边界必打点:HTTP/
RPC 入口与出口、MQ 生产与消费、定时任务、异步线程入口与出口,都有日志 ☐ trace id / correlation id 全链路传播:网关生成或透传,服务间通过 Header / 消息头传递,线程切换时显式携带
☐ 关键业务标识入日志:订单号、用户 ID、租户 ID、外部流水号,而不是“处理失败”
☐ 幂等键与重试次数:消息消费、回调、补偿任务,记录 idempotency key 与 retry 次数
☐ 分支可见:重要的分支决策(走了哪个渠道、命中了哪条规则、为什么降级)留一条日志
☐ 异常不吞:要么向上抛,要么记录(带堆栈、原因链、业务标识),避免同一异常层层重复打印
☐ 级别恰当:ERROR 代表需要人介入;WARN 代表可恢复的异常;INFO 记录关键业务事件;DEBUG 用于排查,默认关闭
☐ 结构化字段:统一字段名,便于检索与聚合
☐ 采样与限流:高频路径的日志需要采样或限流,但错误日志不应被采样丢弃
☐ 敏感信息脱敏:手机号、证件号、密钥、令牌不得明文进入日志
☐ 三类记录各有归属:技术日志、业务事件、审计记录不混用同一张“日志大杂烩”
☐ 指标与链路配合:日志之外配合指标(耗时、错误率)与分布式追踪
六、四类问题的统一根因
把四类问题并排放在一起,会发现它们的“深层原因”其实指向同一个结构性缺口:
| 现象 | 深层原因 |
|---|---|
| 错误反复出现(思维惯性) | 缺少外部权威规格,AI 只有临时上下文 |
| 数据库设计糟糕 | 没有先定义领域对象、状态机和业务不变量 |
| 细节过度设计 | 模型追求局部完整性,缺少复杂度预算 |
| 日志难以追溯 | 只生成输出文本,没有设计端到端因果链 |
再展开一层,用更直白的话说:
第一行说的是 “记不住”:约束没有放在一个模型每次都能看到的地方;
第二行说的是 “没想清楚就动手”:跳过了建模,直接产出实现;
第三行说的是 “不知道该停”:没有一个量化的上限告诉它,到这里就够了;
第四行说的是 “看不到全局”:只管一行日志写得是否通顺,不管它能否接到另一行上。
AI 的默认行为是扩大局部解空间,而工程的任务是不断收敛全局问题空间。 如果没有规格、边界和反馈闭环,AI 迭代得越快,系统混沌增长得越快。
这句话也解释了为什么“提示词写得再好”不够用:提示词是一次性的、局部的、会被稀释的;而规格、边界和反馈闭环是持久的、全局的、可以由机器执行的。要的不是一个更聪明的 prompt,而是一套工程体系。
七、四个工程控制面
我把对策归纳为四个控制面:规格控制面、变更控制面、复杂度控制面、观测控制面。它们分别对应四类问题的深层原因,彼此也有分工:规格管“做什么、约束是什么”,变更管“每次改了什么”,复杂度管“边界在哪里”,观测管“结果如何被证明”。
1. 规格控制面:给 AI 一个外部权威输入
规格控制面维护的是业务流程、状态机、领域词典、API 契约、数据库约束和不可变决策,它们构成 AI 的外部权威输入。关键词是“权威”:当 AI 的输出与规格冲突,以规格为准;当规格需要改,由人显式修改规格,而不是让代码悄悄偏离。
建议的目录与内容:
docs/spec/
├── 00-glossary.md        领域命名词典(见上文)
├── 10-flows/             业务流程与状态机(每个功能一份)
├── 20-api-contracts/     接口契约(OpenAPI / protobuf)
├── 30-data-model.md      实体、关系、约束、数据量预估
├── 40-decisions/         不可变决策记录(ADR)
└── 50-observability.md   日志字段、事件目录、错误码
一份功能规格模板,可以直接让 AI 在写代码前先填写、由人确认:
# 功能规格:<功能名>

## 1. 用户目标
- 谁使用 / 什么场景 / 理想体验:

## 2. 范围
- 目标:
- 非目标(明确不做什么):

## 3. 业务流程与状态机
| 当前状态 | 触发事件 | 前置条件 | 目标状态 | 副作用 | 异常终态 |
| --- | --- | --- | --- | --- | --- |
|  |  |  |  |  |  |

## 4. 业务不变量(任何时候必须成立)
- 例:同一订单最多一次有效支付;已取消订单不得再次进入支付流程。

## 5. 数据模型
- 实体与关系(含关系的生命周期字段):
- 唯一性约束 / 索引 / 数据量预估(1 年、3 年):
- 关键查询:

## 6. 接口契约
- 入参、出参、错误码(引用 20-api-contracts):

## 7. 命名(引用 glossary,新增词条需评审)

## 8. 可观测性
- 关键事件(业务事件名)、必须记录的日志字段、审计点:

## 9. 失败场景与回滚
- 外部依赖失败、重复提交、并发冲突、数据修复:

## 10. 待决问题(未决策的问题不得由实现自行填充)
最后一条尤其重要。AI 的默认行为是把“未决策的问题”当成实现细节自行填充,所以规格里要有“待决问题”这一栏:遇到规格没覆盖的情况,AI 的任务是提问或列出备选,而不是替人做决定。
2. 变更控制面:让每一次 AI 修改都可解释
变更控制面要求每次 AI 修改必须说明:修改了什么、为什么修改、影响哪些模块、是否改变数据模型、是否新增复杂度、如何回滚。这些信息可以固化成一个 AI 变更说明模板,放进 PR 描述里:
## AI 变更说明(PR 描述必填)

1. **改了什么**:(文件/模块/接口/表的清单,一句话概括)
2. **为什么改**:(对应哪条需求/缺陷;引用规格章节)
3. **影响范围**:
   - 受影响的 caller / consumer:
   - 受影响的状态与副作用(消息、缓存、定时任务):
   - 是否影响已有数据:
4. **数据模型变更**:(是否新增/修改表、字段、索引;是否需要迁移;是否可在线执行)
5. **新增复杂度**:
   - 新增的表 / 公共接口 / 抽象层 / 配置项 / 兼容逻辑数量:
   - 每一项的存在理由、失败模式、兼容期限与删除条件:
6. **命名**:是否新增词典外的名字或同义字段(是/否,若是请说明)
7. **可观测性**:新增或修改了哪些日志/事件/审计点
8. **验证**:新增的测试、手工验证步骤
9. **回滚方案**:(回退提交即可 / 需要数据修复脚本 / 需要灰度开关)
这份模板的价值,不在于多填几行字,而在于逼迫两件事发生:一是 AI(以及提交它的人)必须自己想清楚影响面,二是审查者拿到的是一份可对账的清单,而不是一堆“看起来合理”的 diff。比如第 3 条中的“影响闭包”:改了一个字段的类型,要检查所有 caller、consumer、状态和副作用。AI 很擅长按清单逐项排查,只是它不会主动要求自己这样做。
3. 复杂度控制面:给每一轮迭代设置预算
复杂度控制面的做法是为每一轮迭代设置复杂度预算,限制新增表、公共接口、抽象层、修改模块和兼容逻辑的数量。能复用、收敛或删除的,就不新增。预算的好处是把“要克制”这种模糊要求,变成可以检查的数字。下面是一份示例(数字只是示意,应按团队规模和系统阶段调整):
| 项目 | 单次迭代默认预算 | 超出时需要 |
|---|---|---|
| 新增数据库表 | ≤ 2 张 | 在规格中说明为何无法复用现有表,并由人评审 DDL |
| 新增公共接口(对外 API) | ≤ 3 个 | 契约评审,说明与既有接口的关系 |
| 新增抽象层 / 基类 / 接口 | 0(默认不允许) | 至少两个已存在的实现场景作为依据 |
| 修改的模块数 | ≤ 3 个 | 拆分为多次迭代,或先写影响分析 |
| 新增兼容逻辑(别名、旧格式适配) | 0;确需则必须带删除日期 | 在 PR 中写明边界层、期限、删除条件 |
| 新增配置开关 | ≤ 1 个,且必须有负责人和下线计划 | 说明开关默认值与灰度策略 |
| 新增第三方依赖 | 0(默认不允许) | 说明替代方案和维护成本 |
使用方式也很直接:在提示词里写明预算,让 AI 在方案阶段自己对照;超出预算的方案,必须先拿给人看。我们还会定期做“复杂度清理迭代”,目标是让总量下降:删别名、合并重复对象、下线过期开关。预算的真正意图,是让“删除”与“新增”在团队里拥有同等的地位。
4. 观测控制面:让成功可证明,让失败可追溯
观测控制面要求关键链路具备统一 trace_id、业务对象 ID、状态迁移记录、错误码、重试次数,以及上下游关联关系。落地的最低标准可以这样检查:
随便挑一个线上业务对象(一个订单号),能否在 5 分钟内串出它的全过程?
给定一个
trace_id,能否看到网关、各服务、MQ 消费和第三方调用的所有记录?一次状态变更,能否同时在技术日志、业务事件、审计记录里找到对应的条目?
一个异步失败,能否沿着
causation_id找到触发它的原始请求?
提示词里可以固定一段模板,让 AI 默认按规范打点(见后文“协作实践”)。同时,推荐把日志字段规范写入 docs/spec/50-observability.md,并配合工具类封装,让 AI 调用 EventLog.of("pay.done").business(orderNo).state("UNPAID","PAID").emit() 这类统一入口,而不是自己拼字符串。
八、四类问题放在一起:对照表
| 维度 | 思维惯性 | 数据库糟糕设计 | 过度设计(语义分叉) | 日志追溯困难 |
|---|---|---|---|---|
| 典型症状 | 已纠正的错误反复出现;跨会话重蹈覆辙;压缩后约束丢失 | 超长键、LONGTEXT、先查后插、逗号拼接 ID、缺审计/关联表 | a_b 与 aB 并存,层层 DTO,到处判空与兜底 |
无 trace id、无业务标识、吞异常、级别混乱 |
| 专业定性 | Specification Gap、Boundary Ambiguity、State-Machine Omission、Invariant Drift | Domain/Temporal/Relationship Lifecycle Modeling Failure、Referential Integrity Loss | Naming Inconsistency、Semantic Aliasing/Duplication、Accidental Complexity、Premature Generalization | Observability Gap、Traceability Failure、Causal Chain Break、Correlation ID Missing、Opaque Boundary |
| 技术成因 | 自回归自洽、上下文污染、注意力稀释、近因偏差、无状态、摘要有损 | 教程语料偏斜、局部最优、缺数据量与查询模式、跳过建模 | 对冲、成本外部化、长度偏好、缺少调用关系 | 局部视图、快乐路径偏差、不了解拓扑、忽视 MDC 传播 |
| 深层原因 | 缺少外部权威规格 | 未先定义领域对象、状态机、不变量 | 缺少复杂度预算 | 没有设计端到端因果链 |
| 主要控制面 | 规格 + 变更 | 规格 + 变更 | 复杂度 + 变更 | 观测 + 规格 |
| 典型手段 | 规则文件、短会话、测试与 lint、审查 diff | 建模先行、人工评审 schema、EXPLAIN、唯一索引 | 命名词典、预算、死代码检测、删除优先 | 统一字段、边界打点、结构化日志、链路追踪 |
九、团队执行原则(七条)
原则很简单,难的是每次都做。我把每一条配上一个具体例子。
1. 先定义用户目标:谁使用、什么场景、理想体验是什么。 反例:对 AI 说“做一个导出功能”。AI 会选择同步导出 10 万行,页面直接超时。正例:先写“运营同学,每周对账时一次导出最多 50 万行,可以等待并通过站内信获取文件”,导出就自然设计成异步任务加下载链接。
2. 先定义业务不变量:什么必须成立,什么状态不可越过,什么结果才算真正成功。 例如“已发货的订单不能直接取消,只能走退货流程”“库存不能为负”。这些写在规格里,并转成唯一约束、检查约束或单元测试。AI 提出的每个方案,都要能回答它如何保证这些不变量。
3. 先定义契约,再生成实现。 流程、状态机、数据关系和接口字段先于代码。实践上可以先让 AI 产出 OpenAPI 草案、状态表和 ER 描述,由人修改定稿,再让它依据这些文档生成 Controller、Service 和 Mapper。
4. 小步迭代,并做影响闭包。 每轮只解决一个可验证的问题,并检查所有 caller、consumer、状态和副作用。比如把订单 status 从 TINYINT 扩充一个新取值,就要检查:有哪些 switch 没有处理新值?有没有报表按状态过滤?有没有下游消息依赖该值?让 AI 列出受影响清单,再逐项勾掉。
5. 反过度设计:不为假想的未来新增别名、兼容层、抽象和字段。 判断标准是“今天是否有明确的消费者”。没有消费者的字段不新增;只有一个实现的接口不抽象;确需兼容旧客户端的别名,只能放在边界层并写明删除日期。
6. 要求 AI 解释复杂度:明确新增的概念、失败模式、兼容期限与删除条件。 比如 AI 提出新增一个 OrderCacheManager,就让它回答:它缓存什么?何时失效?缓存与数据库不一致会怎样?如果没有它,会发生什么?回答不出来,或者答案是“以后可能用得上”,就不要引入。
7. 让成功可证明:技术层成功、业务层成功、审计层完成必须分别可观测。 例如“支付接口返回 200”是技术层成功;“订单状态变为已支付并发出 PaymentSucceeded 事件”是业务层成功;“有一条记录说明谁、何时、从哪个入口完成了该状态变更”是审计层完成。三层都能被查到,才叫真正完成。
十、怎么和 AI 编程工具协作:我们的日常实践
下面是目前在团队里的做法,并不高深,胜在稳定。
规格先行。 不直接说“帮我做一个订单模块”。先让 AI 按功能规格模板产出草案,人评审定稿后再让它写代码。设计阶段的一次修改,比实现阶段便宜得多。
规则文件与项目上下文。 把架构约定、命名规范、常见错误、禁止事项写成规则文件并持续维护。每次踩坑,多一条规则。这是把个人经验“资产化”的最便宜方式,也是对抗无状态的主要手段。
小步快跑,频繁提交。 每次只让它完成一个小而可验证的改动,跑通、审查、提交,再进入下一步。小步有两个好处:上下文短,惯性与污染小;人工修改可以通过提交固化为基线。
测试与检查先行。 把约束尽可能变成机器可执行的:单元测试、集成测试、lint、类型检查、ArchUnit、schema 迁移检查。AI 擅长“让红灯变绿”,那就先把红灯设计好。
数据库 schema 与迁移必须由人评审。 我们会把 DDL 与预期的 SQL、数据量一起交给 AI 做评审,但最终签字的是人。
在提示词里写明可观测性与克制要求。 固定一段模板:
实现时请遵守:
1. 所有入口、出口、MQ 生产与消费处记录日志,字段遵循 docs/spec/50-observability.md,
   至少包含 trace_id 与业务主键(business_id)、event_name、result
2. 禁止吞异常;catch 后必须记录日志(带堆栈)或抛出
3. 异步/线程池调用需要显式传递 MDC
4. 状态变更必须同时写 state_before / state_after,并写入状态流水表
5. 不要添加需求之外的字段、配置项与兼容逻辑;需要兜底请先说明理由
6. 提交时按《AI 变更说明》模板填写,并对照复杂度预算说明新增项
审查清单。 对 AI 生成的代码,额外加一份清单:
☐ 有没有新增未被使用的字段、配置、方法?
☐ 有没有把已确认过的约定又改回去?(对照规则文件与 diff)
☐ DDL 是否经过评审?有没有超长键、大字段、缺失的唯一约束?
☐ 是否出现词典之外的同义名字?
☐ 异常是否被吞?日志是否包含 trace id 与业务标识?
☐ 每个兜底分支是否有明确的存在理由?
☐ 是否引入了不必要的新依赖?
把 AI 当作“很快、很勤奋、没有经验的同事”。 它写得快、读得多、不会累,但没见过你们的线上事故,也不知道下游有谁。给这样的同事布置任务,你会说明背景、给出约束、审查结果、把踩过的坑写进文档。对 AI 也一样。
十一、常见问题(FAQ)
Q1:这些问题会随着模型变强而消失吗?部分会缓解,比如长上下文、指令遵循、对代码库的检索与理解都在进步。但本文列出的多数问题,根源是信息不在上下文里(数据量、拓扑、历史决策)与反馈信号缺失,不是单靠模型变大就能解决的。我的判断是:模型会变好,但“人提供全局信息、设置反馈回路”的工作不会消失,只是形式会变。这是经验推断,并非定论。
Q2:规则文件写得越多越好吗?不是。规则文件本身也占用上下文,写得太长同样会被稀释。建议简短、具体、可判定,并定期清理过时条目;能用 lint 与测试强制的,就不要只靠文字。
Q3:既然要人评审 schema,那 AI 帮我建表还有意义吗?有。AI 很适合产出第一版草稿、补充注释、生成迁移脚本与测试数据。关键是提供足够的输入(数据量、查询、约束),并把输出视为“待评审的草案”。
Q4:日志这么重要,为什么不在框架层统一解决?应该在框架层解决一部分:统一的 Filter/拦截器、线程池装饰器、MQ 拦截器、OpenTelemetry Agent,都可以自动完成 trace id 的注入与传播。业务标识与关键分支日志则仍需业务代码来写。最好的方式是基础设施自动化,加上提示词与审查兜住业务打点。
Q5:过度设计和防御性编程的界线在哪里?看“边界”。在系统边界(外部输入、第三方响应)做严格校验是必要的;在内部已经校验过的数据流上重复判空、加兜底,就是过度。另一个判断标准是:这个防御分支能否用一个明确的场景与测试说明它存在的理由?说不出来就是多余的。
Q6:思维惯性能通过“换个模型”避免吗?不同模型表现确有差异,但机制层面的原因(上下文自洽、无状态、注意力分配)在类似架构上普遍存在。换模型可能减轻,很难根除。所以我更看重流程层面的对策,而不是押注某个模型。
Q7:小团队没精力做这么多治理,最低限度做什么?三件事:一个简短的规则文件,每次纠正后更新;schema 变更必须人工评审;关键链路统一 trace_id 与业务标识日志。如果还有余力,再加一张命名词典和一份 PR 的“AI 变更说明”模板。
Q8:关联表看起来比字符串字段麻烦,是不是过度设计?不是。判断标准是这个关系是否有独立的属性、生命周期或审计需求。如果成员只是一个永远不会变、无需查询的静态标签集合,用 JSON 列也可以接受;一旦出现“谁加入、何时、什么角色”或“某人参与了哪些项目”这样的问题,关联表就是必要的。过度设计指的是没有消费者的复杂度,而这里的复杂度是为真实需求服务的。
Q9:复杂度预算会不会限制创新、拖慢速度?预算是默认值,不是铁律。超出预算并不被禁止,只是要求把理由写清楚并经过评审。它限制的是“不知不觉的膨胀”,而不是“有意识的决策”。
十二、结语
回头看这四类问题,我们会发现它们不是四个孤立的“AI 缺陷”,而是同一件事在不同层次的体现:缺少让系统持续收敛的工程约束。AI 负责扩大实现速度,人类负责收敛问题边界、维护不变量、控制复杂度。
所以我在团队里反复强调一个边界:不要让 AI 同时决定“做什么、如何建模、如何兼容、何时算成功”。这些高影响的决策,必须由团队显式定义,写进规格、契约和词典里。AI 应该在稳定的边界内生成、修改和解释实现,而不是替代工程设计本身。
小结一下:
翻车不是随机的,而是可预测的模式:思维惯性、数据库设计糟糕、细节过度设计、日志难追溯;
用统一的框架看,它们分别对应规格缺口、建模失败、语义分叉与偶然复杂度、诊断债务;
对策是四个工程控制面:规格、变更、复杂度、观测,用模板、预算、字段规范和自动化检查把它们落到日常;
AI 放大你的产出,也会放大你没说清楚的部分。
如果只想从这篇文章里带走一件事,那就是:别指望它自己“懂”,把你踩过的坑变成规格、规则、测试和检查清单,让每一次生成都带着这些约束。
 2026-10-14鱼鱼